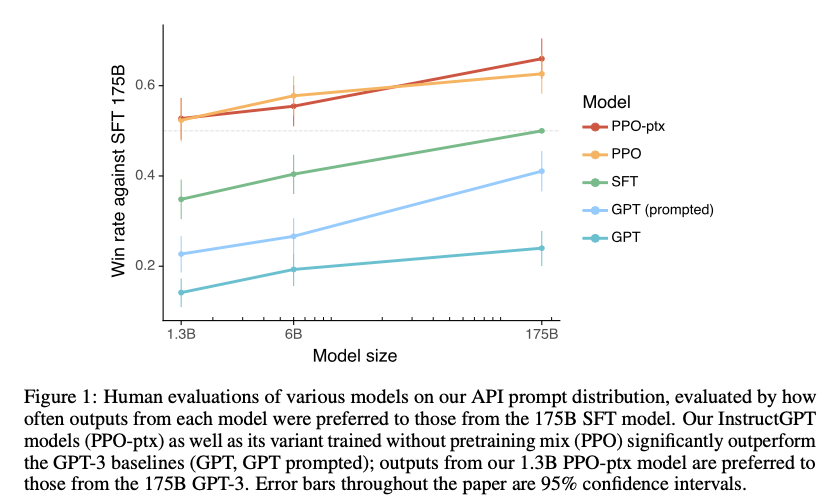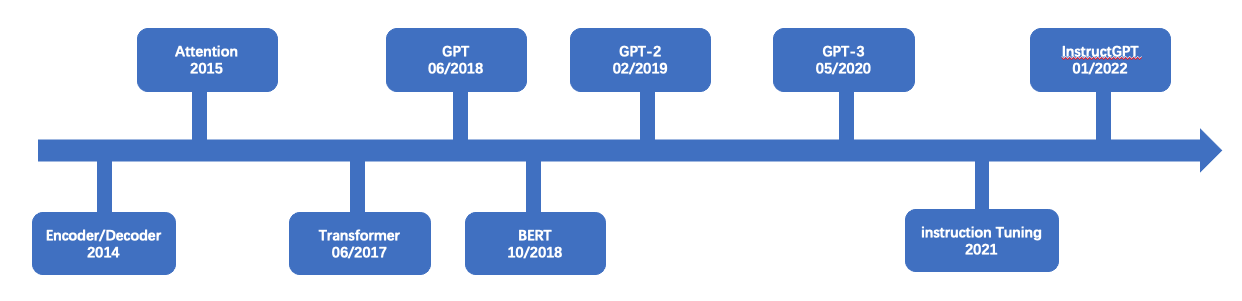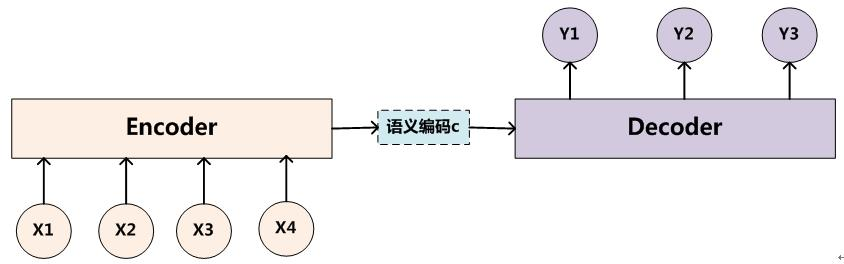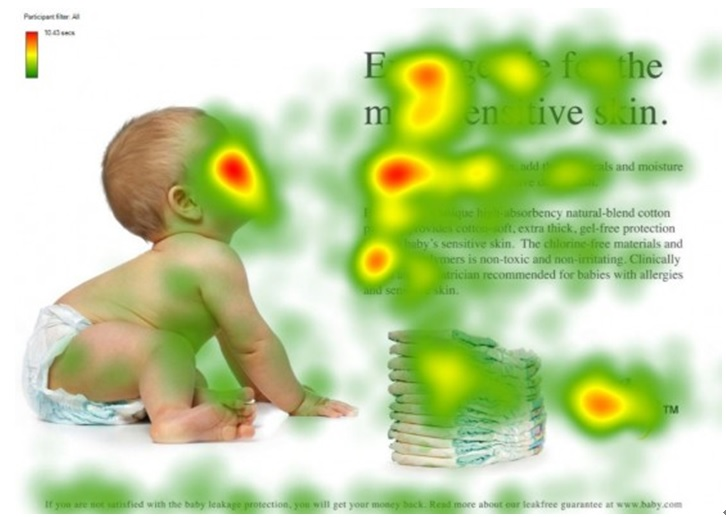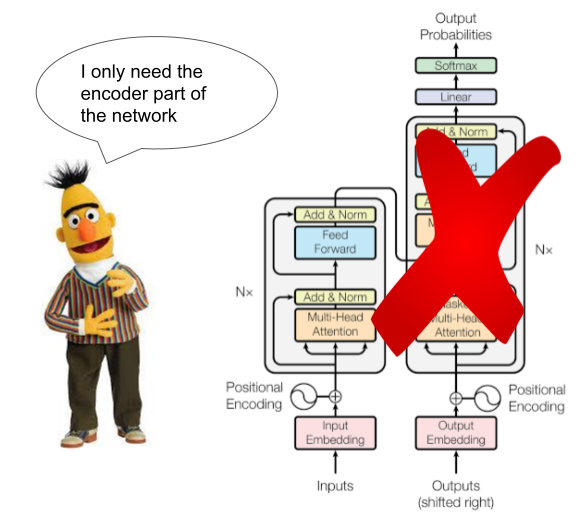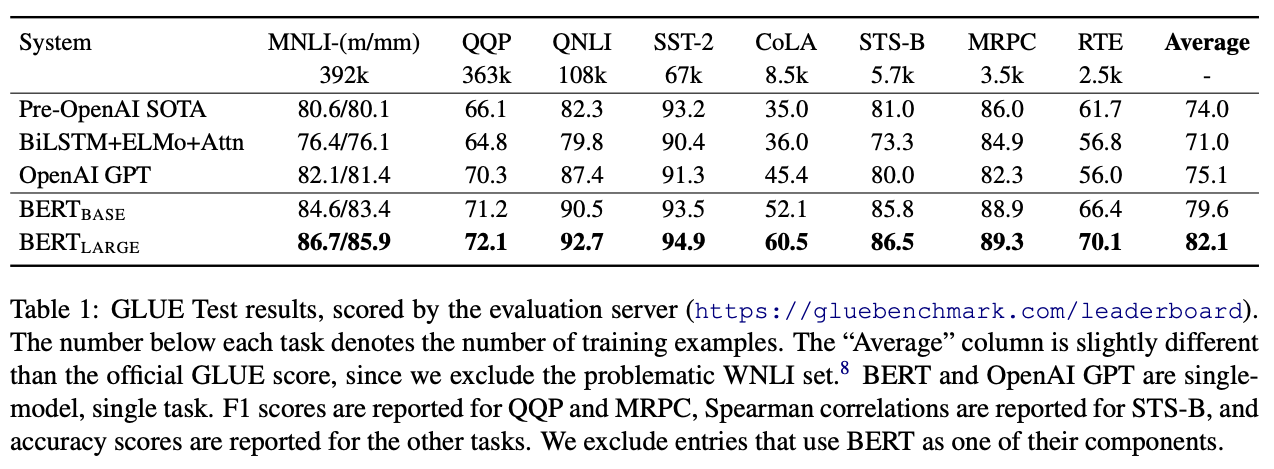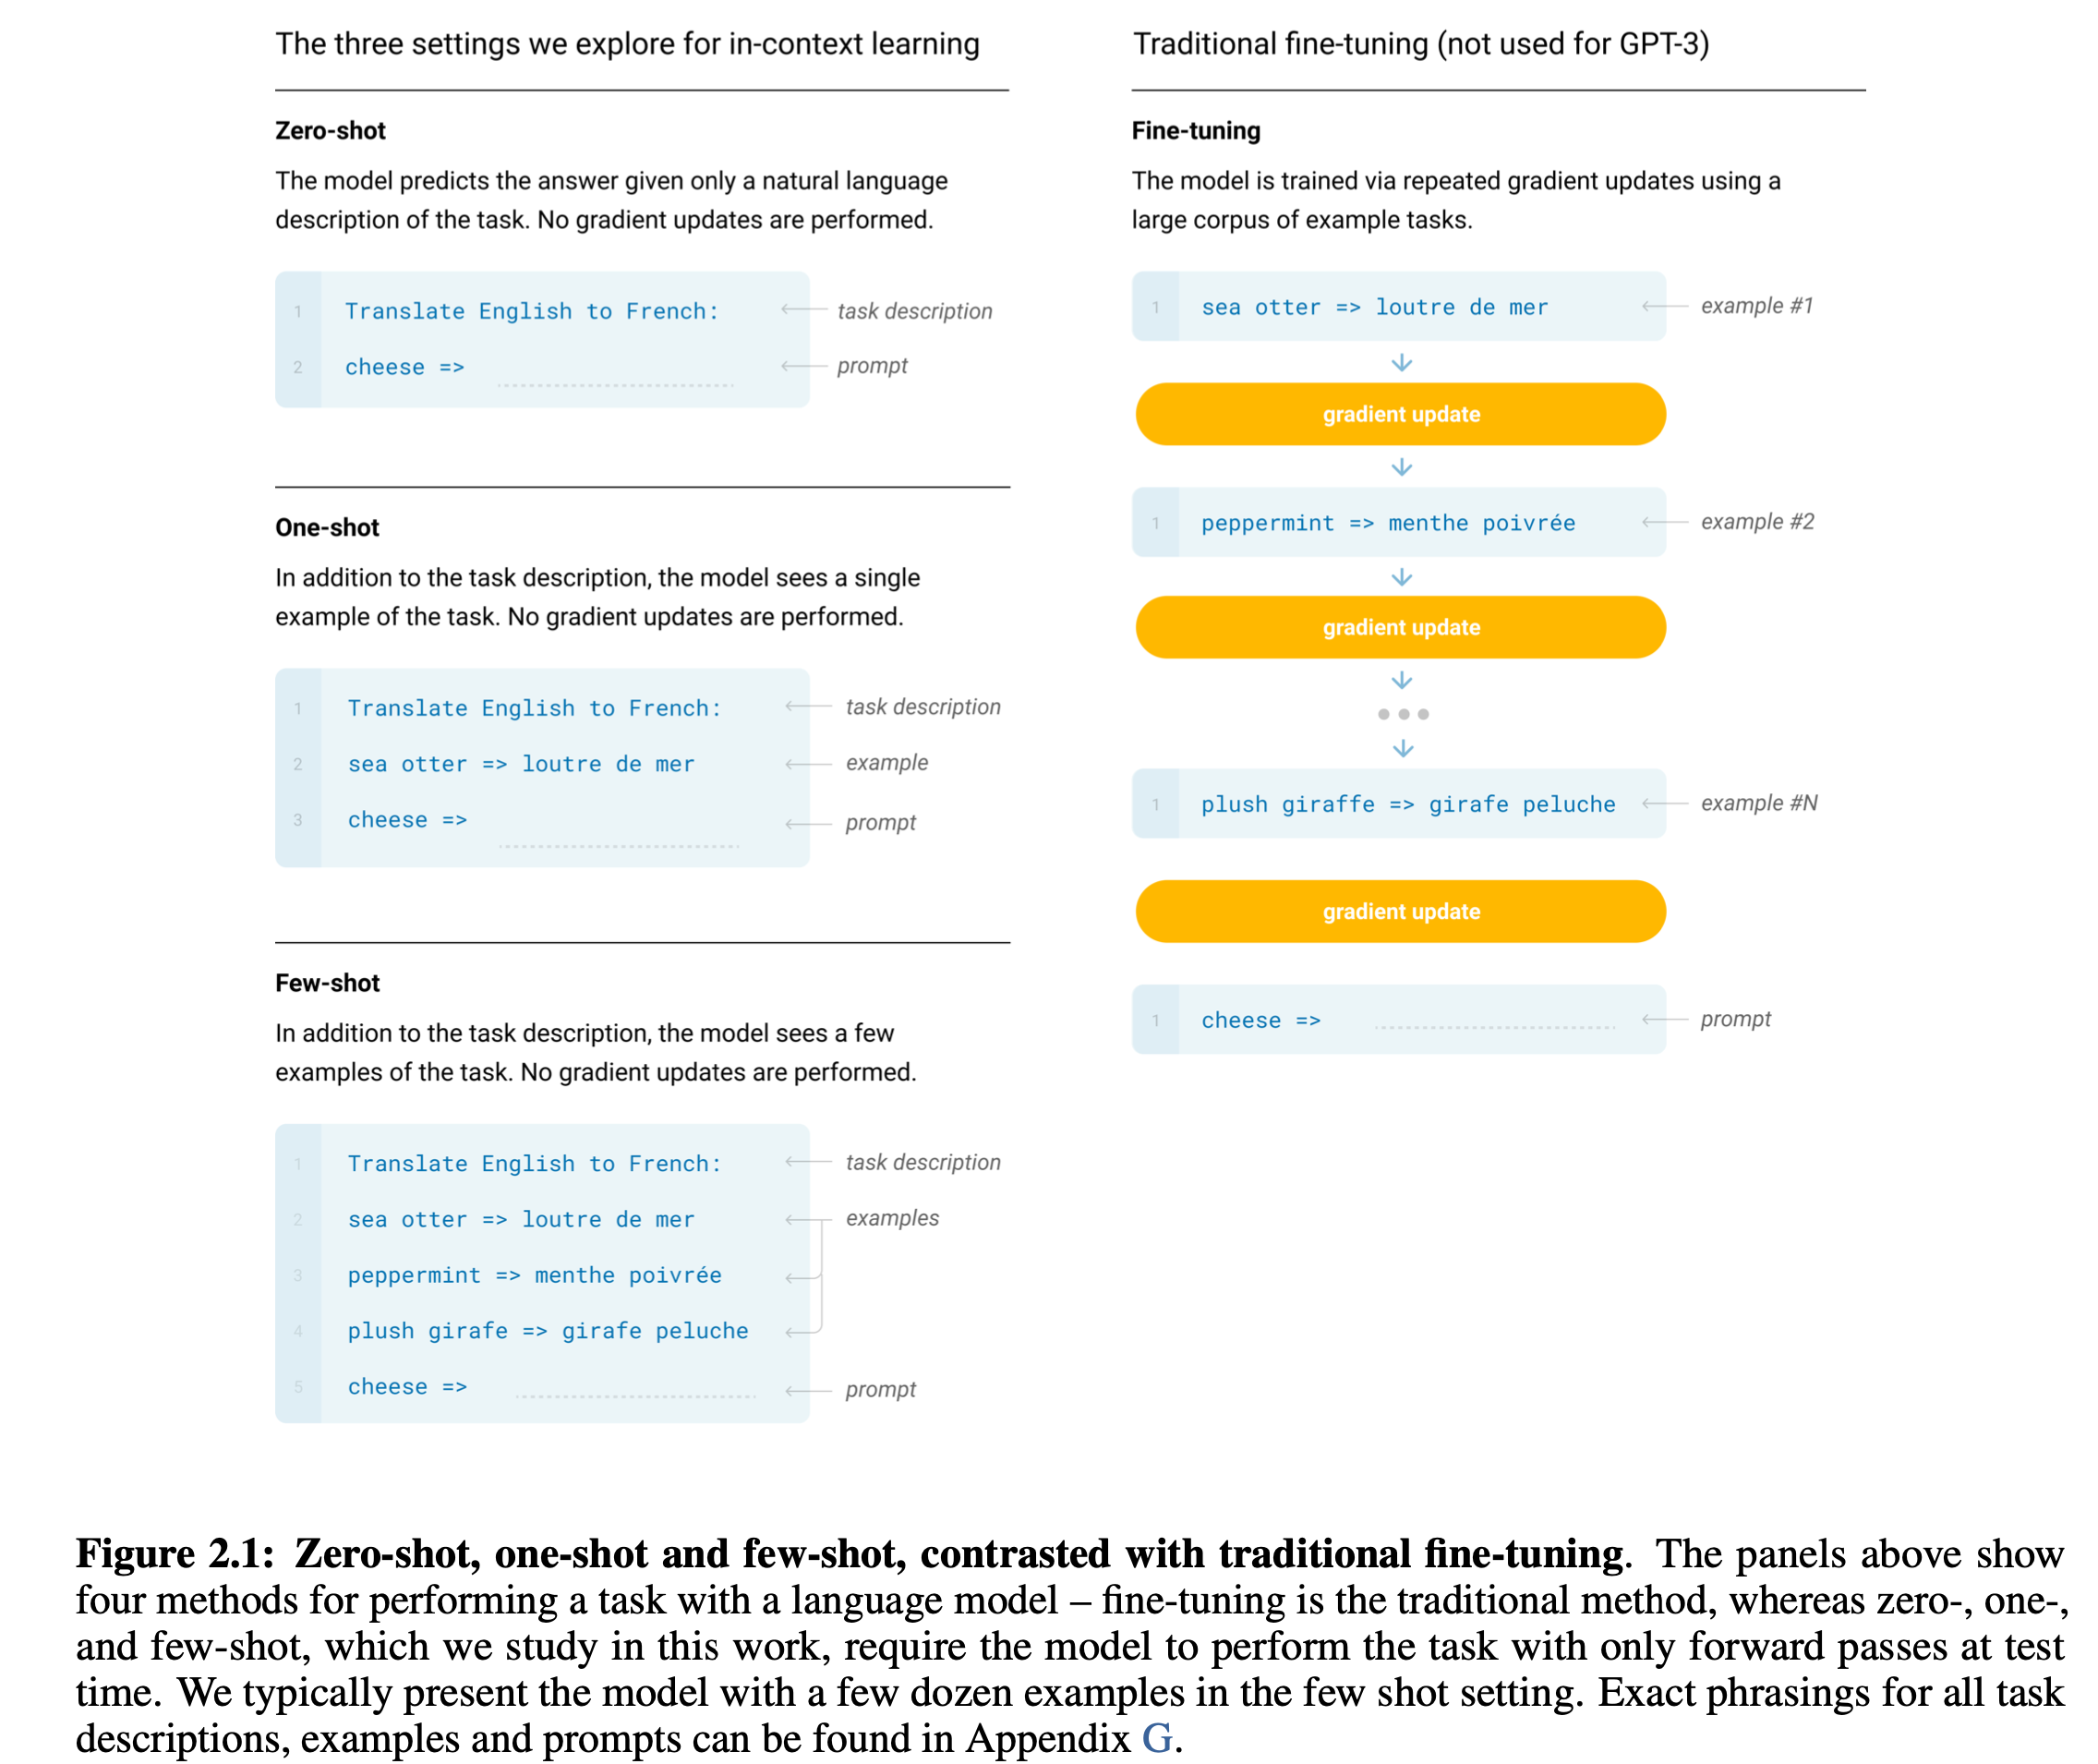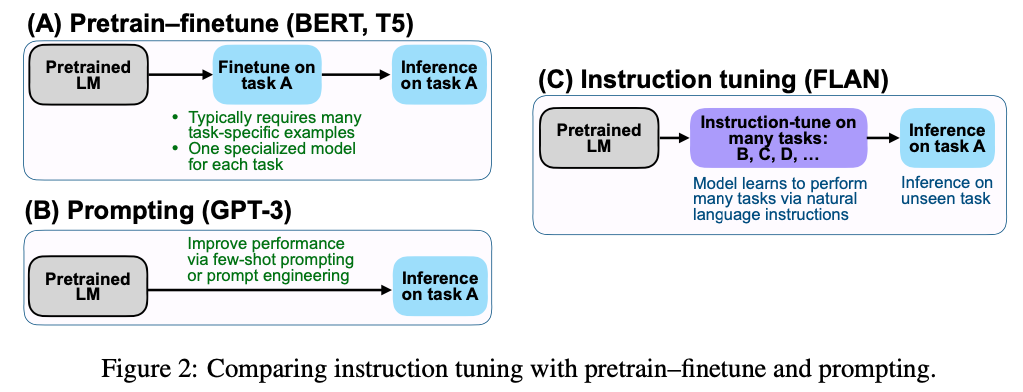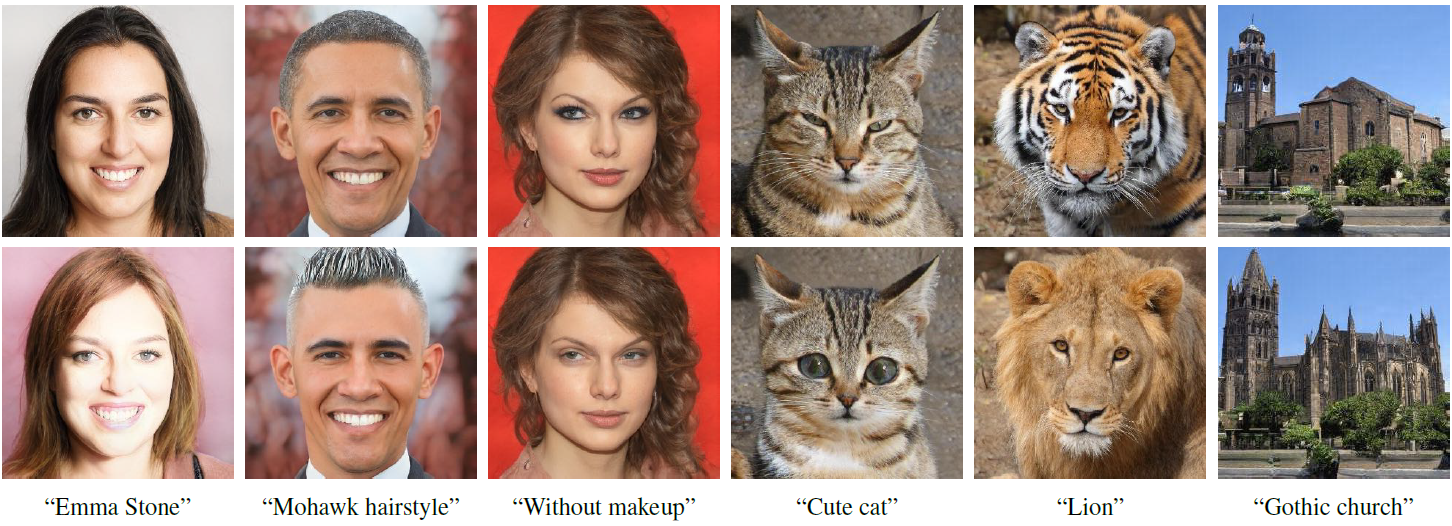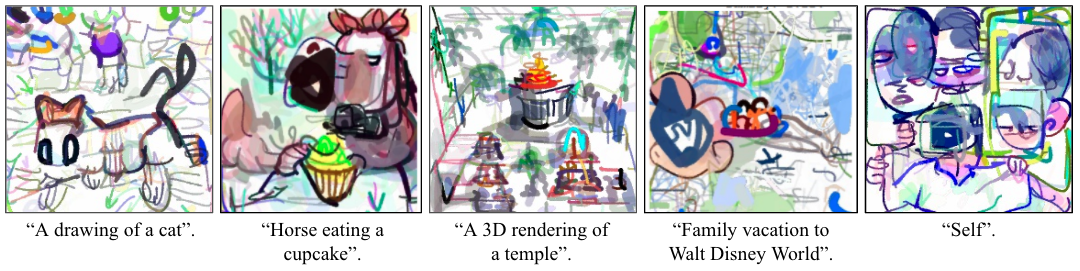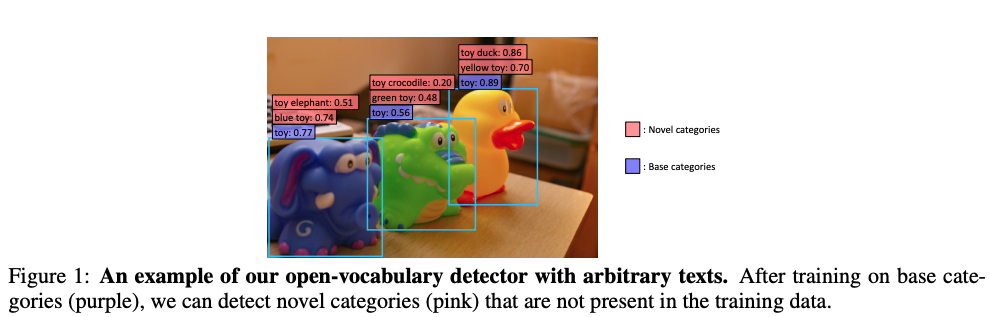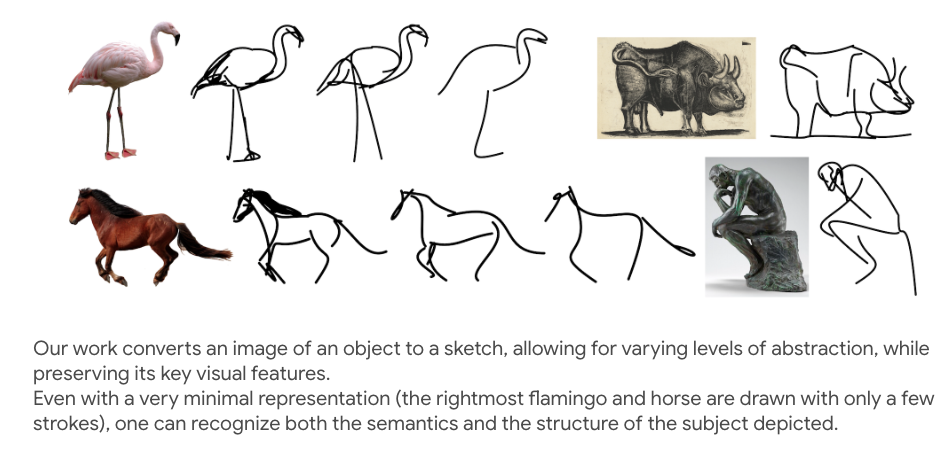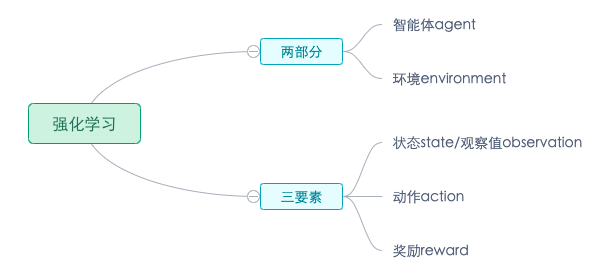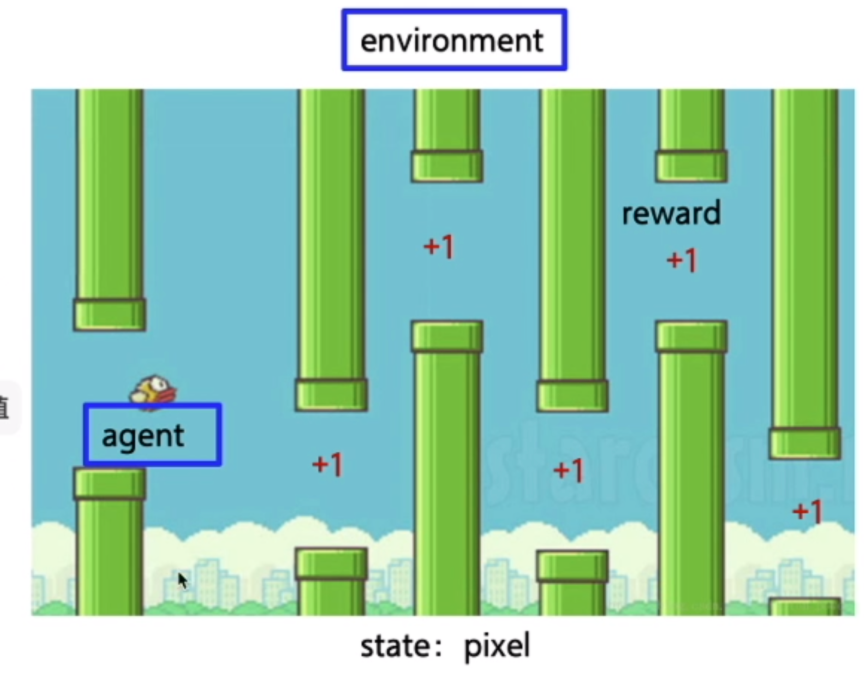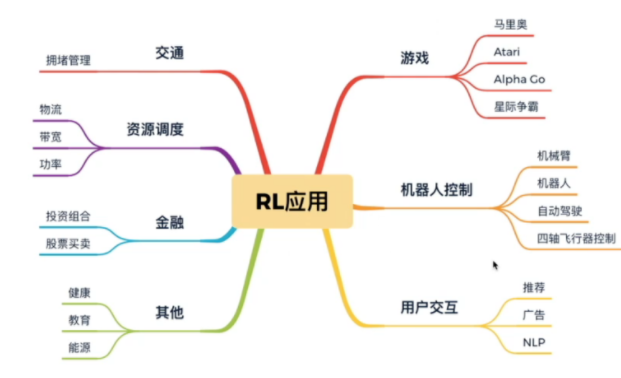
<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
  <author>
    <name>ZhangHao</name>
  </author>
  <generator uri="https://hexo.io/">Hexo</generator>
  <id>https://v2grad.com/</id>
  <link href="https://v2grad.com/" rel="alternate"/>
  <link href="https://v2grad.com/atom.xml" rel="self"/>
  <rights>All rights reserved 2026, ZhangHao</rights>
  <subtitle>张浩在路上</subtitle>
  <title>张浩在路上</title>
  <updated>2023-02-23T16:00:00.000Z</updated>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="机器学习" scheme="https://v2grad.com/categories/machinelearning/"/>
    <category term="ChatGPT" scheme="https://v2grad.com/tags/ChatGPT/"/>
    <category term="InstructGPT" scheme="https://v2grad.com/tags/InstructGPT/"/>
    <content>
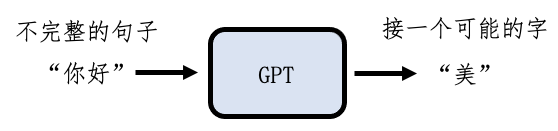
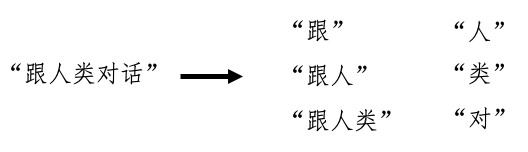
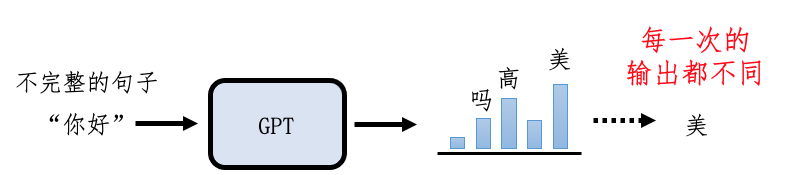
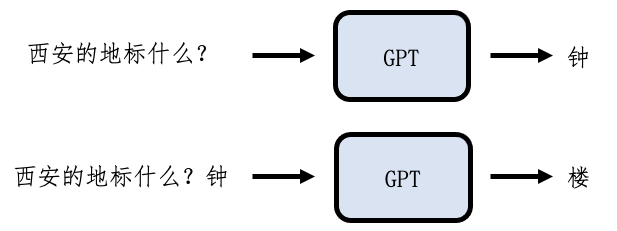
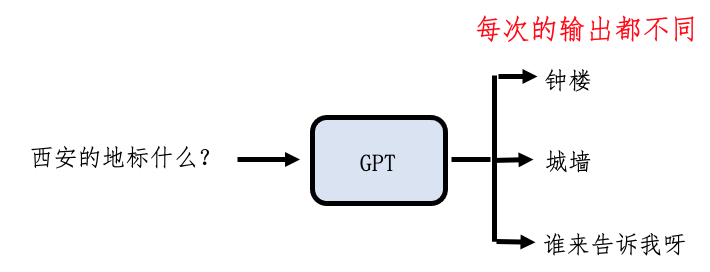
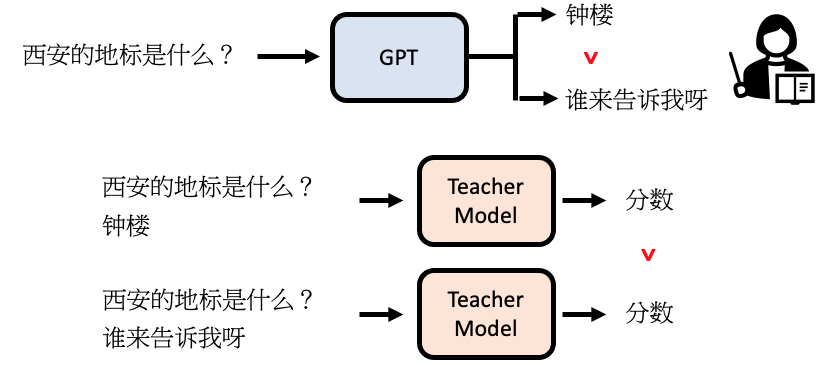
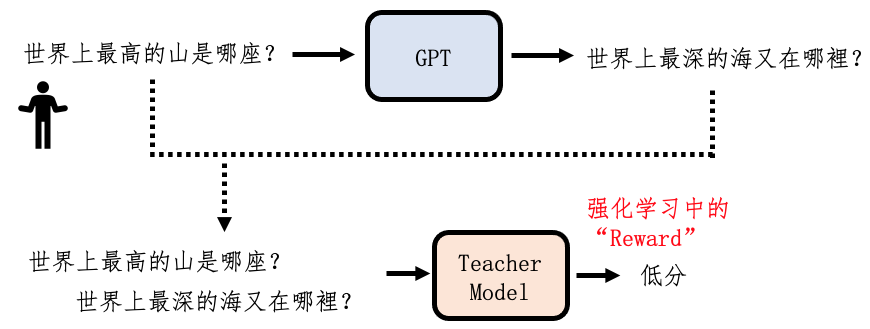
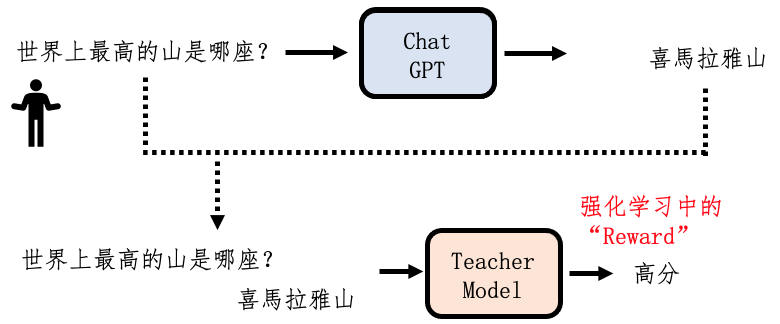
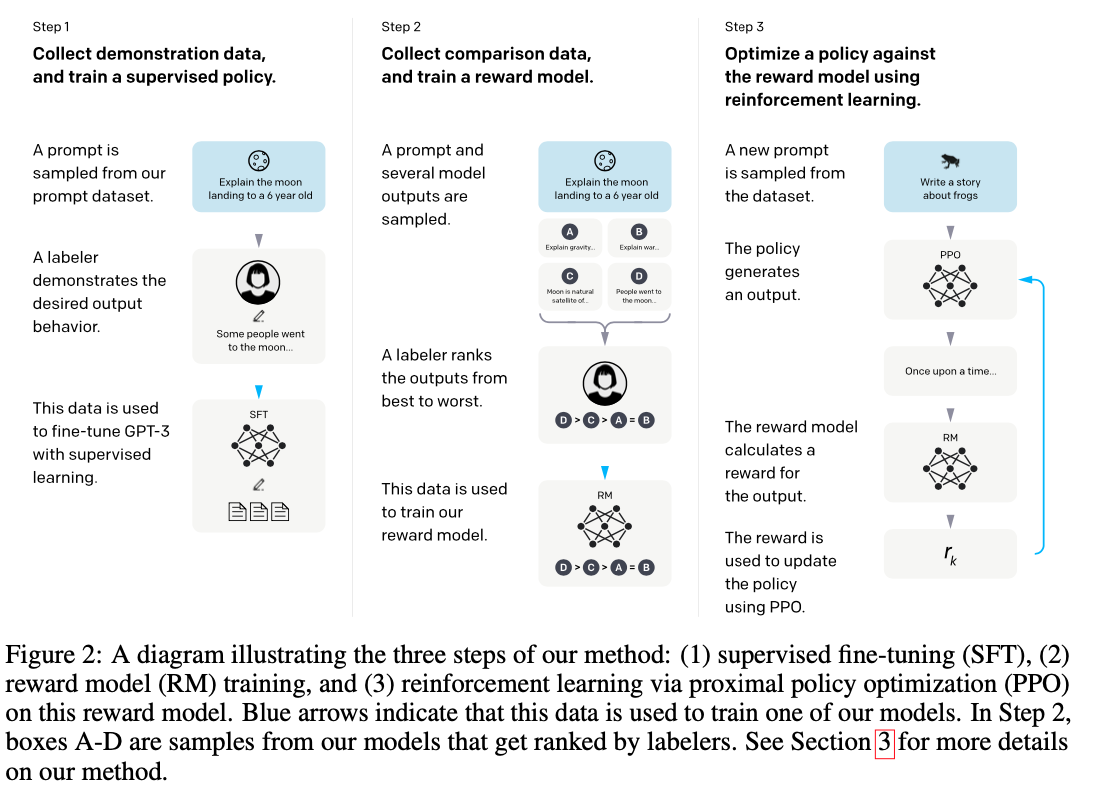
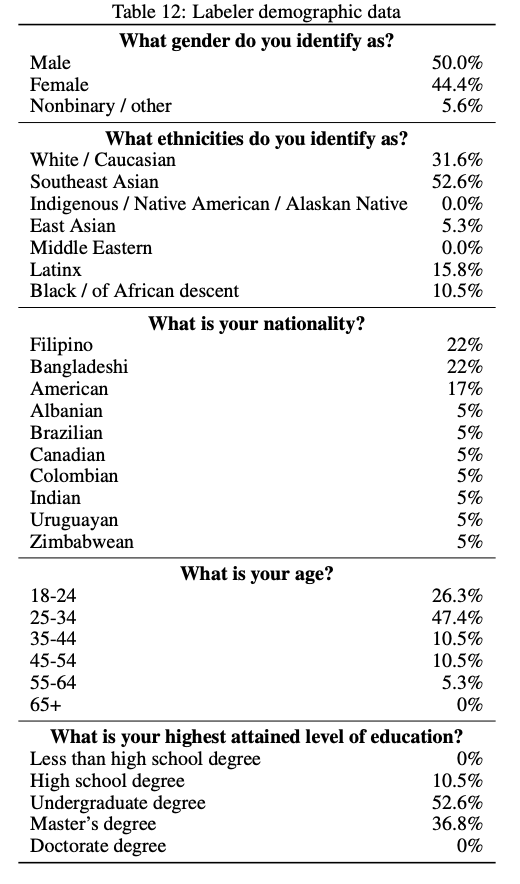
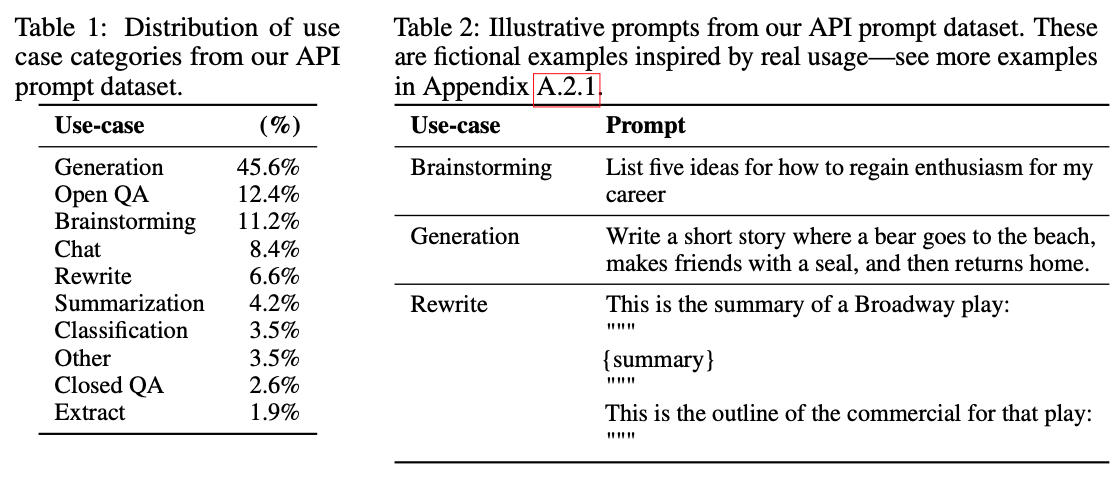
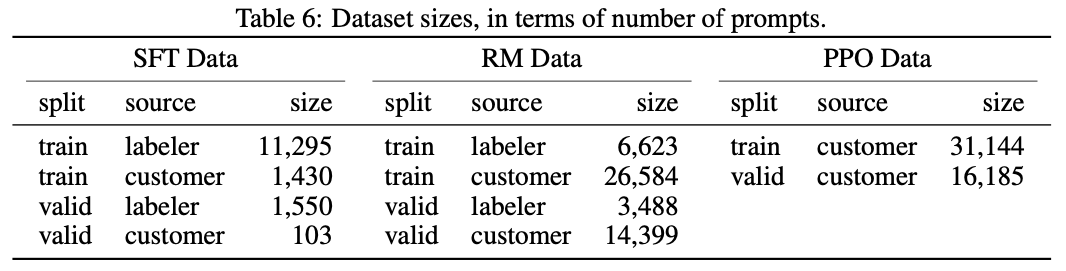
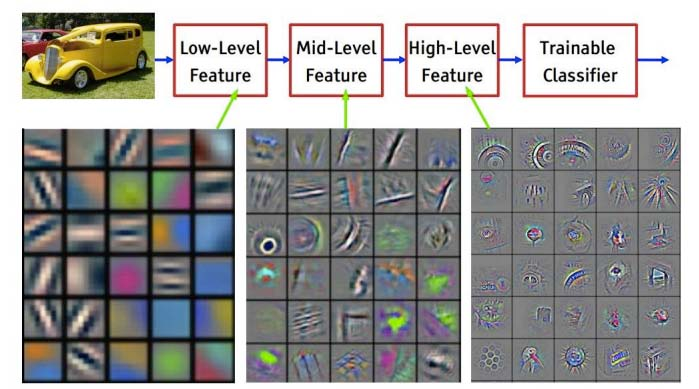
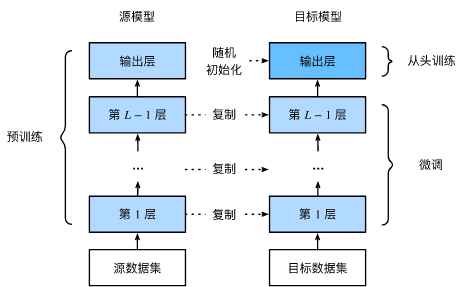
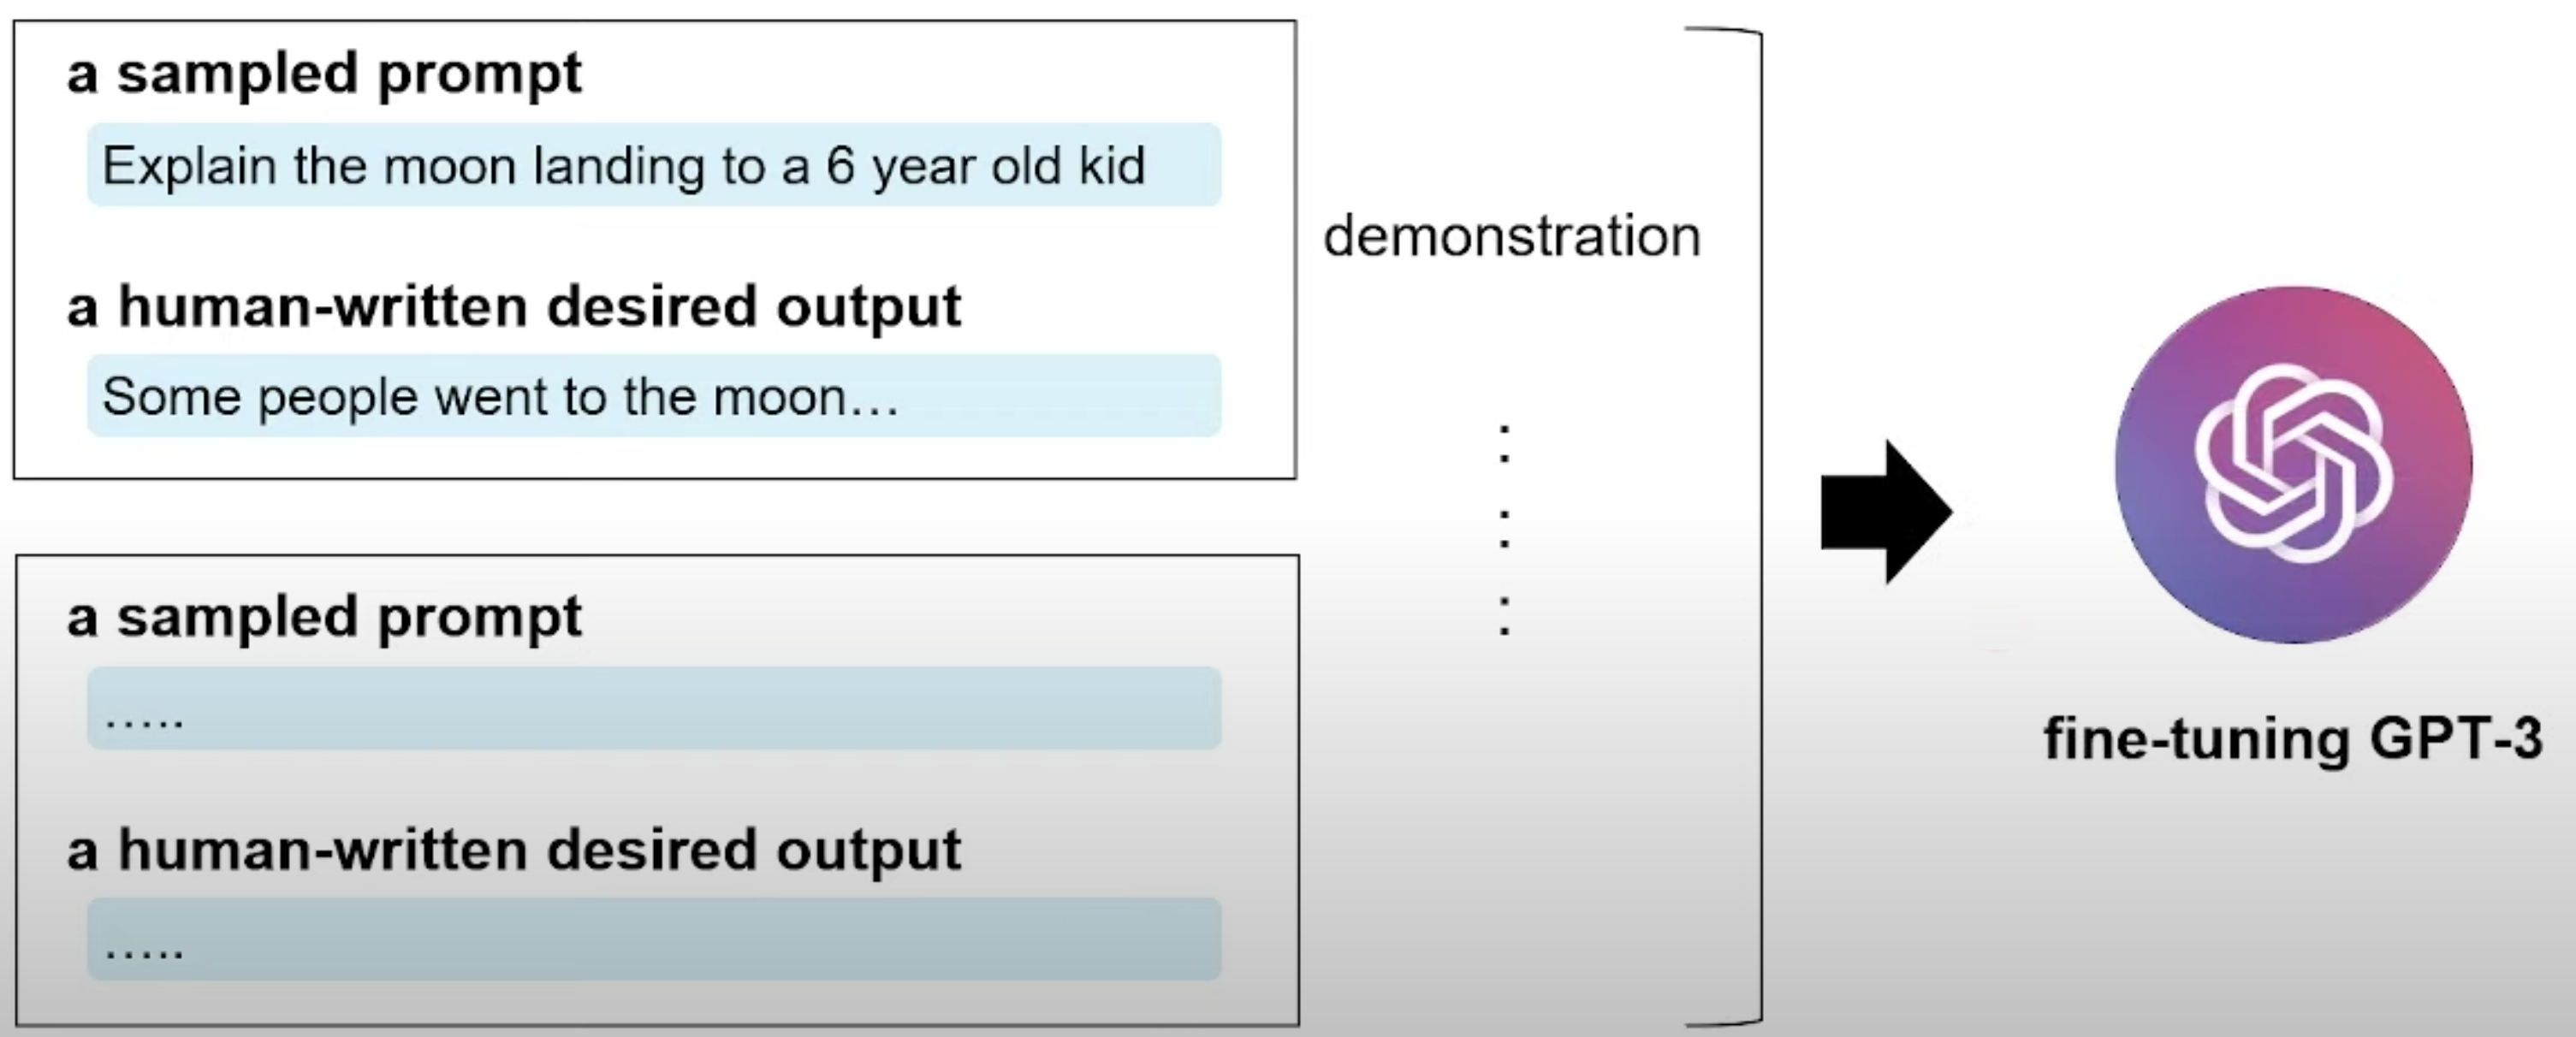
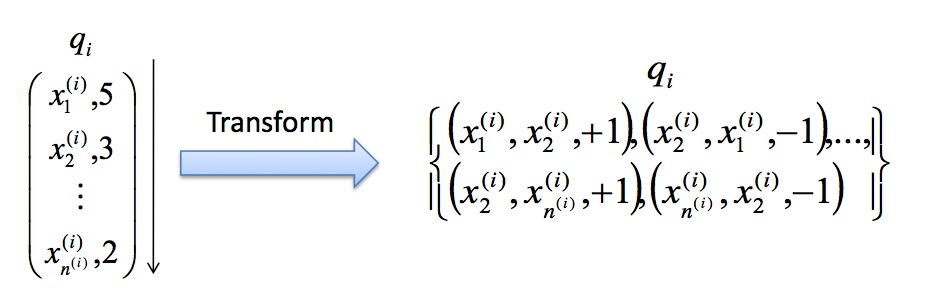
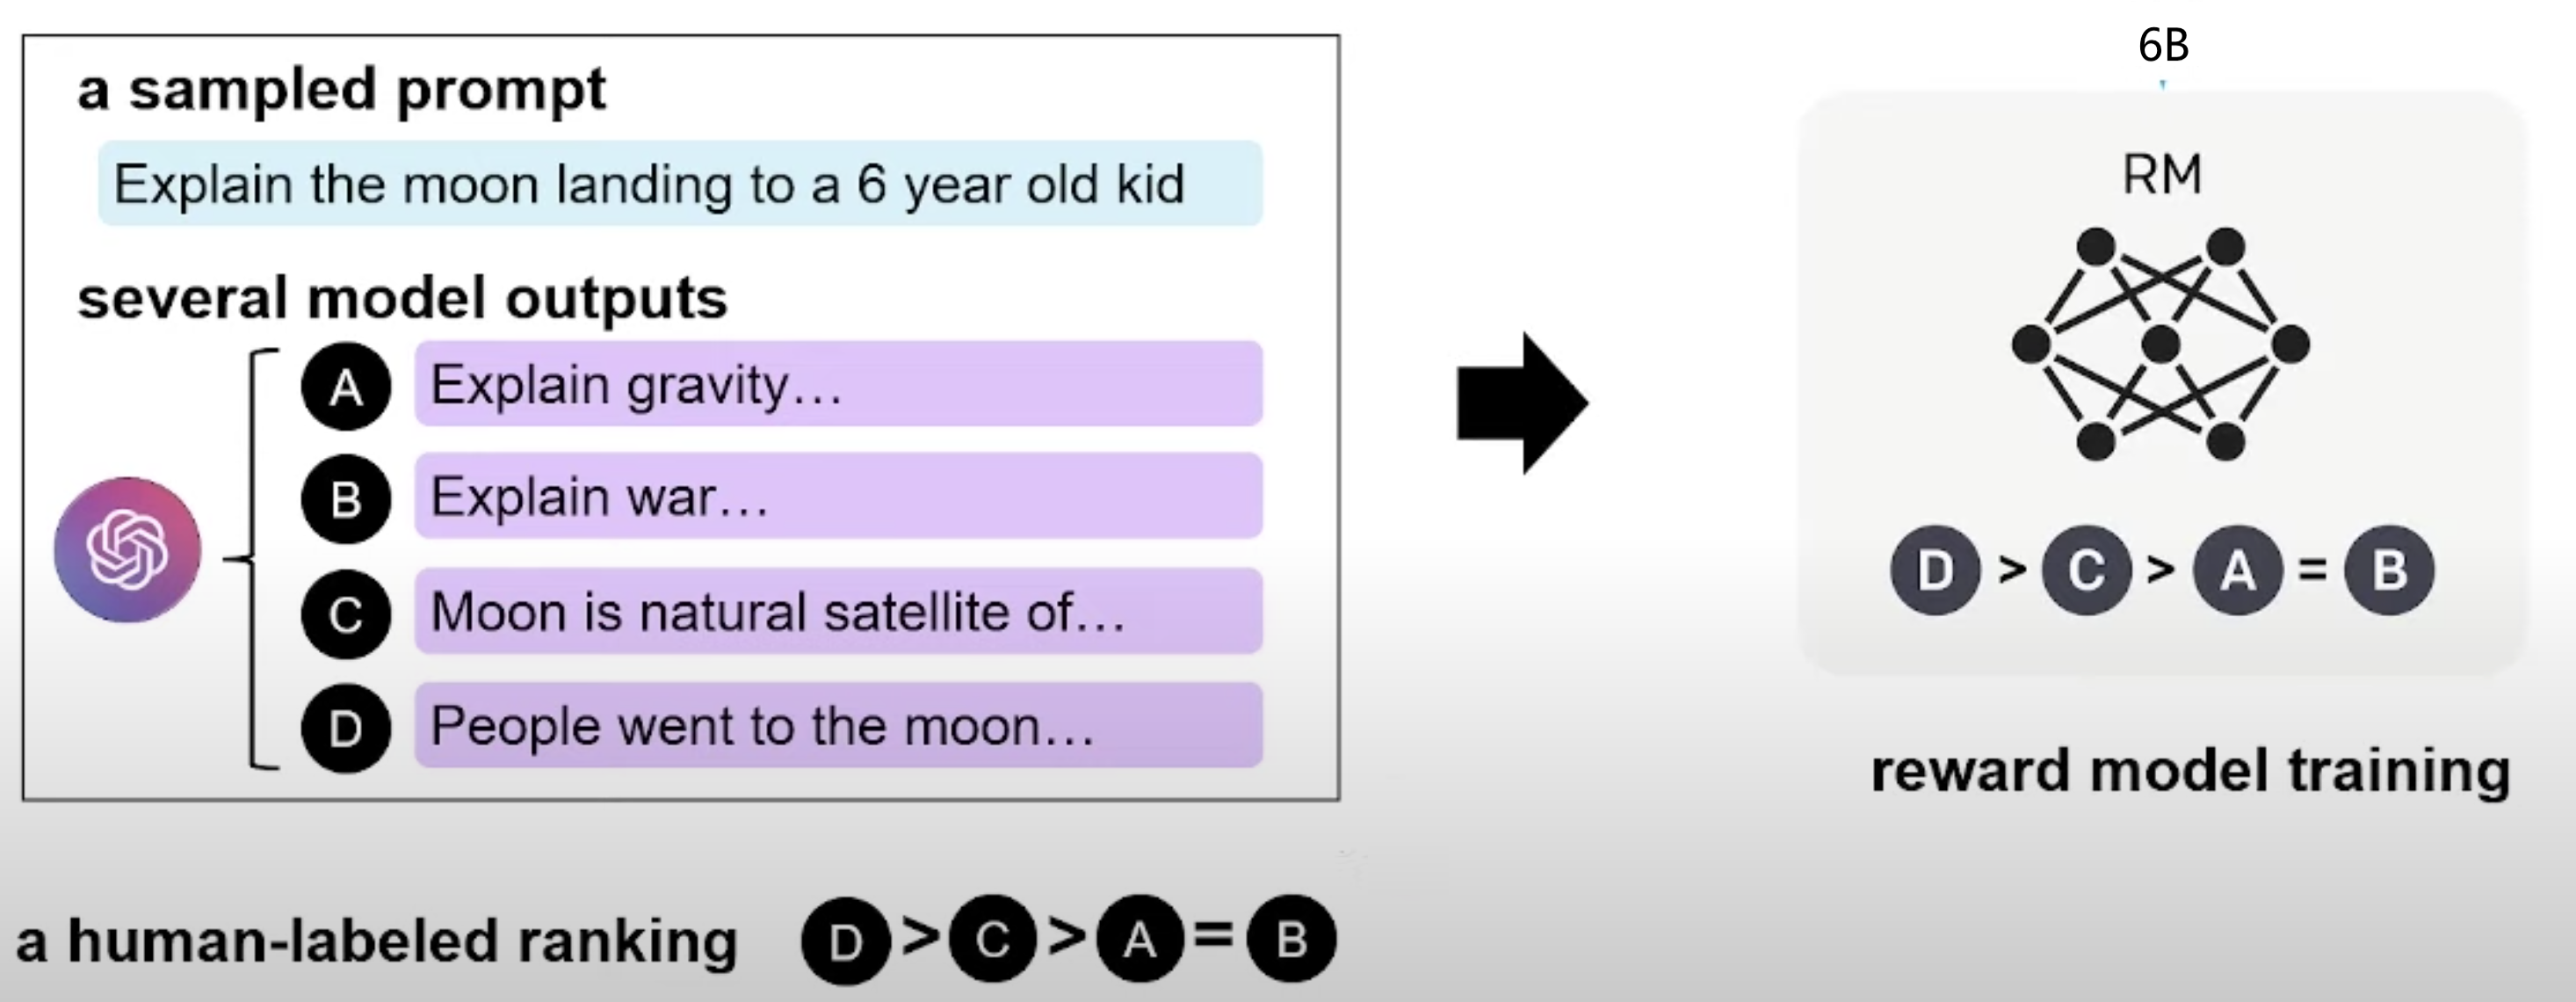
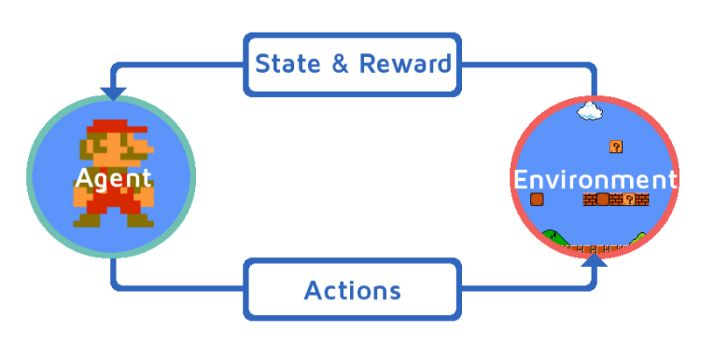
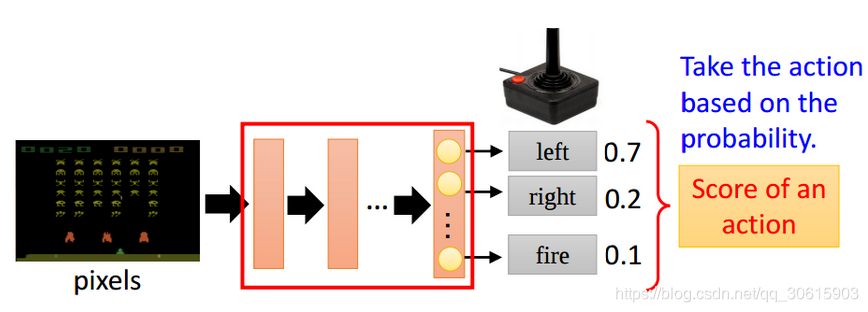
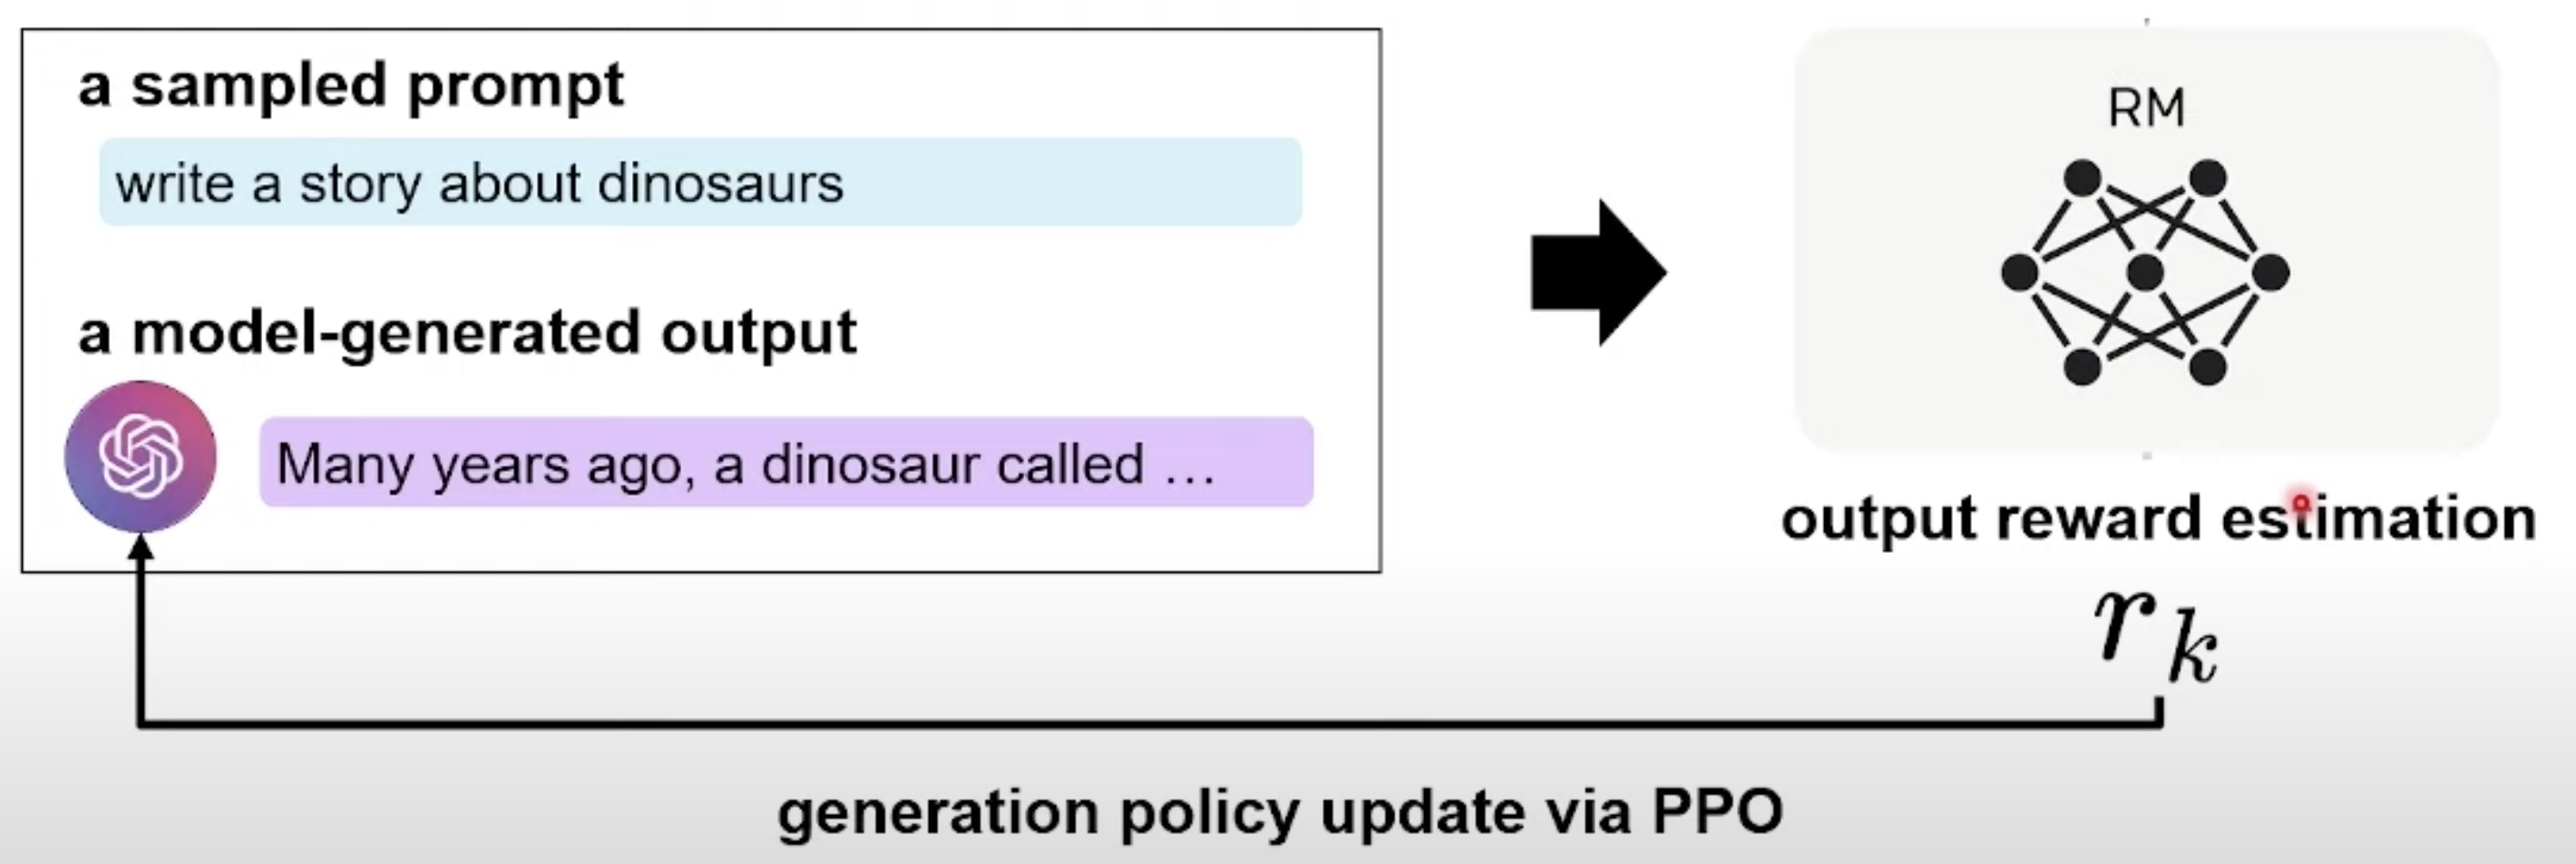
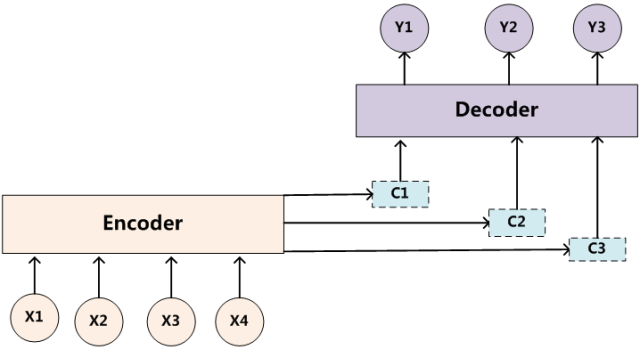
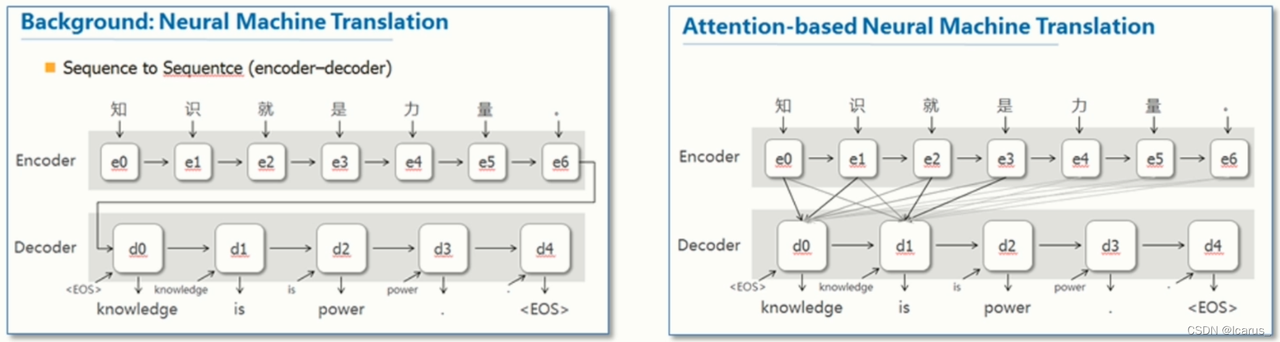
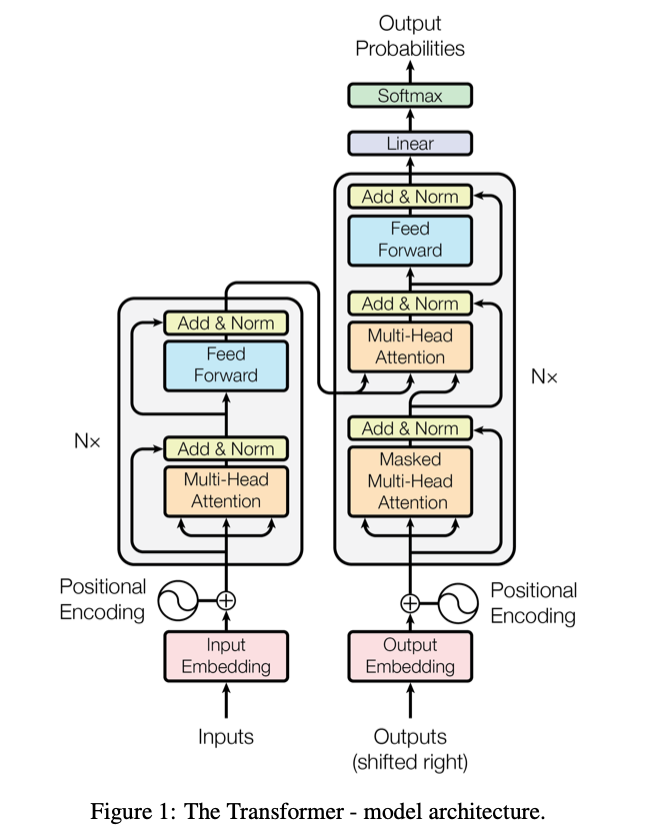
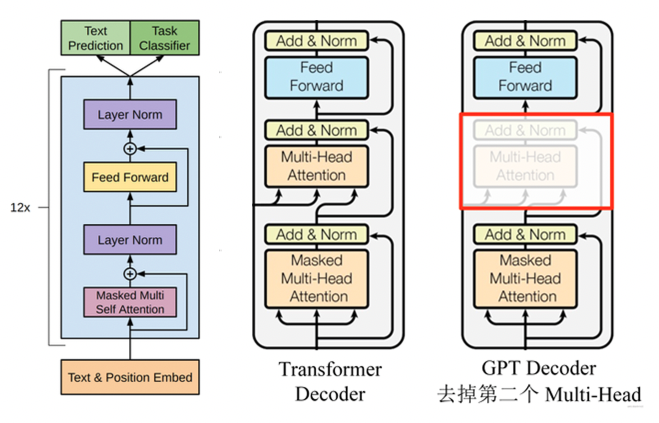
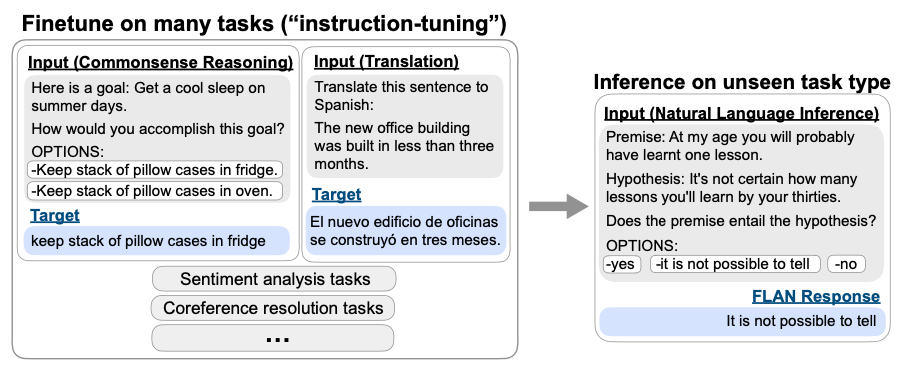
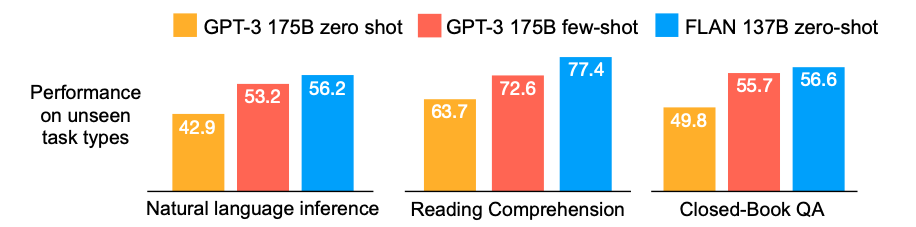
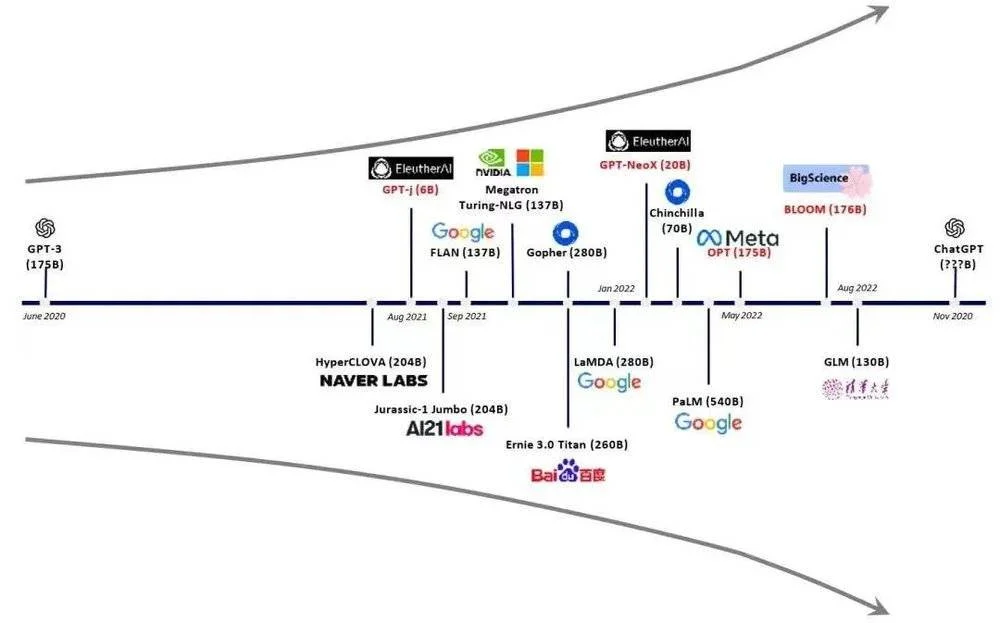
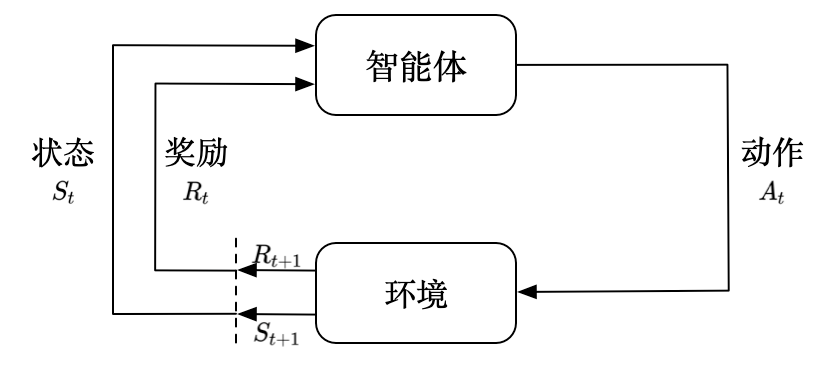
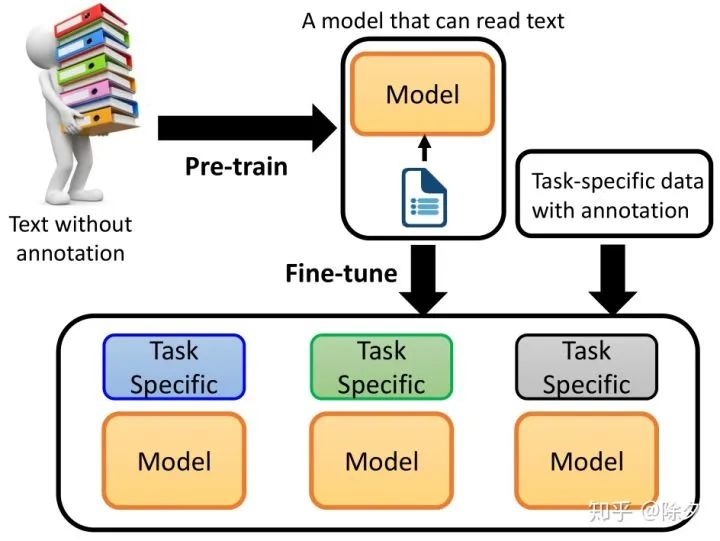
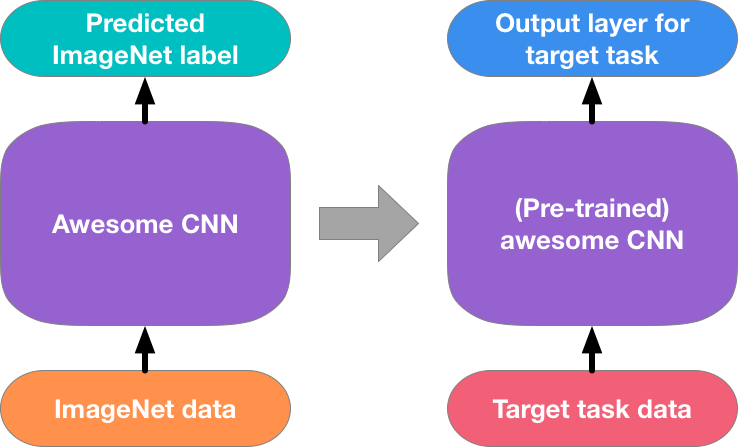
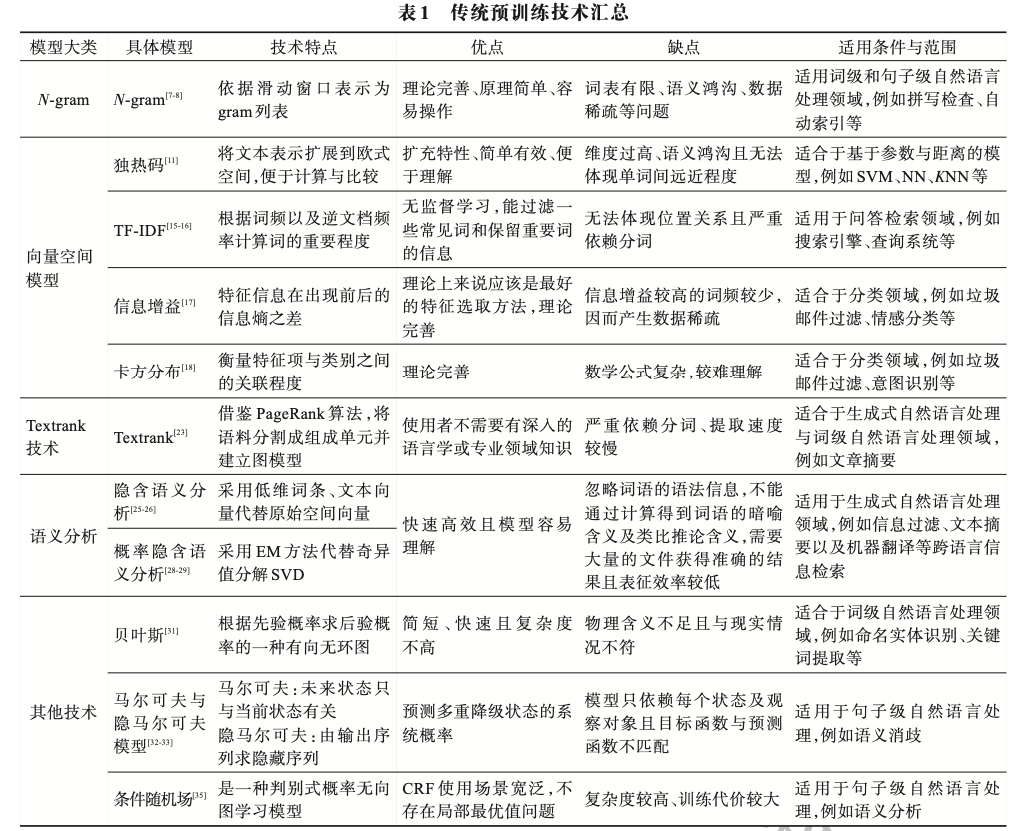
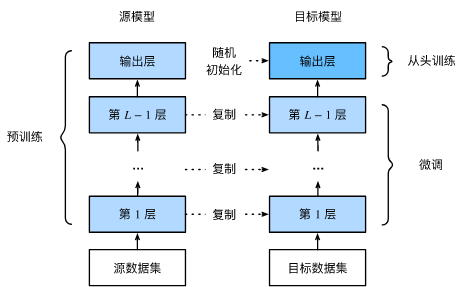
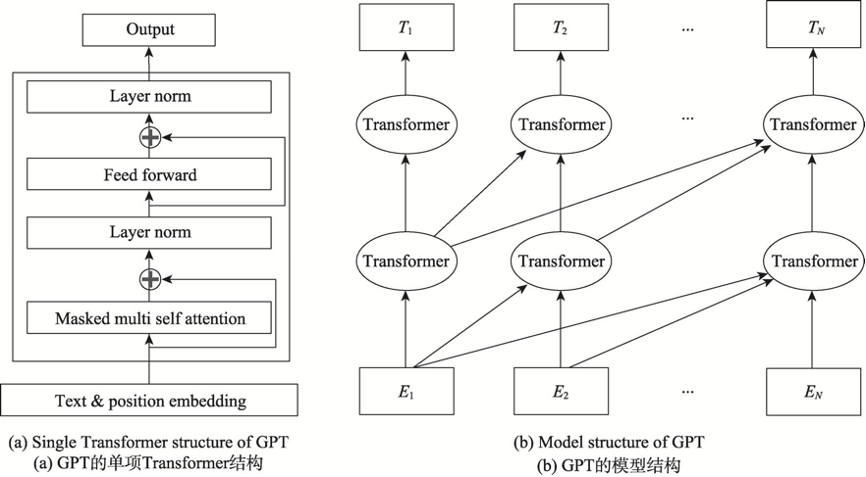
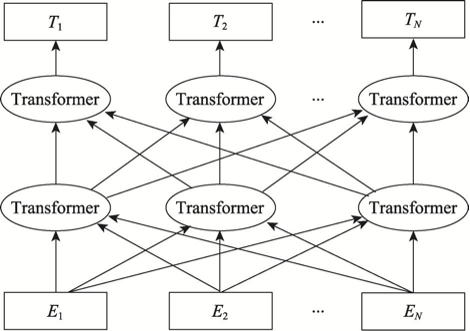
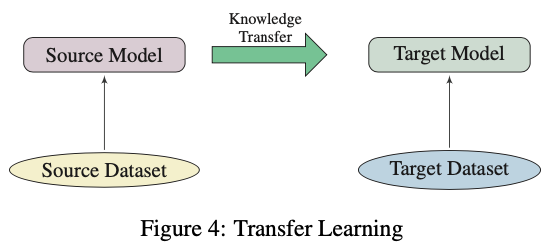
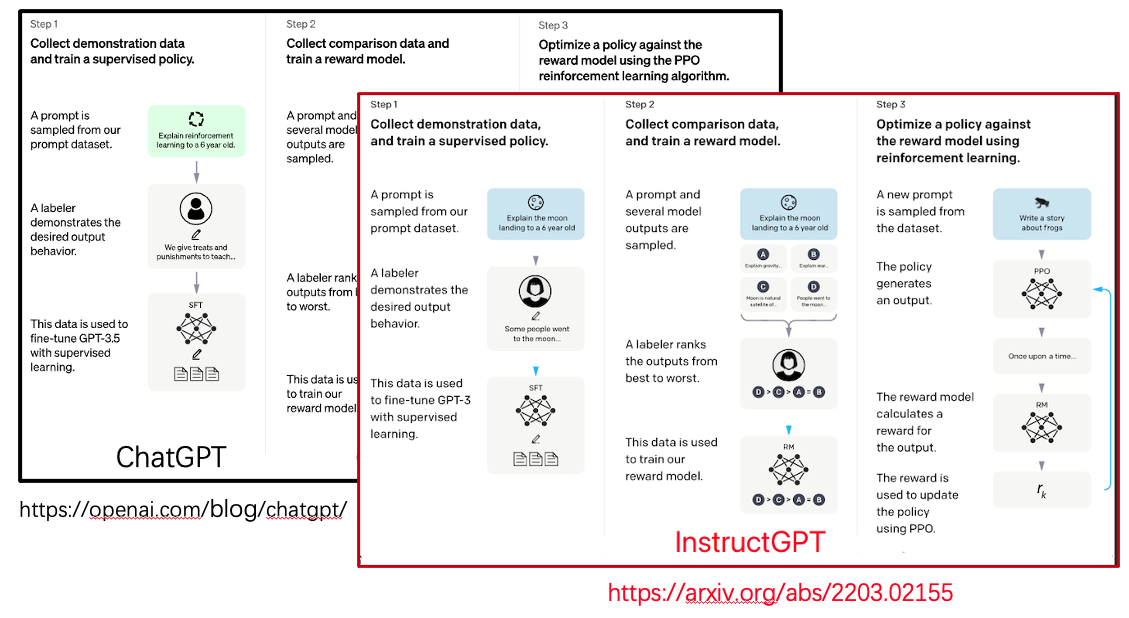
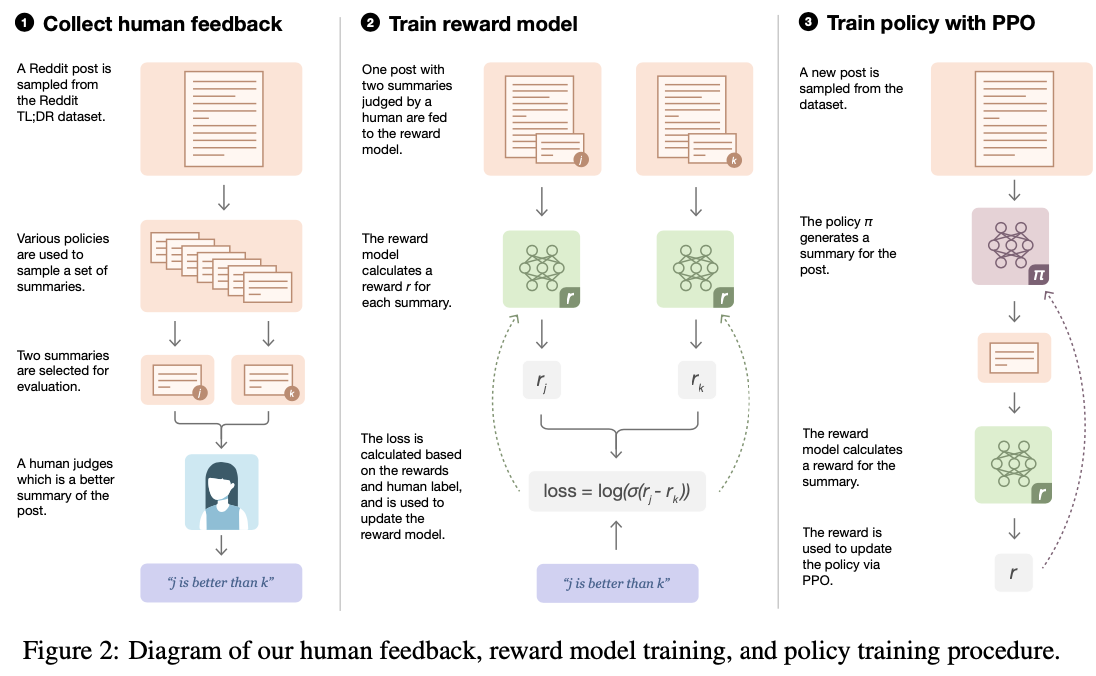
      <![CDATA[<p>目前chatGPT的论文还没有公布，官方介绍里面讲：“ChatGPT is a sibling model to InstructGPT”，对比ChatGPT官网的模型训练流程和InstructGPT的流程图，基本是一致的，只是ChatGPT基于GPT-3.5进行的训练，我们下面的讲解就暂时以InstructGPT代替ChatGPT展开。</p><p><img src="https://static.v2grad.com/img/202302240527749.png" alt="ChatGPT vs InstructGPT" /></p><h2 id="第一层训练流程"><a class="markdownIt-Anchor" href="#第一层训练流程"></a> 第一层：训练流程</h2><blockquote><p>白话讲解ChatGPT的训练流程，不涉及模型训练细节，主要讲解整个训练是如何完成的。</p></blockquote><p>ChatGPT学习的四阶段</p><h3 id="11-第一步学习文字接龙"><a class="markdownIt-Anchor" href="#11-第一步学习文字接龙"></a> 1.1 第一步：学习文字接龙</h3><p><img src="https://static.v2grad.com/img/202302141132504.png" alt="GPT文字接龙" /><br />GPT（Generative Pre-trained Transformer）是一个会<strong>文字接龙</strong>的模型，给他一段文本，他会预测下一个字是什么。</p><p><img src="https://static.v2grad.com/img/202302141133884.png" alt="样本生成逻辑" /><br />训练一个文字接龙的模型是<strong>不需要人工标注的文本的</strong>，只需要在网上收集大量的文字，就可以学文字接龙这件事情。</p><p><img src="https://static.v2grad.com/img/202302141131855.png" alt="真实的输出" /><br />GPT真实的输出是一个概率分布，“你好”的输入，可能跟“高”、“美”、“吗”等等词，每一次的输出都是不同的，出现的概率也不一样。</p><p><img src="https://static.v2grad.com/img/202302141155611.png" alt="文字接龙回答问题" /><br />文字接龙已经可以用来回答问题了，但是…</p><p><img src="https://static.v2grad.com/img/202302141153648.png" alt="每次的输出都不同" /></p><p>GPT输出的是一个概率分布，后面可以接各式各样的句子，很多并不是我们想要的。<br />那我们如何引导GPT产生有用的输出呢？</p><h3 id="12-第二步人类老师引导文字接龙方向"><a class="markdownIt-Anchor" href="#12-第二步人类老师引导文字接龙方向"></a> 1.2 第二步：人类老师引导文字接龙方向</h3><p>找人来思考想问GPT的问题，并人工提供正确答案。</p><ul><li>西安的地标是什么？ --&gt; 钟楼</li><li>如何学习深度学习？ --&gt;  需要先知道基本概念…</li><li>请把这句话做翻译…</li></ul><p>让原始的GPT模型在这部分质量较高的数据集上学习，多看一些有益的句子，期待他能产生出有用的输出。这里不需要穷尽所有问题，只需要告诉GPT人类的偏好。</p><h3 id="13-第三步模仿人类老师的喜好"><a class="markdownIt-Anchor" href="#13-第三步模仿人类老师的喜好"></a> 1.3 第三步：模仿人类老师的喜好</h3><p>训练一个模仿老师的模型，学习人类老师评分高低的标准。<br /><img src="https://static.v2grad.com/img/202302141337882.png" alt="模仿人类老师的喜好" /></p><p>如果人类提交的是“钟楼”这个答案好于“谁来告诉我呀”，那么Teacher Model给“钟楼”这个的打分就要比“谁来告诉我呀”的打分高。</p><h3 id="14-第四步用强化学习向模拟老师学习"><a class="markdownIt-Anchor" href="#14-第四步用强化学习向模拟老师学习"></a> 1.4 第四步：用强化学习向模拟老师学习</h3><p>把“接龙模型GPT”和“老师模型Teacher Model”组合起来使用。</p><p><img src="https://static.v2grad.com/img/202302141407380.png" alt="强化学习" /></p><p>Teacher Model通过前面的学习已经学到，如果答案是一个问句，它不是一个好的答案，给予低分。这个Teacher Model输出的低分就是强化学习的奖励Reward，强化学习通过调整参数，得到最大的Reward</p><p><img src="https://static.v2grad.com/img/202302141408181.png" alt="强化学习" /><br />经过强化学习以后，GPT就变成了ChatGPT，能够输出我们想要的答案了。</p><blockquote><p>总结：整个过程就是教GPT从“<strong>想说什么就说什么</strong>”到“<strong>说人类想要他说的</strong>”。</p></blockquote><h2 id="第二层工程实现"><a class="markdownIt-Anchor" href="#第二层工程实现"></a> 第二层：工程实现</h2><blockquote><p>重点讲解Instruct GPT的论文，《Training language models to follow instructions with human feedback》(训练语言模型使他能够服从人类的指示)。68页的论文主要内容在讲工程实现，包括怎么挑选合适的标注人员，各个模型都是如何准备训练数据的，甚至还给了很多标注表格的模板和训练样本范例。</p></blockquote><p>大型语言模型中的一致性问题通常表现为：</p><ul><li><strong>提供无效帮助</strong>：没有遵循用户的明确指示。</li><li><strong>内容胡编乱造</strong>：虚构不存在或错误事实的模型。</li><li><strong>缺乏可解释性</strong>：人们很难理解模型是如何得出特定决策或预测的。</li><li><strong>内容偏见有害</strong>：一个基于有偏见、有害数据训练的语言模型可能会在其输出中出现这种情况，即使它没有明确指示这样做。</li></ul><p><img src="https://static.v2grad.com/img/202302141453190.png" alt="three steps of Instruct GPT" /></p><p>InstructGPT/ChatGPT的提出了一种利用人类反馈来解决这一问题的方案，方法总体上可以分成3步：</p><ul><li>根据采集的SFT数据集对GPT-3进行有监督的微调（Supervised FineTune，SFT）；</li><li>收集人工标注的对比数据，训练奖励模型（Reword Model，RM）；</li><li>使用RM作为强化学习的优化目标，利用PPO算法微调SFT模型。</li></ul><h3 id="21-数据来源"><a class="markdownIt-Anchor" href="#21-数据来源"></a> 2.1 数据来源</h3><p>训练数据有两个来源：</p><ul><li>由我们的标注人员编写的Prompt数据集</li><li>提交给早期 InstructGPT模型版本API的Prompt数据集</li></ul><p><strong>标记人员</strong></p><p>OpenAI通过一系列的筛选，找到了<strong>40</strong>个对不同人口群体的偏好敏感并且善于识别可能有害的输出的<strong>全职</strong>标记人员。整个过程中，OpenAI的研发人员跟这些标记人员紧密合作，给他们进行了培训，并对他们是否能够代表大众的偏好进行了评测。</p><p>标记人员的工作是根据内容自己编写prompt，并且要求编写的Prompt满足下面三点：</p><ul><li><strong>简单任务</strong>：标记人员给出任意简单的任务，同时要确保任务的多样性；</li><li><strong>Few-shot任务</strong>：标注人员写出一个指示，同时写出其各种不同说法。</li><li><strong>用户相关的</strong>：从接口中获取用例，然后让标记人员根据这些用例编写prompt。</li></ul><p><img src="https://static.v2grad.com/img/202302161318246.png" alt="标记人员分布" /></p><p>40名外包员工来自美国和东南亚，分布比较集中且人数较少， InstructGPT/ChatGPT的目标是训练一个价值观正确的预训练模型，它的价值观是由这40个外包员工的价值观组合而成。而这个比较窄的分布可能会生成一些其他地区比较在意的歧视，偏见问题。</p><p><strong>API用户</strong></p><p>OpenAI训练了一个早期版本的InstructGPT，开放给了一部分用户，根据他们提问信息构造样本，对数据集做了如下操作：</p><ul><li>删除了一些重复的、包含个人信息的prompt；</li><li>每个用户只取200条prompt；</li><li>按照用户ID划分训练集、验证集和测试集，避免类似问题同时出现在训练集和验证集。</li></ul><p><img src="https://static.v2grad.com/img/202302161135589.png" alt="API prompt dataset" /></p><p>prompt种类共有9种，而且绝大多数是生成类任务，可能会导致模型有覆盖不到的任务类型；</p><h3 id="22-训练数据"><a class="markdownIt-Anchor" href="#22-训练数据"></a> 2.2 训练数据</h3><p>基于上面的数据集，生成了三份不同的训练数据集：</p><table><thead><tr><th>数据集</th><th>生成方法</th><th>prompt量</th><th>训练任务</th></tr></thead><tbody><tr><td>SFT dataset</td><td>由标记人员编写prompt对应的回答</td><td>13k</td><td>Supervised FineTune(SFT)</td></tr><tr><td>RM dataset</td><td>由标记人员对gpt产生的答案进行质量排序</td><td>33k</td><td>Reword Model(RM)</td></tr><tr><td>PPO dataset</td><td>不需要人工参与，gpt产生结果，RM进行打分</td><td>31k</td><td>Reinforcement learning (RL)</td></tr></tbody></table><p><img src="https://static.v2grad.com/img/202302161137916.png" alt="prompt" /></p><p>数据中96%以上是英文，其它20个语种例如中文，法语，西班牙语等加起来不到4%，这可能导致InstructGPT/ChatGPT能进行其它语种的生成时，效果应该远不如英文；</p><h3 id="23-模型微调supervised-fine-tuningsft"><a class="markdownIt-Anchor" href="#23-模型微调supervised-fine-tuningsft"></a> 2.3 模型微调Supervised fine-tuning（SFT）</h3><p><img src="https://static.v2grad.com/img/202302161333564.png" alt="神经网络可视化" /><br />低层的网络主要学习图像的边缘或色斑，中层的网络主要学习物体的局部和纹理，高层的网络识别抽象的语义。</p><p>由上面的案例可知，我们可以把一个神经网络分成两块：1）低层的网络进行特征抽取，将原始信息变成容易被后面任务使用的特征；2）输出层的网络进行具体任务的预测。输出层因为涉及到具体任务没办法在不同任务中复用，但是低层的网络是具有通用型的，可以应用到其他任务上。</p><p><img src="https://static.v2grad.com/img/202302161321218.png" alt="微调" /><br />微调由以下4步构成：</p><ul><li>在源数据集上<strong>预训练</strong>一个神经网络模型，即源模型。</li><li>创建一个新的神经网络模型，即目标模型。它<strong>复制</strong>了源模型上除了输出层外的所有模型设计及其参数。我们假设这些模型参数包含了源数据集上学习到的知识，且这些知识同样适用于目标数据集。我们还假设源模型的输出层与源数据集的标签紧密相关，因此在目标模型中不予采用。</li><li>为目标模型添加一个输出大小为目标数据集类别个数的<strong>输出层</strong>，并随机初始化该层的模型参数。</li><li>在目标数据集上<strong>训练目标模型</strong>。我们将从头训练输出层，而其余层的参数都是基于源模型的参数微调得到的。</li></ul><p><img src="https://static.v2grad.com/img/202302170628736.png" alt="SFT" /></p><p>这里的SFT就是基于训练好的GPT-3模型进行的微调，在数据集上面进行了16个epoch的训练，数据量比较小，模型比较大，一个epoch以后就过拟合了，但是论文里面说这个没关系，因为他不是直接拿出去用，而是用来初始化后面的模型。</p><h3 id="24-训练奖励模型reward-modelingrm"><a class="markdownIt-Anchor" href="#24-训练奖励模型reward-modelingrm"></a> 2.4 训练奖励模型Reward modeling（RM）</h3><p>一个Response不能给具体的打分值，只能说一个Response比另一个Response更好或者差不多，所以训练奖励模型的数据是一个标注人员根据生成结果排序的形式，它可以看做一个回归模型。</p><p><img src="https://static.v2grad.com/img/202302161450605.png" alt="pairwise" /><br />奖励模型使用的是PairWise的训练方法，PairWise的基本思路是对样本进行两两比较，构建偏序文档对，从比较中学习顺序。PairWise就是希望通过正确估计一对文档的顺序，而得到整体的正确顺序，比如一个正确的排序为：“A&gt;B&gt;C”，PairWise通过学习两两之间的关系“A&gt;B”，“B&gt;C”和“A&gt;C”来推断“A&gt;B&gt;C”。</p><p><img src="https://static.v2grad.com/img/202302170636619.png" alt="RM" /><br />奖励模型的结构是将SFT训练后的模型的最后的嵌入层去掉后的模型。它的输入是prompt和Reponse，输出是奖励值。GPT-3最大的模型是175B的，但是发现这种规模的模型训练不稳定，最后才用了6B的版本。</p><h3 id="25-强化学习reinforcement-learningrl"><a class="markdownIt-Anchor" href="#25-强化学习reinforcement-learningrl"></a> 2.5 强化学习Reinforcement learning（RL）</h3><p><img src="https://static.v2grad.com/img/202302161741774.png" alt="强化学习" /><br />强化学习（Reinforcement learning，RL）讨论的问题是一个智能体（agent）怎么在一个复杂不确定的 环境（environment) 里面去极大化它能获得的奖励。通过感知所处环境的 状态（state) 对 动作（action） 的反应（reward），来指导更好的动作，从而获得最大的收益（return），这被称为在交互中学习，这样的学习方法就被称作强化学习。</p><p><img src="https://static.v2grad.com/img/202302161736793.png" alt="PPO" /></p><p>PPO（Proximal Policy Optimization）近端策略优化算法，是一种典型的强化学习算法。它通过观测信息选出一个行为直接进行反向传播，当然出人意料的是他并没有误差，而是利用reward奖励直接对选择行为的可能性进行增强和减弱，好的行为会被增加下一次被选中的概率，不好的行为会被减弱下次被选中的概率。</p><p><img src="https://static.v2grad.com/img/202302170633404.png" alt="RL" /><br />这里我们随机取一个用户的prompt，然后使用SFT模型生成一个response，使用奖励模型对当前的prompt-response对打分作为Reward。</p><h3 id="26-结论"><a class="markdownIt-Anchor" href="#26-结论"></a> 2.6 结论</h3><p><img src="https://static.v2grad.com/img/202302161926570.png" alt="结论" /></p><p>该模型基于三个标准进行评估：</p><ul><li><strong>帮助性</strong>：判断模型遵循用户指示以及推断指示的能力。</li><li><strong>真实性</strong>：判断模型在封闭领域任务中有产生虚构事实的倾向。</li><li><strong>无害性</strong>：标注者评估模型的输出是否适当、是否包含歧视性内容。</li></ul><p>该模型跟SFT 175B的模型对比效果，所以我们可以看到SFT 175B的胜率是0.5。</p><p>在对我们的prompt进行人工评估过程中，1.3B个参数的InstructGPT模型的输出优于 175B的GPT-3模型的输出，尽管参数少100倍。此外，InstructGPT模型显示了真实性的提高和有毒输出生成的减少，同时在公共数据集上的性能下降却很小。尽管InstructGPT 仍然会犯一些简单的错误，但我们的结果表明，<strong>根据人类反馈进行微调是使语言模型与人类意图保持一致的一个有前途的方向</strong>。</p><h2 id="第三层发展脉络"><a class="markdownIt-Anchor" href="#第三层发展脉络"></a> 第三层：发展脉络</h2><blockquote><p>任何模型的突破和成功，都不是一蹴而就的，是不断的学习前人的经验和结论，自己一步一步走出来的，这个需要的是厚积薄发。ChatGPT也是一样，要真正理解它，就需要看它之前的工作，从发展脉络的角度去看问题。</p></blockquote><p><img src="https://static.v2grad.com/img/202302240534919.png" alt="模型演进" /></p><h3 id="31-encoder-decoder"><a class="markdownIt-Anchor" href="#31-encoder-decoder"></a> 3.1 Encoder-Decoder</h3><p>Cho在2014年的《Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation》中提出了Encoder–Decoder结构，它由两个RNN组成，另外本文还提出了GRU的门结构，相比LSTM更加简洁，而且效果不输LSTM。</p><p><img src="https://static.v2grad.com/img/20210526143504.png" alt="Encoder-Decoder框架" /></p><p>生成目标句子单词的过程成了下面的形式，其中f1是Decoder的非线性变换函数：</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mtable rowspacing="0.15999999999999992em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msub><mi mathvariant="bold">Y</mi><mn mathvariant="bold">1</mn></msub><mo>=</mo><mi mathvariant="bold">f</mi><mn mathvariant="bold">1</mn><mrow><mo fence="true">(</mo><mi mathvariant="bold">C</mi><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msub><mi mathvariant="bold">Y</mi><mn>2</mn></msub><mo>=</mo><mi mathvariant="bold">f</mi><mn mathvariant="bold">1</mn><mrow><mo fence="true">(</mo><mi mathvariant="bold">C</mi><mo separator="true">,</mo><msub><mi mathvariant="bold">Y</mi><mn mathvariant="bold">1</mn></msub><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msub><mi mathvariant="bold">Y</mi><mn>3</mn></msub><mo>=</mo><mi mathvariant="bold">f</mi><mn mathvariant="bold">1</mn><mrow><mo fence="true">(</mo><mi mathvariant="bold">C</mi><mo separator="true">,</mo><msub><mi mathvariant="bold">Y</mi><mn mathvariant="bold">1</mn></msub><mo separator="true">,</mo><msub><mi mathvariant="bold">Y</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr></mtable><annotation encoding="application/x-tex">\begin{array}{l}\mathbf{Y}_{\mathbf{1}}=\mathbf{f} \mathbf{1}\left(\mathbf{C}\right) \\\mathbf{Y}_{2}=\mathbf{f} \mathbf{1}\left(\mathbf{C}, \mathbf{Y}_{\mathbf{1}}\right) \\\mathbf{Y}_{3}=\mathbf{f} \mathbf{1}\left(\mathbf{C}, \mathbf{Y}_{\mathbf{1}}, \mathbf{Y}_{2}\right)\end{array}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:3.6000000000000005em;vertical-align:-1.5500000000000007em;"></span><span class="mord"><span class="mtable"><span class="arraycolsep" style="width:0.5em;"></span><span class="col-align-l"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:2.05em;"><span style="top:-4.21em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathbf" style="margin-right:0.10903em;">f</span></span><span class="mord"><span class="mord mathbf">1</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathbf">C</span></span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span><span style="top:-3.0099999999999993em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathbf" style="margin-right:0.10903em;">f</span></span><span class="mord"><span class="mord mathbf">1</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathbf">C</span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span><span style="top:-1.8099999999999994em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">3</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathbf" style="margin-right:0.10903em;">f</span></span><span class="mord"><span class="mord mathbf">1</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathbf">C</span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:1.5500000000000007em;"><span></span></span></span></span></span><span class="arraycolsep" style="width:0.5em;"></span></span></span></span></span></span></span></p><p>Encoder和Decoder部分可以是任意的文字、语音、图像和视频数据，模型可以采用CNN，RNN，BiRNN、LSTM、GRU等等，所以基于Encoder-Decoder的结构，我们可以设计出各种各样的应用算法。比如：1）<strong>文字-文字</strong>：机器翻译，对话机器人，文章摘要，代码补全； 2） <strong>音频-文字</strong>：语音识别； 3） <strong>图片-文字</strong>：图像描述生成</p><blockquote><p>Encoder-Decoder的出现，对于很多领域的影响是非常深远的，比如机器翻译的任务，再也不需要做词性分析、词典查询、语序调整和隐马尔可夫模型等等方案，几乎都是基于Encoder-Decoder框架的神经网络方案。</p></blockquote><h3 id="32-attention机制"><a class="markdownIt-Anchor" href="#32-attention机制"></a> 3.2 Attention机制</h3><p>Attention机制最早在视觉领域提出，2014年Google Mind发表了《Recurrent Models of Visual Attention》，使Attention机制流行起来，这篇论文采用了RNN模型，并加入了Attention机制来进行图像的分类。</p><p>2015年，Bahdanau等人在论文《Neural Machine Translation by Jointly Learning to Align and Translate》中，将attention机制首次应用在nlp领域，其采用Seq2Seq+Attention模型来进行机器翻译，并且得到了效果的提升。</p><p><img src="https://static.v2grad.com/img/20210526141037.png" alt="人类的视觉注意力" /></p><p>语义编码C是由句子Source的每个单词经过Encoder编码产生的，这意味着不论是生成哪个单词，其实句子Source中任意单词对生成某个目标单词来说影响力都是相同的，这是为何说这个模型没有体现出注意力的缘由。这类似于人类看到眼前的画面，但是眼中却没有注意焦点一样。</p><p>我们拿机器翻译来解释一下注意力在Encoder-Decoder模型中的作用就更好理解了，比如输入的是英文句子：Tom chase Jerry，Encoder-Decoder框架逐步生成中文单词：“汤姆”，“追逐”，“杰瑞”。</p><p>在翻译“杰瑞”这个中文单词的时候，没有注意力的模型里面的每个英文单词对于翻译目标单词“杰瑞”贡献是相同的，很明显这里不太合理，显然“Jerry”对于翻译成“杰瑞”更重要，但是没有注意力的模型是无法体现这一点的。</p><p>目标句子中的每个单词都应该学会其对应的源语句子中单词的注意力分配概率信息。这意味着在生成每个单词yi的时候，原先都是相同的中间语义表示C会被替换成根据当前生成单词而不断变化的Ci。理解Attention模型的关键就是这里，即<strong>由固定的中间语义表示C换成了根据当前输出单词来调整成加入注意力模型的变化的Ci</strong>。增加了注意力模型的Encoder-Decoder框架理解起来如图所示。</p><p><img src="https://static.v2grad.com/img/20210526150157.png" alt="引入注意力模型的Encoder-Decoder框架" /></p><p>即生成目标句子单词的过程成了下面的形式：</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mtable rowspacing="0.15999999999999992em" columnalign="left" columnspacing="1em"><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msub><mi mathvariant="bold">Y</mi><mn mathvariant="bold">1</mn></msub><mo>=</mo><mi mathvariant="bold">f</mi><mn mathvariant="bold">1</mn><mrow><mo fence="true">(</mo><msub><mi mathvariant="bold">C</mi><mn mathvariant="bold">1</mn></msub><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msub><mi mathvariant="bold">Y</mi><mn>2</mn></msub><mo>=</mo><mi mathvariant="bold">f</mi><mn mathvariant="bold">1</mn><mrow><mo fence="true">(</mo><msub><mi mathvariant="bold">C</mi><mn>2</mn></msub><mo separator="true">,</mo><msub><mi mathvariant="bold">Y</mi><mn mathvariant="bold">1</mn></msub><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr><mtr><mtd><mstyle scriptlevel="0" displaystyle="false"><mrow><msub><mi mathvariant="bold">Y</mi><mn>3</mn></msub><mo>=</mo><mi mathvariant="bold">f</mi><mn mathvariant="bold">1</mn><mrow><mo fence="true">(</mo><msub><mi mathvariant="bold">C</mi><mn>3</mn></msub><mo separator="true">,</mo><msub><mi mathvariant="bold">Y</mi><mn mathvariant="bold">1</mn></msub><mo separator="true">,</mo><msub><mi mathvariant="bold">Y</mi><mn>2</mn></msub><mo fence="true">)</mo></mrow></mrow></mstyle></mtd></mtr></mtable><annotation encoding="application/x-tex">\begin{array}{l}\mathbf{Y}_{\mathbf{1}}=\mathbf{f} \mathbf{1}\left(\mathbf{C}_{\mathbf{1}}\right) \\\mathbf{Y}_{2}=\mathbf{f} \mathbf{1}\left(\mathbf{C}_{2}, \mathbf{Y}_{\mathbf{1}}\right) \\\mathbf{Y}_{3}=\mathbf{f} \mathbf{1}\left(\mathbf{C}_{3}, \mathbf{Y}_{\mathbf{1}}, \mathbf{Y}_{2}\right)\end{array}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:3.6000000000000005em;vertical-align:-1.5500000000000007em;"></span><span class="mord"><span class="mtable"><span class="arraycolsep" style="width:0.5em;"></span><span class="col-align-l"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:2.05em;"><span style="top:-4.21em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathbf" style="margin-right:0.10903em;">f</span></span><span class="mord"><span class="mord mathbf">1</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord"><span class="mord mathbf">C</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span><span style="top:-3.0099999999999993em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathbf" style="margin-right:0.10903em;">f</span></span><span class="mord"><span class="mord mathbf">1</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord"><span class="mord mathbf">C</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span><span style="top:-1.8099999999999994em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">3</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathbf" style="margin-right:0.10903em;">f</span></span><span class="mord"><span class="mord mathbf">1</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord"><span class="mord mathbf">C</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">3</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathbf mtight">1</span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord"><span class="mord mathbf" style="margin-right:0.02875em;">Y</span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:1.5500000000000007em;"><span></span></span></span></span></span><span class="arraycolsep" style="width:0.5em;"></span></span></span></span></span></span></span></p><p><img src="https://static.v2grad.com/img/202302240536840.png" alt="attention机制添加以后的翻译的过程" /></p><blockquote><p>Attention机制由来已久，真正让其大放异彩的，是后来Google的一篇文章《Attention is All You Need》。</p></blockquote><h3 id="33-transformer"><a class="markdownIt-Anchor" href="#33-transformer"></a> 3.3 Transformer</h3><p>2017年，Google机器翻译团队发表的《Attention is All You Need》中，提出了他们的Transformer架构，Transformer基于经典的机器翻译Seq2Seq框架，完全抛弃了RNN和CNN等网络结构，而仅仅采用Attention机制来进行机器翻译任务，在WMT 2014的数据集上取得了很好的成绩。</p><p><img src="https://static.v2grad.com/img/202109290538512.png" alt="Transformer的架构" /></p><p><strong>编码器</strong><br />编码器由N=6个相同的layer组成，layer指的就是上图左侧的单元，最左边有个“Nx”，这里是x6个。每个Layer由两个子层（Sub-Layer）组成,第一个子层是Multi-head Self-attention Mechanism，第二个子层比较简单，是Fully Connected Feed-Forward Network。其中每个子层都加了残差连接（Residual Connection）和层归一化（Layer Normalisation），因此可以将子层的输出表示为：<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mtext> LayerNorm </mtext><mo stretchy="false">(</mo><mi>x</mi><mo>+</mo><mi mathvariant="normal">SubLayer</mi><mo>⁡</mo><mo stretchy="false">(</mo><mi>x</mi><mo stretchy="false">)</mo><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">\text { LayerNorm }(x+\operatorname{SubLayer}(x))</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord text"><span class="mord"> LayerNorm </span></span><span class="mopen">(</span><span class="mord mathdefault">x</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mop"><span class="mord mathrm">S</span><span class="mord mathrm">u</span><span class="mord mathrm">b</span><span class="mord mathrm">L</span><span class="mord mathrm">a</span><span class="mord mathrm" style="margin-right:0.01389em;">y</span><span class="mord mathrm">e</span><span class="mord mathrm">r</span></span><span class="mopen">(</span><span class="mord mathdefault">x</span><span class="mclose">)</span><span class="mclose">)</span></span></span></span></p><p><strong>解码器</strong><br />解码器同样由N=6个相同layer组成，因为编码器是并行计算一次性将结果直接输出，而解码器是一个词一个词输入，所以解码器除了每个编码器层中的两个子层之外，还插入第三子层，其对编码器堆栈的输出执行multi-head attention。每个子层也都加了残差连接（Residual Connection）和层归一化（Layer Normalisation）。解码器中对self-attention子层进行了修改，以防止引入当前时刻的后续时刻输入，这种屏蔽与输出嵌入偏移一个位置的事实相结合，确保了位置i的预测仅依赖于小于i的位置处的已知输出。</p><blockquote><p>Transformer出现后，开始取代RNN（循环神经网络）和 CNN（卷积神经网络）成为最热门的信息提取工具，以前做NLP（自然语言处理）研究的喜欢用RNN，做CV（计算机视觉）研究的喜欢用CNN，现在大家都用Transformer了，很多研究进展可以同步到另一个领域。</p></blockquote><h3 id="34-gpt"><a class="markdownIt-Anchor" href="#34-gpt"></a> 3.4 GPT</h3><p>传统的NLP模型往往使用大量的数据对有监督的模型进行任务相关的模型训练，但是高质量的标注数据往往很难获得，而且不同任务的模型很难泛化到其他任务上，所以OpenAI在《Improving Language Understanding By Generative Pre-training》提出先在大量的无标签数据上训练一个语言模型，然后再在下游具体任务的有标签数据集上进行fine-tune。</p><p>GPT是典型的<strong>预训练+微调</strong>的两阶段模型。预训练阶段就是用海量的文本数据通过无监督学习的方式来获取语言学知识，而微调就是用下游任务的训练数据来获得特定任务的模型。</p><p>举一个例子来形容预训练和微调的关系，我们从幼儿园到高中就像预训练过程，不断学习知识，这些知识包罗万象包括语数英物化生等等，最重要的特征就是预训练模型具有很好的通用性；然后读大学的时候需要确定一个专业方向作为未来的职业，所以就会去重点学习专业知识，从而让我们成为更加适合某个专业方向的人才，最重要的特征就是具有极强的专业性。</p><p><img src="https://static.v2grad.com/img/202302171642998.png" alt="gpt使用的是transformer的Decoder部分" /></p><p>GPT模型效果还是非常出色的，12个任务数据集中9个达到了最好效果。</p><h3 id="35-bert"><a class="markdownIt-Anchor" href="#35-bert"></a> 3.5 BERT</h3><p>2018年10月，Google发表《BERT_Pre-training of Deep Bidirectional Transformers for Language Understanding》，提出了类似于GPT的预训练模型BERT。</p><p><img src="https://static.v2grad.com/img/202302171650512.png" alt="bert使用的是transformer的Encoder部分" /></p><p>BERT和GPT采用了不同的技术路线，简单理解，BERT是一个双向模型，可以联系上下文进行分析，更擅长<strong>完形填空</strong>；而GPT是一个单向模型，只能从左到右进行阅读，更擅长<strong>写作文</strong>。</p><p>发布更早的GPT-1输给了晚4个月发布的BERT，而且是完败。在当时的竞赛排行榜上，阅读理解领域已经被BERT屠榜了。此后，BERT也成为了NLP领域最常用的模型。<br /><img src="https://static.v2grad.com/img/202302181424811.png" alt="bert on GLUE" /></p><h3 id="36-gpt-2-gpt-3"><a class="markdownIt-Anchor" href="#36-gpt-2-gpt-3"></a> 3.6 GPT-2 &amp; GPT-3</h3><p>OpenAI既没有认输，也非常头铁。虽然GPT-1效果不如BERT，但OpenAI没有改变策略，而是坚持走大模型路线。接下来的两年（2019、2020年），在几乎没有改变模型架构的基础上，OpenAI 陆续推出参数更大的迭代版本GPT-2、GPT-3，前者有15亿参数，后者有1750亿参数，最终GPT-3的模型效果震惊世人，成功出圈。</p><table><thead><tr><th>模型</th><th>发布时间</th><th>层数</th><th>头数</th><th>词向量长度</th><th>参数量</th><th>预训练数据量</th></tr></thead><tbody><tr><td>GPT-1</td><td>2018 年 6 月</td><td>12</td><td>768</td><td>768</td><td>1.17 亿</td><td>约5GB</td></tr><tr><td>GPT-2</td><td>2019 年 2 月</td><td>48</td><td>-</td><td>1600</td><td>15 亿</td><td>40GB</td></tr><tr><td>GPT-3</td><td>2020 年 5 月</td><td>96</td><td>96</td><td>12288</td><td>1750 亿</td><td>45TB</td></tr></tbody></table><p>但是单纯的说用一个更大的模型打败了对手感觉还不够，GPT-2和3开始卷另一个方向，不用做梯度更新和微调依然可以完成很多任务，也就是Zero-shot。在OpenAI眼中，未来的通用人工智能应该长这个样子：<strong>有一个任务无关的超大型的语言模型（Large Language Model, LLM），用来从海量数据中学习各种知识，这个LLM以生成一切的方式，来解决各种各样的实际问题，而且它应该能听懂人类的命令，以便于人类使用。</strong></p><p><img src="https://static.v2grad.com/img/202302181434145.png" alt="Zero-shot, one-shot and few-shot, contrasted with traditional fine-tuning." /></p><blockquote><p>本身在这么大的模型上做梯度更新和微调就是一个门槛很高的事情，GPT-3模型对于Zero-shot、one-shot和few-shot的支持，使得基于他可以衍生出了上百个基于GPT-3的应用。</p></blockquote><h3 id="37-instruction-tuning"><a class="markdownIt-Anchor" href="#37-instruction-tuning"></a> 3.7 instruction Tuning</h3><p>Google在2021年发表《Finetuned Language Models are Zero-Shot Learners》，提出了一种提高语言模型Zero-shot能力的方法。</p><p>比如我们要进行一句话的情感分析，“带女朋友去了一家餐厅，她吃的很开心”，我们可以有两种做法：</p><ul><li>利用模型补全的能力，改造prompt：“带女朋友去了一家餐厅，她吃的很开心，这家餐厅太__了！”</li><li>直接告诉模型任务：“判断这句话的情感：带女朋友去了一家餐厅，她吃的很开心。选项：A=好，B=一般，C=差”<br />instruction Tuning是第二种。</li></ul><p><img src="https://static.v2grad.com/img/202302201150042.png" alt="pretrain–finetune and prompting and instruction Tuning" /></p><p>Instruction tuning的动机是为了提高语言模型对instructions的<strong>理解和响应能力</strong>。其想法是，通过监督来教语言模型执行instructions描述的任务，从而使它将学习到如何遵循instructions，当面对unseen的任务时，模型自然而然地就会遵循instruction做出响应。<br /><img src="https://static.v2grad.com/img/202302201152876.png" alt="instruction-tuning" /><br />首先在包括commonsense reasoning、machine translation、sentiment analysis等NLP task上进行微调，然后在从未见过的natural language inference任务上进行zero-shot evaluation</p><p><img src="https://static.v2grad.com/img/202302201404574.png" alt="performance of zero-shot FLAN" /></p><h3 id="38-instructgptchatgpt"><a class="markdownIt-Anchor" href="#38-instructgptchatgpt"></a> 3.8 InstructGPT/ChatGPT</h3><p>InstructGPT论文《Training language models to follow instructions with human feedback》，我们已经讲清楚language models和instructions，剩下就是with human feedback。</p><p>人工反馈的强化学习（Reinforcement Learning from Human Feedback，RLHF）参考了OpenAI前面的两个工作。</p><p>Ziegler在2019年的《Fine-Tuning Language Models from Human Preferences》<br /><img src="https://static.v2grad.com/img/202302201425975.png" alt="Ziegler et al. (2019)" /></p><p>Stiennon在2020年《Learning to summarize from human feedback》<br /><img src="https://static.v2grad.com/img/202302201426679.png" alt="Stiennon et al. (2020)," /></p><p>ChatGPT和InstructGPT在模型结构，训练方式上都完全一致，即都使用了指示学习（Instruction Learning）和人工反馈的强化学习（Reinforcement Learning from Human Feedback，RLHF）来指导模型的训练，它们不同的仅仅是采集数据的方式上有所差异。</p><h2 id="写在最后"><a class="markdownIt-Anchor" href="#写在最后"></a> 写在最后</h2><h3 id="41-安全性"><a class="markdownIt-Anchor" href="#41-安全性"></a> 4.1 安全性</h3><p>2016年，微软AI Tay，种族歧视，下线。<br />Microsoft shuts down AI chatbot after it turned into a Nazi。<br /><a href="https://www.cbsnews.com/news/microsoft-shuts-down-ai-chatbot-after-it-turned-into-racist-nazi/">https://www.cbsnews.com/news/microsoft-shuts-down-ai-chatbot-after-it-turned-into-racist-nazi/</a></p><p>2021年，Facebook，AI将黑人标上了灵长目的标签<br />Facebook Apologizes After A.I. Puts ‘Primates’ Label on Video of Black Men<br />Facebook called it “an unacceptable error.” The company has struggled with other issues related to race.<br /><a href="https://www.nytimes.com/2021/09/03/technology/facebook-ai-race-primates.html">https://www.nytimes.com/2021/09/03/technology/facebook-ai-race-primates.html</a></p><p>语言模型的输出特别灵活，导致出错的概率会更大，OpenAI作为一个创业公司，媒体对于GPT的容忍度大一些，如果是大公司做的GPT模型，可能已经下架了。</p><h3 id="42-成本"><a class="markdownIt-Anchor" href="#42-成本"></a> 4.2 成本</h3><p><img src="https://static.v2grad.com/img/202302240540923.png" alt="LLM模型" /></p><p>大模型背后离不开大数据、大算力。GPT-2用于训练的数据取自于Reddit上高赞的文章，数据集共有约800万篇文章，累计体积约40G；GPT-3模型的神经网络是在超过45TB的文本上进行训练的，数据相当于整个维基百科英文版的160倍。</p><p>在算力方面，GPT-3.5在微软Azure AI超算基础设施（由V100GPU组成的高带宽集群）上进行训练，总算力消耗约3640PF-days（即每秒一千万亿次计算，运行3640天）。可以说，大模型的训练就是靠烧钱烧出来的。据估算，OpenAI的模型训练成本高达1200万美元，GPT-3的单次训练成本高达460万美元。</p><p>根据《财富》杂志报道的数据，2022年OpenAI的收入为3000万美元，但净亏损总额预计为5.445亿美元。阿尔特曼在Twitter上回答马斯克的问题时表示，在用户与ChatGPT的每次交互中OpenAI花费的计算成本为“个位数美分”，随着ChatGPT变得流行，每月的计算成本可能达到数百万美元。</p><p>大模型高昂的训练成本让普通创业公司难以为继，因此参与者基本都是科技巨头。</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://openai.com/blog/chatgpt/">ChatGPT: Optimizing Language Models for Dialogue</a></li><li><a href="https://arxiv.org/abs/2203.02155">Instruct GPT: Training language models to follow instructions with human feedback</a></li><li><a href="https://s3-us-west-2.amazonaws.com/openai-assets/research-covers/language-unsupervised/language_understanding_paper.pdf">GPT-1_Improving Language Understanding by Generative Pre-Training</a></li><li><a href="https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf">GPT-2_Language Models are Unsupervised Multitask Learners</a></li><li><a href="https://arxiv.org/abs/2005.14165">GPT-3_Language Models are Few-Shot Learners</a></li><li><a href="https://arxiv.org/abs/2109.01652">Instruct Learning_Finetuned Language Models Are Zero-Shot Learners</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2023/02/24/chatgpt/</id>
    <link href="https://v2grad.com/2023/02/24/chatgpt/"/>
    <published>2023-02-24T02:00:00.000Z</published>
    <summary>ChatGPT模型的三层理解，1）训练流程：白话讲解模型是怎么训练出来的；2）模型实现：基于论文讲解模型训练的细节；3）发展脉络：从模型演进的视角看其创新点和贡献。</summary>
    <title>ChatGPT模型的三层理解</title>
    <updated>2023-02-23T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="机器学习" scheme="https://v2grad.com/categories/machinelearning/"/>
    <category term="多模态学习" scheme="https://v2grad.com/tags/%E5%A4%9A%E6%A8%A1%E6%80%81%E5%AD%A6%E4%B9%A0/"/>
    <category term="MultiModal Learning" scheme="https://v2grad.com/tags/MultiModal-Learning/"/>
    <content>
      <![CDATA[<p>最早开始关注到多模态机器学习是看到Jeff Dean在2019年年底NeurIPS大会上的一个采访报道，讲到了2020年机器学习趋势：多任务和多模态学习将成为突破口。<br /><img src="https://static.v2grad.com/img/202211050831484.png" alt="Jeff Dean 谈2020年机器学习趋势：多任务和多模式学习将成为突破口" /><br />站在2022年，也正如他预言的一样，多模态学习在行业内越来越火爆。<br /><img src="https://static.v2grad.com/img/202211050837453.png" alt="多模态机器学习在Google Trends上的表现" /></p><h2 id="一-定义"><a class="markdownIt-Anchor" href="#一-定义"></a> 一、定义</h2><p>多模态机器学习，英文全称 MultiModal Machine Learning (MMML)</p><p>模态（modal）是事情经历和发生的方式，我们生活在一个由多种模态（Multimodal）信息构成的世界，包括视觉信息、听觉信息、文本信息、嗅觉信息等等，当研究的问题或者数据集包含多种这样的模态信息时我们称之为多模态问题，研究多模态问题是推动人工智能更好的了解和认知我们周围世界的关键。</p><p><img src="https://static.v2grad.com/img/202211051318189.png" alt="What is Mulimodel" /></p><h3 id="11-模态"><a class="markdownIt-Anchor" href="#11-模态"></a> 1.1 模态</h3><p><strong>模态是指一些表达或感知事物的方式，每一种信息的来源或者形式，都可以称为一种模态</strong>。例如，人有触觉，听觉，视觉，嗅觉；信息的媒介，有语音、视频、文字等；多种多样的传感器，如雷达、红外、加速度计等。以上的每一种都可以称为一种模态。</p><p><strong>相较于图像、语音、文本等多媒体(Multi-media)数据划分形式，“模态”是一个更为细粒度的概念，同一媒介下可存在不同的模态。</strong> 比如我们可以把两种不同的语言当做是两种模态，甚至在两种不同情况下采集到的数据集，亦可认为是两种模态。</p><h3 id="12-多模态"><a class="markdownIt-Anchor" href="#12-多模态"></a> 1.2 多模态</h3><p><strong>多模态即是从多个模态表达或感知事物。</strong> 多模态可归类为同质性的模态，例如从两台相机中分别拍摄的图片，异质性的模态，例如图片与文本语言的关系。</p><p><strong>多模态可能有以下三种形式：</strong></p><ul><li><strong>描述同一对象的多媒体数据</strong>。如互联网环境下描述某一特定对象的视频、图片、语音、文本等信息。下图即为典型的多模态信息形式。<br /><img src="https://static.v2grad.com/img/202211050816652.png" alt="“下雪”场景的多模态数据(图像、音频与文本)" /></li><li><strong>来自不同传感器的同一类媒体数据</strong>。如医学影像学中不同的检查设备所产生的图像数据， 包括B超(B-Scan ultrasonography)、计算机断层扫描(CT)、核磁共振等；物联网背景下不同传感器所检测到的同一对象数据等。</li><li><strong>具有不同的数据结构特点、表示形式的表意符号与信息</strong>。如描述同一对象的结构化、非结构化的数据单元；描述同一数学概念的公式、逻辑 符号、函数图及解释性文本；描述同一语义的词向量、词袋、知识图谱以及其它语义符号单元等。</li></ul><p>通常主要研究模态包括&quot;<strong>3V</strong>&quot;：即<strong>Verbal(文本)、Vocal(语音)、Visual(视觉)</strong>。<br />人跟人交流时的多模态：<br /><img src="https://static.v2grad.com/img/202211051318784.png" alt="multimodal communicative behaviors" /></p><h3 id="13-多模态学习"><a class="markdownIt-Anchor" href="#13-多模态学习"></a> 1.3 多模态学习</h3><p><strong>多模态机器学习</strong>是从多种模态的数据中学习并且提升自身的算法，它不是某一个具体的算法，它是一类算法的总称。</p><p>从<strong>语义感知</strong>的角度切入，多模态数据涉及<strong>不同的感知通道</strong>如视觉、听觉、触觉、嗅觉所接收到的信息;在<strong>数据层面</strong>理解，多模态数据则可被看作<strong>多种数据类型</strong>的组合，如图片、数值、文本、符号、音频、时间序列，或者集合、树、图等不同数据结构所组成的复合数据形式，乃至来自不同数据库、不同知识库的各种信息资源的组合。<strong>对多源异构数据的挖掘分析可被理解为多模态学习</strong>。</p><p><img src="https://static.v2grad.com/img/202211051125254.png" alt="多模态学习举例" /></p><h2 id="二-发展历史"><a class="markdownIt-Anchor" href="#二-发展历史"></a> 二、发展历史</h2><p><img src="https://static.v2grad.com/img/202211051008371.png" alt="多模态发展的四个时期" /></p><h3 id="21-行为时代"><a class="markdownIt-Anchor" href="#21-行为时代"></a> 2.1 行为时代</h3><blockquote><p>The “behavioral” era (1970s until late 1980s)，这一阶段主要从心理学的角度对多模态这一现象进行剖析。</p></blockquote><ul><li>Chicago 的McNeill 认为手势是说话人的思考行为，是言语表达的重要组成部分，而不仅仅是补足。</li><li>1976年的McGurk效应：当语音与唇形不符合时，大脑会脑补出中和的声音MCGURK, H., MACDONALD, J. Hearing lips and seeing voices. Nature 264, 746–748 (1976). <a href="https://www.futilitycloset.com/2019/05/30/the-mcgurk-effect/">The McGurk Effect Video</a></li></ul><h3 id="22-计算时代"><a class="markdownIt-Anchor" href="#22-计算时代"></a> 2.2 计算时代</h3><blockquote><p>The “computational” era (late 1980s until 2000)，这一阶段主要利用一些浅层的模型对多模态问题进行研究，其中代表性的应用包括视觉语音联合识别，多模态情感计算等等。</p></blockquote><ul><li><p>视频音频语音识别(AVSR)，在声音的低信噪比下，引入视觉信号能够极大提升识别准确率<br /><img src="https://static.v2grad.com/img/202211051037668.png" alt="AVSR" /></p></li><li><p>多模态/多感知接口：情感计算：与情感或其他情感现象有关、源于情感或有意影响情感的计算[Rosalind Picard]</p></li><li><p>多媒体计算：CMU曾有过信息媒体数字视频库项目[1994-2010]，</p></li></ul><h3 id="23-交互时代"><a class="markdownIt-Anchor" href="#23-交互时代"></a> 2.3 交互时代</h3><blockquote><p>The “interaction” era (2000 - 2010)，这一阶段主要主要从交互的角度入手，研究多模态识别问题，其中主要的代表作品包括苹果的语音助手Siri等。</p></blockquote><p>拟人类多模态交互过程</p><ul><li><p>IDIAP实验室的AMI项目[2001-2006]，记录会议录音、同步音频视频、转录与注释；</p></li><li><p>Alex Waibel的CHIL项目，将计算机置于人类交互圈中，多传感器多模态信号处理，面对面交互<br /><img src="https://static.v2grad.com/img/202211051034371.png" alt="IMI Projet &amp; CHIL Project" /></p></li><li><p>2003-2008 SRI的学习和组织认知助手，个性化助手，Siri就是这个项目的衍生产品</p></li><li><p>2008-2011 IDIAP的社交信号处理网络，数据库http://sspnet.eu。<br /><img src="https://static.v2grad.com/img/202211051034148.png" alt="CALO Project &amp; SSP Project" /></p></li></ul><h3 id="24-深度学习时代"><a class="markdownIt-Anchor" href="#24-深度学习时代"></a> 2.4 深度学习时代</h3><blockquote><p>The “deep learning” era (2010s until …)，促使多模态研究发展的关键促成因素有4个，1）新的大规模多模态数据集，2）GPU快速计算，3）强大的视觉特征抽取能力，4）强大的语言特征抽取能力。</p></blockquote><p>表示学习三篇参考文献</p><ul><li>Multimodal Deep Learning [ICML 2011]</li><li>Multimodal Learning with Deep Boltzmann Machines [NIPS 2012]</li><li>Visual attention: Show, Attend and Tell: Neural Image Caption Generation with Visual Attention [ICML 2015]</li></ul><h2 id="三-典型任务"><a class="markdownIt-Anchor" href="#三-典型任务"></a> 三、典型任务</h2><h3 id="31-跨模态预训练"><a class="markdownIt-Anchor" href="#31-跨模态预训练"></a> 3.1 跨模态预训练</h3><ul><li>图像/视频与语言预训练。</li><li>跨任务预训练</li></ul><h3 id="32-language-audio"><a class="markdownIt-Anchor" href="#32-language-audio"></a> 3.2 Language-Audio</h3><ul><li>Text-to-Speech Synthesis: 给定文本，生成一段对应的声音。</li><li>Audio Captioning：给定一段语音，生成一句话总结并描述主要内容。(不是语音识别)</li></ul><h3 id="33-vision-audio"><a class="markdownIt-Anchor" href="#33-vision-audio"></a> 3.3 Vision-Audio</h3><ul><li>Audio-Visual Speech Recognition(视听语音识别)：给定某人的视频及语音进行语音识别。</li><li>Video Sound Separation(视频声源分离)：给定视频和声音信号(包含多个声源)，进行声源定位与分离。</li><li>Image Generation from Audio: 给定声音，生成与其相关的图像。</li><li>Speech-conditioned Face generation：给定一段话，生成说话人的视频。</li><li>Audio-Driven 3D Facial Animation：给定一段话与3D人脸模版，生成说话的人脸3D动画。</li></ul><h3 id="34-vision-language"><a class="markdownIt-Anchor" href="#34-vision-language"></a> 3.4 Vision-Language</h3><ul><li>Image/Video-Text Retrieval (图(视频)文检索): 图像/视频&lt;–&gt;文本的相互检索。</li><li>Image/Video Captioning(图像/视频描述)：给定一个图像/视频，生成文本描述其主要内容。</li><li>Visual Question Answering(视觉问答)：给定一个图像/视频与一个问题，预测答案。</li><li>Image/Video Generation from Text：给定文本，生成相应的图像或视频。</li><li>Multimodal Machine Translation：给定一种语言的文本与该文本对应的图像，翻译为另外一种语言。</li><li>Vision-and-Language Navigation(视觉-语言导航)： 给定自然语言进行指导，使得智能体根据视觉传感器导航到特定的目标。</li><li>Multimodal Dialog(多模态对话)： 给定图像，历史对话，以及与图像相关的问题，预测该问题的回答。</li></ul><h3 id="35-定位相关的任务"><a class="markdownIt-Anchor" href="#35-定位相关的任务"></a> 3.5 定位相关的任务</h3><ul><li>Visual Grounding：给定一个图像与一段文本，定位到文本所描述的物体。</li><li>Temporal Language Localization: 给定一个视频即一段文本，定位到文本所描述的动作(预测起止时间)。</li><li>Video Summarization from text query：给定一段话(query)与一个视频，根据这段话的内容进行视频摘要，预测视频关键帧(或关键片段)组合为一个短的摘要视频。</li><li>Video Segmentation from Natural Language Query: 给定一段话(query)与一个视频，分割得到query所指示的物体。</li><li>Video-Language Inference: 给定视频(包括视频的一些字幕信息)，还有一段文本假设(hypothesis)，判断二者是否存在语义蕴含(二分类)，即判断视频内容是否包含这段文本的语义。</li><li>Object Tracking from Natural Language Query: 给定一段视频和一些文本，追踪视频中文本所描述的对象。</li><li>Language-guided Image/Video Editing: 一句话自动修图。给定一段指令(文本)，自动进行图像/视频的编辑。</li></ul><h3 id="36-更多模态"><a class="markdownIt-Anchor" href="#36-更多模态"></a> 3.6 更多模态</h3><ul><li>Affect Computing (情感计算)：使用语音、视觉(人脸表情)、文本信息、心电、脑电等模态进行情感识别。</li><li>Medical Image：不同医疗图像模态如CT、MRI、PETRGB-D模态：RGB图与深度图</li></ul><h2 id="四-技术挑战"><a class="markdownIt-Anchor" href="#四-技术挑战"></a> 四、技术挑战</h2><p><img src="https://static.v2grad.com/img/202211051339734.png" alt="多模态学习的技术挑战" /></p><h3 id="41-表征representation"><a class="markdownIt-Anchor" href="#41-表征representation"></a> 4.1 表征Representation</h3><p>第一个基本挑战是学习如何以<strong>利用多种模态的互补性和冗余性的方式表示和总结多模态数据</strong>。多模态数据的异质性使得构建这样的表示具有挑战性。例如，语言通常是象征性的，而音频和视觉形式将被表示为信号。</p><p>单模态的表征负责将信息表示为计算机可以处理的数值向量或者进一步抽象为更高层的特征向量，而多模态表征是指通过利用多模态之间的互补性，剔除模态间的冗余性，从而学习到更好的特征表示。</p><p><img src="https://static.v2grad.com/img/202211051431550.png" alt="Representation" /></p><h4 id="411-联合表征"><a class="markdownIt-Anchor" href="#411-联合表征"></a> 4.1.1 联合表征</h4><p>联合表征（Joint Representation）将多个模态的信息一起映射到一个统一的多模态向量空间，Joint结构注重捕捉多模态的<strong>互补性</strong>，融合多个输入模态<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>x</mi><mn>1</mn></msub><mo separator="true">,</mo><msub><mi>x</mi><mn>2</mn></msub></mrow><annotation encoding="application/x-tex">x_1,x_2</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">2</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>获得多模态表征<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>x</mi><mi>m</mi></msub><mo>=</mo><mi>f</mi><mo stretchy="false">(</mo><msub><mi>x</mi><mn>1</mn></msub><mo separator="true">,</mo><mi mathvariant="normal">.</mi><mi mathvariant="normal">.</mi><mi mathvariant="normal">.</mi><mo separator="true">,</mo><msub><mi>x</mi><mi>n</mi></msub><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">x_m=f(x_1,...,x_n)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.151392em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">m</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord mathdefault" style="margin-right:0.10764em;">f</span><span class="mopen">(</span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord">.</span><span class="mord">.</span><span class="mord">.</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.151392em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">n</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose">)</span></span></span></span>，进而使<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>x</mi><mi>m</mi></msub></mrow><annotation encoding="application/x-tex">x_m</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.151392em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">m</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>完成某种预测任务。<br /><img src="https://static.v2grad.com/img/202211052136742.png" alt="Joint Representation" /></p><p><strong>Multimodal learning with deep boltzmann machines (NIPS 2012)</strong> 提出将 deep boltzmann machines（DBM） 结构扩充到多模态领域，通过 Multimodal DBM，可以学习到多模态的联合概率分布。<br /><img src="https://static.v2grad.com/img/202211051458819.png" alt="Multimodal DBM 模型" /></p><p>在获得图像与文本间的联合概率分布后，我们在应用阶段，输入图片，利用条件概率 P(文本|图片)，生成文本特征，可以得到图片相应的文本描述；而输入文本，利用条件概率 P(图片|文本)，可以生成图片特征，通过检索出最靠近该特征向量的两个图片实例，可以得到符合文本描述的图片。</p><p><img src="https://static.v2grad.com/img/202211051506598.png" alt="Multimodal DBM 应用" /></p><h4 id="412-协同表征"><a class="markdownIt-Anchor" href="#412-协同表征"></a> 4.1.2 协同表征</h4><p>协同表征（Coordinated Representation）将多模态中的每个模态分别映射到各自的表示空间，但映射后的向量之间满足一定的相关性约束（例如线性相关）。Coordinated结构并不寻求融合而是建模多种模态数据间的<strong>相关性</strong>，它将多个(通常是两个)模态映射到协作空间，表示为：<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>f</mi><mo stretchy="false">(</mo><msub><mi>x</mi><mn>1</mn></msub><mo stretchy="false">)</mo><mi mathvariant="normal">～</mi><mi>g</mi><mo stretchy="false">(</mo><msub><mi>x</mi><mn>2</mn></msub><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">f(x_1) ～ g(x_2)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord mathdefault" style="margin-right:0.10764em;">f</span><span class="mopen">(</span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose">)</span><span class="mord cjk_fallback">～</span><span class="mord mathdefault" style="margin-right:0.03588em;">g</span><span class="mopen">(</span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">2</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose">)</span></span></span></span>，其中～表示一种协作关系。网络的优化目标是这种协作关系(通常是相似性，即最小化cosine距离等度量)。<br /><img src="https://static.v2grad.com/img/202211052203950.png" alt="Coordinated Representation" /></p><p><strong>Unifying Visual-Semantic Embeddings with Multimodal Neural Language Models (NIPS 2014)</strong> 利用协同学习到的特征向量之间满足加减算数运算这一特性，可以搜索出与给定图片满足“<strong>指定的转换语义</strong>”的图片。例如：狗的图片特征向量 - 狗的文本特征向量 + 猫的文本特征向量 = 猫的图片特征向量 -&gt; 在特征向量空间，根据最近邻距离，检索得到猫的图片。<br /><img src="https://static.v2grad.com/img/202211090619157.png" alt="多模态向量空间运算" /></p><h3 id="42-翻译translation"><a class="markdownIt-Anchor" href="#42-翻译translation"></a> 4.2 翻译Translation</h3><p>第二个挑战涉及<strong>如何将数据从一种模式转化（映射）到另一种模式</strong>。不仅数据是异构的，而且模态之间的关系通常是开放式的或主观的。例如，存在多种描述图像的正确方法，并且可能不存在一种完美的翻译。</p><h4 id="421-常见应用"><a class="markdownIt-Anchor" href="#421-常见应用"></a> 4.2.1 常见应用</h4><ul><li><strong>机器翻译（Machine Translation）</strong>：将输入的语言A（即时）翻译为另一种语言B。类似的还有唇读（Lip Reading）和语音翻译 （Speech Translation），分别将唇部视觉和语音信息转换为文本信息。</li><li><strong>图片描述（Image captioning) 或者视频描述（Video captioning)</strong>： 对给定的图片/视频形成一段文字描述，以表达图片/视频的内容。</li><li><strong>语音合成（Speech Synthesis）</strong>：根据输入的文本信息，自动合成一段语音信号。</li></ul><p><img src="https://static.v2grad.com/img/202211051434189.png" alt="Translation" /></p><h4 id="422-基于实例的方法"><a class="markdownIt-Anchor" href="#422-基于实例的方法"></a> 4.2.2 基于实例的方法</h4><p>基于实例的方法从词典中<strong>检索</strong>最佳翻译，词典一般指训练集中的数据对<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mo fence="true">{</mo><mrow><mo fence="true">(</mo><msub><mi>x</mi><mn>1</mn></msub><mo separator="true">,</mo><msub><mi>y</mi><mn>1</mn></msub><mo fence="true">)</mo></mrow><mo separator="true">,</mo><mo>…</mo><mo separator="true">,</mo><mrow><mo fence="true">(</mo><msub><mi>x</mi><mi>N</mi></msub><mo separator="true">,</mo><msub><mi>y</mi><mi>N</mi></msub><mo fence="true">)</mo></mrow><mo fence="true">}</mo></mrow><annotation encoding="application/x-tex">\left\{\left(x_1, y_1\right), \ldots,\left(x_N, y_N\right)\right\}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">{</span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner">…</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.32833099999999993em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.32833099999999993em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span><span class="mclose delimcenter" style="top:0em;">}</span></span></span></span></span>。给定测试样本<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mover accent="true"><mi>x</mi><mo>^</mo></mover></mrow><annotation encoding="application/x-tex">\hat x</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.69444em;vertical-align:0em;"></span><span class="mord accent"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord mathdefault">x</span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.22222em;">^</span></span></span></span></span></span></span></span></span>，模版法直接检索在词典中找到最匹配的翻译结果<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>y</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">y_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>，并将其作为最终输出。<br /><strong>检索可分为单模态检索或跨模态检索</strong>：</p><ul><li><strong>单模态检索</strong>首先找到与<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mover accent="true"><mi>x</mi><mo>^</mo></mover></mrow><annotation encoding="application/x-tex">\hat x</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.69444em;vertical-align:0em;"></span><span class="mord accent"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord mathdefault">x</span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.22222em;">^</span></span></span></span></span></span></span></span></span>最相似的<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>x</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">x_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>，然后获得<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>x</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">x_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>对应的<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>y</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">y_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>；</li><li><strong>多模态检索</strong>直接在<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mo fence="true">{</mo><msub><mi>y</mi><mn>1</mn></msub><mo separator="true">,</mo><mo>…</mo><mo separator="true">,</mo><msub><mi>y</mi><mi>N</mi></msub><mo fence="true">}</mo></mrow><annotation encoding="application/x-tex">\left\{y_1, \ldots, y_N\right\}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">{</span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner">…</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.32833099999999993em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">}</span></span></span></span></span>集合中检索到与<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mover accent="true"><mi>x</mi><mo>^</mo></mover></mrow><annotation encoding="application/x-tex">\hat x</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.69444em;vertical-align:0em;"></span><span class="mord accent"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord mathdefault">x</span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.22222em;">^</span></span></span></span></span></span></span></span></span>最相似的<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>y</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">y_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>，性能通常优于单模态检索。</li></ul><p>为进一步增强检索结果的准确性，可选择top-K的检索结果<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mo fence="true">{</mo><msub><mi>y</mi><msub><mi>i</mi><mn>1</mn></msub></msub><mo separator="true">,</mo><msub><mi>y</mi><msub><mi>i</mi><mn>2</mn></msub></msub><mo separator="true">,</mo><mo>…</mo><mo separator="true">,</mo><msub><mi>y</mi><msub><mi>i</mi><mi>k</mi></msub></msub><mo fence="true">}</mo></mrow><annotation encoding="application/x-tex">\left\{y_{i_1}, y_{i_2}, \ldots, y_{i_k}\right\}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1.00586em;vertical-align:-0.25586em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">{</span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31731428571428577em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2501em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31731428571428577em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight">2</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2501em;"><span></span></span></span></span></span></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner">…</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.55em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3448em;"><span style="top:-2.3487714285714287em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mathdefault mtight" style="margin-right:0.03148em;">k</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15122857142857138em;"><span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.25586em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">}</span></span></span></span></span>，再融合K个结果作为最终输出。</p><h4 id="423-模型驱动的方法"><a class="markdownIt-Anchor" href="#423-模型驱动的方法"></a> 4.2.3 模型驱动的方法</h4><p>基于模型的首先在字典上训练一个翻译模型，然后使用该模型进行翻译。</p><ul><li><p><strong>基于语法的模型（Grammar-based models）</strong><br />即人为设定多个针对目标模态的语法<strong>模版</strong>，将模型的预测结果插入模版中作为翻译结果。以图像描述为例，模版定义为<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mtext> </mtext><munder accentunder="true"><mtext>who</mtext><mo stretchy="true">‾</mo></munder><mtext> did </mtext><munder accentunder="true"><mtext>what</mtext><mo stretchy="true">‾</mo></munder><mtext> to </mtext><munder accentunder="true"><mtext>whom</mtext><mo stretchy="true">‾</mo></munder><mtext> in a </mtext><munder accentunder="true"><mtext>place</mtext><mo stretchy="true">‾</mo></munder><mtext> </mtext></mrow><annotation encoding="application/x-tex">\text { \underline{who} did \underline{what} to \underline{whom} in a \underline{place} }</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1.08888em;vertical-align:-0.39444em;"></span><span class="mord text"><span class="mord"> </span><span class="mord underline"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-2.84em;"><span class="pstrut" style="height:3em;"></span><span class="underline-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord">w</span><span class="mord">h</span><span class="mord">o</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.20000000000000007em;"><span></span></span></span></span></span><span class="mord"> did </span><span class="mord underline"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-2.84em;"><span class="pstrut" style="height:3em;"></span><span class="underline-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord">w</span><span class="mord">h</span><span class="mord">a</span><span class="mord">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.20000000000000007em;"><span></span></span></span></span></span><span class="mord"> to </span><span class="mord underline"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-2.84em;"><span class="pstrut" style="height:3em;"></span><span class="underline-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord">w</span><span class="mord">h</span><span class="mord">o</span><span class="mord">m</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.20000000000000007em;"><span></span></span></span></span></span><span class="mord"> in a </span><span class="mord underline"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.6944399999999998em;"><span style="top:-2.64556em;"><span class="pstrut" style="height:3em;"></span><span class="underline-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord">p</span><span class="mord">l</span><span class="mord">a</span><span class="mord">c</span><span class="mord">e</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.39444em;"><span></span></span></span></span></span><span class="mord"> </span></span></span></span></span>，其中有四个待替换的插槽。通过不同类型的目标/属性/场景检测器可以获得who, what, whom, place等具体单词，进而完成翻译。</p></li><li><p><strong>编码-解码器模型（Encoder-decoder models）</strong><br />首先将源模态的数据编码为<strong>隐特征</strong><span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>z</mi></mrow><annotation encoding="application/x-tex">z</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.43056em;vertical-align:0em;"></span><span class="mord mathdefault" style="margin-right:0.04398em;">z</span></span></span></span>，后续被解码器用于生成目标模态。以图像描述为例，编码器(一般为CNN+spatial pooling)将图像编码为一个或多个特征向量，进而输入到RNN中以自回归的方式生成单词序列。</p></li><li><p><strong>连续型生成模型（Continuous generation models）</strong><br />它针对源模态与目标模态都为流数据且在时间上严格<strong>对齐</strong>的任务。以文本合成语音为例，它与图像描述不同，语音数据与文本数据在时间上严格对齐。WaveNet采用了CNN并行预测解决该类问题，当然，编码-解码器理论上也可完成该任务，但需处理数据对齐问题。</p></li></ul><h4 id="424-翻译的评估困境"><a class="markdownIt-Anchor" href="#424-翻译的评估困境"></a> 4.2.4 翻译的评估困境</h4><p>多模态翻译方法面临的一个主要挑战是它们很难评估。语音识别等任务只有一个正确的翻译，而语音合成和媒体描述等任务则没有。有时，就像在语言翻译中，多重答案是正确的，决定哪个翻译更好往往是主观的。</p><ul><li><strong>人工评价</strong>是最理想的评估，但是耗时耗钱，且需要多样化打分人群的背景以避免偏见。</li><li><strong>自动化指标</strong>是视觉描述领域常用的替代方法，包括BLEU，Meteor，CIDEr，ROUGE等，但它们被证实与人的评价相关性较弱。</li><li><strong>基于检索的评估</strong>和<strong>弱化任务</strong>(例如：将图像描述中一对多映射简化为VQA中一对一的映射)也是解决评估困境的手段。</li></ul><h3 id="43-对齐alignment"><a class="markdownIt-Anchor" href="#43-对齐alignment"></a> 4.3 对齐Alignment</h3><p>第三个挑战是从<strong>两种或多种不同的模态中识别（子）元素之间的直接关系</strong>。例如，我们可能希望将食谱中的步骤与显示正在制作的菜肴的视频对齐。为了应对这一挑战，我们需要测量不同模式之间的相似性并处理可能的长期依赖和歧义。</p><p><img src="https://static.v2grad.com/img/202211051433591.png" alt="Alignment" /></p><h4 id="431-显式对齐"><a class="markdownIt-Anchor" href="#431-显式对齐"></a> 4.3.1 显式对齐</h4><p>如果模型的<strong>主要目标是对齐来自两个或多个模态的子元素</strong>，那么我们将其分类为执行显式对齐。显式对齐的一个重要工作是<strong>相似性度量</strong>。大多数方法都依赖于度量不同模态的子组件之间的相似性作为基本构建块。<br /><img src="https://static.v2grad.com/img/202211071349090.png" alt="显式对齐" /></p><p>包括无监督和弱监督的方法：</p><ul><li><strong>无监督对齐</strong>：给定两个模态的数据作为输入，希望模型实现子元素的对齐，但是训练数据没有“对齐结果”的标注，模型需要同时学习相似度度量和对齐方式。</li><li><strong>有监督对齐</strong>：有监督方法存在标注，可训练模型学习相似度度量。</li></ul><h4 id="432-隐式对齐"><a class="markdownIt-Anchor" href="#432-隐式对齐"></a> 4.3.2 隐式对齐</h4><p>隐式对齐<strong>用作另一个任务的中间(通常是潜在的)步骤。</strong> 这允许在许多任务中有更好的表现，包括语音识别、机器翻译、媒体描述和视觉问题回答。这些模型不显式地对齐数据，也不依赖于监督对齐示例，而是学习如何在模型训练期间潜在地对齐数据。</p><p><img src="https://static.v2grad.com/img/202211071428784.png" alt="隐式对齐" /></p><h3 id="44-融合fusion"><a class="markdownIt-Anchor" href="#44-融合fusion"></a> 4.4 融合Fusion</h3><p>第四个挑战是<strong>结合来自两个或多个模态的信息</strong>来执行预测。例如，对于视听语音识别，将嘴唇运动的视觉描述与语音信号融合以预测口语。来自不同模态的信息可能具有不同的预测能力和噪声拓扑，并且可能在至少一种模态中丢失数据。</p><p><img src="https://static.v2grad.com/img/202211051435164.png" alt="Fusion" /></p><p><img src="https://static.v2grad.com/img/202211051436546.png" alt="Fusion" /></p><h4 id="441-模型无关的方法"><a class="markdownIt-Anchor" href="#441-模型无关的方法"></a> 4.4.1 模型无关的方法</h4><ul><li><strong>早期融合（Early Fusion）</strong>：指在模型的浅层(或输入层)将多个模态的特征拼接起来，然后再级联深度网络结构，最后接上分类器或其他模型。Early Fusion 是学者对多模态融合的早期尝试，通过将各模态的底层特征进行融合学习相关性，由于只需要训练一个共同的模型，复杂度可控。但是，由于多个模态的数据来源不一致，会给<strong>拼接造成很大的难度</strong>，并且直接对原始数据进行拼接会引起较大的特征维度，对<strong>数据预处理也非常敏感</strong>。</li><li><strong>晚期融合（Late Fusion）</strong>：独立训练多个模型，在预测层(最后一层)进行融合，可以理解为集成方法 Ensemble Methods 的一种。Late Fusion 方式的各模态单独处理，特征独立互不影响，即使某个模态信息丢失也可以正常训练，具有很强的灵活性。但是，该方式没有充分利用模态间底层特征的相关性，并且由于涉及多个模态的分别训练，也会带来<strong>较大的计算复杂度</strong>。</li><li><strong>混合融合（Hybird Fusion）</strong>：同时结合前融合和后融合，以及在模型中间层进行特征交互。Hybird Fusion是一种<strong>逐级融合方式</strong>，在不同层级上依次对不同模态进行融合，综合了上述两种方式的优点，既利用了模态间信息的相关性，也具有一定的灵活性，目前大部分多模态融合都是采用这种方法。</li></ul><h4 id="442-基于模型的方法"><a class="markdownIt-Anchor" href="#442-基于模型的方法"></a> 4.4.2 基于模型的方法</h4><ul><li><strong>Deep Neural Networks</strong>：神经网络进行端到端的训练，使用LSTM、卷积层、注意力层、门机制、双线性融合等设计序列数据或图像数据的复杂交互。</li><li><strong>Multiple Kernel learning</strong>：多核学习（将不同的核用于不同的数据模态/视图）</li><li><strong>Graphical models</strong>：利用隐马尔可夫模型或贝叶斯网络建模数据的联合概率分布(生成式)或条件概率(判别式)</li></ul><h3 id="45-协同学习co-learning"><a class="markdownIt-Anchor" href="#45-协同学习co-learning"></a> 4.5 协同学习Co-learning</h3><p>第五个挑战是在模态的表示和它们的预测模型之间转移知识。协同学习探索了<strong>从一种模态中学习的知识如何帮助在不同模态上训练的计算模型</strong>。当其中一种模式的资源有限（例如，带注释的数据）时，这一挑战尤其重要。辅助模态（helper modality）通常只参与模型的训练过程，并不参与模型的测试使用过程</p><p><img src="https://static.v2grad.com/img/202211051437074.png" alt="Co-learning" /></p><h4 id="451-并行"><a class="markdownIt-Anchor" href="#451-并行"></a> 4.5.1 并行</h4><p>需要训练数据集，其中来自一种模态的观察结果与来自其他模态的观察结果直接相关，例如在一个视听语音数据集中，视频和语音样本来自同一个说话者。</p><h4 id="452-非并行"><a class="markdownIt-Anchor" href="#452-非并行"></a> 4.5.2 非并行</h4><p>不需要来自不同模式的观察结果之间的直接联系，通常通过使用类别重叠来实现共同学习，例如，在零样本学习中，使用来自Wikipedia的纯文本数据集扩展传统的视觉对象识别数据集以改进视觉对象识别的泛化能力。</p><h4 id="453-混合"><a class="markdownIt-Anchor" href="#453-混合"></a> 4.5.3 混合</h4><p>通过共享模式或数据集桥接</p><h2 id="五-sota模型-clip"><a class="markdownIt-Anchor" href="#五-sota模型-clip"></a> 五、SOTA模型 - CLIP</h2><p>CLIP全称Contrastive Language-Image Pre-training，是OpenAI最新的一篇NLP和CV结合的多模态的工作，在多模态领域迈出了重要的一步。<strong>CLIP在无需利用ImageNet的数据和标签进行训练的情况下，就可以达到ResNet50在ImageNet数据集上有监督训练的结果。</strong></p><p><img src="https://static.v2grad.com/img/202211081504107.png" alt="CLIP Zero shot" /></p><p>CLIP主要的贡献就是利用无监督的文本信息，作为监督信号来学习视觉特征。</p><h3 id="51-原理"><a class="markdownIt-Anchor" href="#51-原理"></a> 5.1 原理</h3><p><strong>CLIP不预先定义图像和文本标签类别</strong>，直接利用从互联网爬取的 400 million 个image-text pair 进行图文匹配任务的训练，并将其成功迁移应用于30个现存的计算机视觉分类。</p><p><img src="https://static.v2grad.com/img/202211081512646.png" alt="语义标签" /></p><h3 id="52-流程"><a class="markdownIt-Anchor" href="#52-流程"></a> 5.2 流程</h3><ul><li><strong>Contrastive pre-training</strong>：预训练阶段，使用图片 - 文本对进行对比学习训练；</li><li><strong>Create dataset classifier from label text</strong>：提取预测类别文本特征;</li><li><strong>Use for zero-shot predictiion</strong>：进行 Zero-Shoot 推理预测;</li></ul><p><img src="https://static.v2grad.com/img/202211081515556.png" alt="Contrastive pre-training" /></p><p><img src="https://static.v2grad.com/img/202211081516232.png" alt="Zero-shot" /></p><p><strong>阶段1：Contrastive pre-training</strong><br />在预训练阶段，对比学习十分灵活，只需要定义好 正样本对 和 负样本对 就行了，其中能够配对的 image-text 对即为正样本。具体来说，先分别对图像和文本提特征，这时图像对应生成 I1、I2 … In 的特征向量（Image Feature），文本对应生成 T1、T2 … Tn 的特征向量（Text Feature），中间对角线为正样本，其余均为负样本。</p><p><strong>阶段2：Create dataset classifier from label text</strong><br />基于400M数据上学得的先验，仅用数据集的标签文本，就可以得到很强的图像分类性能。现在训练好了，然后进入前向预测阶段，通过 prompt label text 来创建待分类的文本特征向量。</p><p><strong>阶段3：Use for zero-shot predictiion</strong><br />最后就是推理见证效果的时候，对于测试图片，选择相似度最大的那个类别输出。在推理阶段，无论来了张什么样的图片，只要扔给 Image Encoder 进行特征提取，会生成一个一维的图片特征向量，然后拿这个图片特征和 N 个文本特征做余弦相似度对比，最相似的即为想要的那个结果，比如这里应该会得到 “A photo of a guacamole.”，</p><h3 id="53-实现"><a class="markdownIt-Anchor" href="#53-实现"></a> 5.3 实现</h3><p><img src="https://static.v2grad.com/img/202211081543158.png" alt="Numpy-like pseudocode for the core of an implementation of CLIP." /></p><h3 id="54-后续"><a class="markdownIt-Anchor" href="#54-后续"></a> 5.4 后续</h3><p><strong>StyleCLIP: Text-Driven Manipulation of StyleGAN Imagery (ICCV 2021 Oral)</strong><br />StyleCLIP是结合CLIP和StyleGAN的一个工作，通过文字上的改变，从而去引导图像的生成。<br /><a href="https://github.com/orpatashnik/StyleCLIP">https://github.com/orpatashnik/StyleCLIP</a><br /><img src="https://static.v2grad.com/img/202211100602961.gif" alt="StyleCLIP 例子" /></p><p><img src="https://static.v2grad.com/img/202211100600578.png" alt="StyleCLIP 例子" /></p><p><strong>CLIPDraw: Exploring Text-to-Drawing Synthesis through Language-Image Encoders</strong><br />CLIPDraw也是利用文字来指导图像生成的一个工作，只是想法更加简单，不需要进行模型训练，而是使用预训练的 CLIP 语言图像编码器作为度量，以最大化给定描述和生成的绘图之间的相似性，最后就可以生成很多简笔画的图像。<br /><img src="https://static.v2grad.com/img/202211100613302.png" alt="CLIPDraw" /></p><p><strong>ViLD: Open-vocabulary Object Detection via Vision and Language Knowledge Distillation / Google</strong><br />用CLIP来做物体检测和分割的任务，在CLIP出来一个月半月以后，Google就出了这篇文章。<br />作者指出，如果你用传统的物体检测方法，算法只能告诉你这些只是玩具，也就是下图蓝色的base categories，但是当你利用了这种自然语言之后，你就摆脱了基础类的这个限制，就可以检测出来新的类，也就是红色的noval categories。<br /><img src="https://static.v2grad.com/img/202211100622320.png" alt="ViLD" /></p><p><strong>CLIPasso: Semantically-Aware Object Sketching (SIGGRAPH 2022 Best Paper Award)</strong><br />用CLIP提炼语义概念，生成图片目标的高度抽象线条画(速写)<br /><img src="https://static.v2grad.com/img/202211100641357.png" alt="CLIPasso" /></p><p><strong>应用：Contrastive Language-Image Forensic Search</strong><br /><a href="https://github.com/johanmodin/clifs">https://github.com/johanmodin/clifs</a><br />使用CLIP完成视频检索，看一个视频里面有没有出现过一个人或者一些场景，通过直接输入文本的这种形式进行检索。</p><p>A truck with the text “odwalla”<br /><img src="https://static.v2grad.com/img/202211100631474.png" alt="A truck with the text &quot;odwalla&quot;" /></p><p>A white BMW car<br /><img src="https://static.v2grad.com/img/202211100631176.png" alt="A white BMW car" /></p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><p>[1]<a href="http://cje.ustb.edu.cn/cn/article/doi/10.13374/j.issn2095-9389.2019.03.21.003">多模态学习方法综述 / 陈鹏 / 工程科学学报 / 2019</a><br />[2]<a href="https://arxiv.org/abs/1705.09406">Multimodal Machine Learning: A Survey and Taxonomy / Tadas Baltrusaitis / 2017</a><br />[3]<a href="https://cmu-multicomp-lab.github.io/mmml-course/fall2020/">MultiModal Machine Learning / Louis-Philippe Morency / CMU</a><br />[4]<a href="https://zhuanlan.zhihu.com/p/543537800">CMU-10707 第二十一讲 多模态机器学习 / 华年ss / 知乎</a><br />[5]<a href="https://jmlr.org/papers/volume15/srivastava14b/srivastava14b.pdf">Multimodal Learning with Deep Boltzmann Machines / Nitish Srivastava / 2012</a><br />[6]<a href="https://zhuanlan.zhihu.com/p/389287751?utm_campaign=shareopn&amp;utm_medium=social&amp;utm_oi=27272153137152&amp;utm_psn=1572265674642264064&amp;utm_source=wechat_session">多模态学习综述及最新方向 / yougeii​ / 知乎</a><br />[7]<a href="https://arxiv.org/pdf/2103.00020.pdf">Learning transferable visual models from natural language supervision / 2021</a><br />[8]<a href="https://openai.com/blog/clip/">CLIP: Connecting Text and Images / openai / blog</a><br />[9]<a href="https://github.com/yzhuoning/Awesome-CLIP">Awesome-CLIP / yzhuoning</a></p>]]>
    </content>
    <id>https://v2grad.com/2022/10/27/multimodal-learning/</id>
    <link href="https://v2grad.com/2022/10/27/multimodal-learning/"/>
    <published>2022-10-26T16:00:00.000Z</published>
    <summary>吴恩达日前在DeepLearning.AI平台分享了2022年AI趋势预测，第一就是多模态AI将起飞。本文介绍多模态机器学习的定义、发展历史、主要任务和挑战，以及目前SOTA的CLIP模型。</summary>
    <title>多模态学习(MultiModal Learning)</title>
    <updated>2026-11-13T09:01:05.227Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="思维精进" scheme="https://v2grad.com/categories/thinking/"/>
    <category term="认知" scheme="https://v2grad.com/tags/%E8%AE%A4%E7%9F%A5/"/>
    <content>
      <![CDATA[<p>张一鸣说：对事情的认知是最关键的，你对事情的理解，就是你在这件事情上的竞争力，因为理论上其他的生产要素都可以构建。</p><p>傅盛说：人与人最大的差别是认知！</p><p><img src="https://static.v2grad.com/img/202208201754770.png" alt="认知百度趋势" /></p><p>认知这个词最近几年特别火，越来越多的自媒体喜欢拿这个词来炒作，说认知的最高境界是看透本质，就是要具备上帝思维，要像上帝一样思考，洞悉宇宙规律，顺从自然法则，尊重人性善恶。但认知到底是什么意思？它决定的是什么？怎么提升认知呢？</p><h2 id="一-认知是什么"><a class="markdownIt-Anchor" href="#一-认知是什么"></a> 一、认知是什么</h2><p>认知这个词来自拉丁词根cognoscere，意思是“<strong>知道</strong>”。当我们谈论到认知，我们通常指的是与知识相关的一切，即我们已经通过学习和经验获得的资料的积累。认知公认的定义是<strong>通过感知处理信息的能力</strong>（即我们通过不同的感官得到刺激），是获得知识的重要过程，而我们的主观特征，使我们能够整合所有这些信息分析和解释我们的世界。</p><h3 id="11-认知过程"><a class="markdownIt-Anchor" href="#11-认知过程"></a> 1.1 认知过程</h3><p>认知，是指人们获得知识或应用知识的过程，或信息加工的过程，这是人的最基本的心理过程。它包括感觉、知觉、记忆、思维、想象和语言等。人脑接受外界输入的<strong>信息</strong>，经过头脑的<strong>加工处理</strong>，转换成内在的<strong>心理活动</strong>，进而支配人的<strong>行为</strong>，这个过程就是<strong>信息加工的过程</strong>，也就是<strong>认知过程</strong>。</p><p><img src="https://static.v2grad.com/img/202208201806114.png" alt="认知过程" /></p><p>人的认知能力与人的认识过程是密切相关的，可以说认知是人的认识过程的一种产物。一般说来，人们对客观事物的感知（感觉、知觉）、思维（想象、联想、思考）等都是认识活动。认识过程是主观客观化的过程，即主观反映客观，使客观表现在主观中。</p><p>认知过程指人脑通过感觉、知觉、记忆、思维、想象等形式反映客观对象的性质及对象间关系的过程。</p><p><img src="https://static.v2grad.com/img/202208210858789.webp" alt="认知过程" /></p><h3 id="12-举个例子"><a class="markdownIt-Anchor" href="#12-举个例子"></a> 1.2 举个例子</h3><p>同样是参加工作一年的4s店汽修技工A\B\C三人。</p><ul><li>A想努力多挣点钱，于是每天加班，抢着做那些工时高（工时高，工资多），效率高的维修单。</li><li>B想努力多挣点钱，于是他每天下班后去研究学习新的技术知识，上班后尽量接技术性高的，跟新技术相关的单子。</li><li>C想努力多挣点钱，于是他学习技术的同时，还组建了一个微信客户群，把每位接待过的车主都拉进群。并经常在群里更新一些汽车相关常识，新技术等知识，帮客户分析用车问题。</li></ul><p>这三人明显在对环境的认知上有很大差别。</p><ul><li>A认为：多劳即多得。</li><li>B认为：自我提升重要，价值取决于个体技能。</li><li>C认为：个人技能、利用环境积累有效客户资源。人与资源的配合重要。</li></ul><p>他们之后的发展趋势我们也可以简单地预测一下。</p><ul><li>A：汽车技术革新是非常快的，随着需求的提升，在传统的机械构造上更新了更多的电子技术，“吃老本”是行不通的。A会逐渐感到技术跟不上需求，变得越来越吃力。</li><li>B：花费大量的精力在提升自己，工作上会得心应手，随着时间积累技术上明显领先他人。做到大师傅，大组长，技术主管等不难。</li><li>C：花费部分精力学习，能应对大部分工作，并分出部分精力通过微信群服务得到了大量客户的黏性和信任，业内口碑建立。排除其他因素下，相比A和B，晋升管理层的机会要大很多，积累的客户资源对以后做相关的创业也有很大帮助。</li></ul><h2 id="二-认知水平层级"><a class="markdownIt-Anchor" href="#二-认知水平层级"></a> 二、认知水平层级</h2><p>认知上从低到高，是可以分为三个等级。不同的认知，决定了不同的命运。</p><h3 id="21-第一层一元思维模式"><a class="markdownIt-Anchor" href="#21-第一层一元思维模式"></a> 2.1 第一层：一元思维模式</h3><blockquote><p>在非洲的贫民窟里，有位警察打死了一条疯狗。<br />目击者便将这件事，告诉了当地的一个居民。<br />“警察打死了……”<br />目击者刚开口说了前半句，那人就打断他，并发出质问：“警察打死人了？谁给他们的权力？警察就可以为所欲为吗？”<br />目击者接着说：“打死了的是一条狗。”<br />那人又怒斥道：“狗怎么了？狗就不是生命吗？一条活生生的生命消失了，就没人为此负责吗？”<br />目击者连忙解释：“那是一条疯狗。”<br />那人依旧不依不饶：“是不是疯狗是由你来评定的吗？有经过鉴定吗？鉴定程序合法吗？这里面难道没有别的黑幕吗？”<br /><strong>目击者的声音越来越小：“当时它正在追着路人乱咬，我亲眼看到的，没人招惹它！”</strong><br />那人依旧不甘示弱：“眼见就一定为实吗？你就不觉得蹊跷吗？这个国家的黑幕还少吗？”<br />最后，目击者无言以对，只好转身离去。<br />那人洋洋得意，正大摇大摆地准备离开，结果一不小心，踩到了睡在路边的野狗尾巴。<br />慌乱之中，野狗起身咬了他一口。<br />他一边忍痛，一边破口大骂：“谁家的疯狗乱咬人，就没人来管管吗？这个社会究竟是怎么了？”</p></blockquote><p><strong>低认知的人，都是单线思维，常常以自我为中心，无法和外界的观念兼容，一条路走到底。</strong></p><p>如同故事里的喷子，他们是网上的键盘侠，也是生活中的杠精。不管你说什么，他们的第一反应就是争辩。</p><p><strong>这一认知层次的人，大都自以为是，固执己见，喜欢通过抬杠来显示出自身的存在感和优越感</strong>。哪怕是既定的事实，他们也会雄辩滔滔，来获得言语上的胜利。</p><p>心理学上有个名词叫“回火效应”，指的就是当一个人遇到事实和自己的认知相违背时，往往拒绝接受这个事实，并强化固守自己最初的立场。</p><h3 id="22-第二层二元思维模式"><a class="markdownIt-Anchor" href="#22-第二层二元思维模式"></a> 2.2 第二层：二元思维模式</h3><blockquote><p>一个老教授带着学生走在路上，打算顺带买一条鱼。<br />教授停留在小摊面前，反复挑了挑，选了一条鱼刺比较少的清江鱼。<br />鱼贩看到后说：“你眼光不行啊，这种鱼不好吃，要不要换一条？”<br />老教授笑着回答：“不用，就这条。”<br />鱼贩开口嘲笑：“你们这些读书人，认识了几个大字，读了几本书，就觉得自己什么都懂，可买鱼啊，还得听我的。”<br /><strong>一旁的学生看不下去，便上去与之辩驳，双方各自不服气，争吵的声音也越来越大。</strong><br />教授赶紧拉着学生离开。<br />学生不解地问：“那位鱼贩如此羞辱咱读书人，老师您不生气吗？”<br />教授微微一笑说：“我能理解他。卖鱼知道哪些鱼好吃就行了，他不是必须要明白，这个世界上有多少种类的鱼，哪种鱼的鱼刺少，更适合老年人。”</p></blockquote><p><strong>拥有二元思维认知的人，对事物有基础的辨别能力，有理性也有同理心，能站在对方的角度去想问题。</strong></p><p>就像故事中的老教授，鱼贩出言嘲讽，他反而站在他人的立场去考虑问题，明白每个人的局限性。</p><p><strong>具有二元思维认知的人，听见不同的声音时，往往能够辩证地看待问题。</strong> 他们从来不会在无意义的辩解上浪费时间，即使不同意别人的看法，也会对其包容和尊重。</p><h3 id="23-第三层多元思维模式"><a class="markdownIt-Anchor" href="#23-第三层多元思维模式"></a> 2.3 第三层：多元思维模式</h3><blockquote><p>第三个故事，发生在法国的一位著名画家身上。<br />画家在瑞士度假的时候，常常背着画板四处游走写生。<br />一天，当他在日内瓦湖边，刚把两岸美景收于画中，旁边走来了三位女游客。<br />她们边走边聊，对着四周美景就是一顿吐槽：“这个地方也没有想象中那么好看啊……”<br />声音渐近，当她们路过画家身边时，开始对他的画指手画脚。<br />“这儿画得不好，明明是棵很挺拔的树，你画得这么歪；<br />那里颜色也不对，这么蓝的天，你画得一点也不蓝；<br />还有些东西你根本没画进去，你看，那里漏掉了几个人……”<br /><strong>画家没有反驳，始终保持微笑，还根据她们的建议，稍稍修改了自己的画作。</strong><br />次日，他去另一处写生，又碰见了那三位女士。<br />女士们问他：“先生，我们听说大画家贝罗尼在瑞士，想拜访一下他，你应该知道他住在哪里吧？”<br />画家微微弓腰，客气说道：“不敢当，我就是贝罗尼。”</p></blockquote><p><strong>拥有多元思维认知的人，自带“过滤净化系统”。</strong></p><p>就像故事中的画家贝罗尼，面对三位女士的业余指点，他非但没有以专业傲人，反而虚心听取她们的意见。</p><p><strong>具有多元思维认知的人，不仅能够兼容不同的观点，还能取其精华去其糟粕，从各种声音中吸收有用的信息。</strong></p><h2 id="三-如何提高认知"><a class="markdownIt-Anchor" href="#三-如何提高认知"></a> 三、如何提高认知</h2><p>认知能力受到一系列因素的影响，包括遗传素质和个体经历。</p><p>虽然我们无法改变自己的基因，但是我们可以做一些力所能及的事情来保护和最大化自己的认知能力.</p><h3 id="31-多阅读多思考不盲从"><a class="markdownIt-Anchor" href="#31-多阅读多思考不盲从"></a> 3.1 多阅读，多思考，不盲从</h3><p><img src="https://static.v2grad.com/img/202208211643857.png" alt="多阅读，多思考，不盲从" /><br />你曾经读过的书，会体现在你的谈吐、气质、性情、修养等方面，会让你的知识面更宽，思考问题的角度更多元和深刻。</p><p>不断提高你的认知层次，让你过上物质和精神更加富足的生活。</p><p>多思考，不盲从，你才能有自己人格的独立性，无论与人相处还是一个人独处，都能感到自在从容。</p><h3 id="32-多见世面多看世界"><a class="markdownIt-Anchor" href="#32-多见世面多看世界"></a> 3.2 多见世面，多看世界</h3><p><img src="https://static.v2grad.com/img/202208211641372.png" alt="多见世面，多看世界" /></p><p>见识见识，有见才能更有识，见多才能识广。</p><p>古人说：读万卷书，行万里路。</p><p>走出自己的小世界，去看看各地不一样的风景，才能感受到更加丰富的生活，活出人生的高度、宽度和厚度。</p><p>眼界狭小，只能让自己的人生受限。</p><h3 id="33-多与认知水平高的人交流"><a class="markdownIt-Anchor" href="#33-多与认知水平高的人交流"></a> 3.3 多与认知水平高的人交流</h3><p><img src="https://static.v2grad.com/img/202208211640290.png" alt="多与认知水平高的人交流" /><br />你的水平，取决于你经常交往的五个人的平均值。</p><p>多与认知水平高的人交流，你的认知水平，耳濡目染，潜移默化，不知不觉中就得到了提升。</p><h2 id="四-写在最后"><a class="markdownIt-Anchor" href="#四-写在最后"></a> 四、写在最后</h2><p><strong>人的一生，都在为认知水平买单</strong></p><p>《教父》中有一句经典台词：花半秒钟就看透事物本质的人，和花一辈子都看不清事物本质的人，注定是截然不同的命运。</p><p><img src="https://static.v2grad.com/img/202208211634996.png" alt="人的一生，都在为认知水平买单" /></p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><p><a href="https://www.cognifit.com/cn/cognition">认知能力与认知科学 / CogniFit</a><br /><a href="https://zhuanlan.zhihu.com/p/36490527">你觉得你很努力，其实你在逃避—《认知三部曲》</a><br /><a href="https://zhuanlan.zhihu.com/p/383802013">认知水平越低的人，越爱抬杠</a><br /><a href="https://mp.weixin.qq.com/s/_-cY_S_LUjCOONEtqgXpmA">提高认知水平的3种路径 / 逆习</a></p>]]>
    </content>
    <id>https://v2grad.com/2022/08/20/cognitions/</id>
    <link href="https://v2grad.com/2022/08/20/cognitions/"/>
    <published>2022-08-20T08:55:34.000Z</published>
    <summary>张一鸣说：对事情的认知是最关键的，你对事情的理解，就是你在这件事情上的竞争力，因为理论上其他的生产要素都可以构建。</summary>
    <title>关于认知的理解</title>
    <updated>2022-08-20T08:55:34.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="机器学习" scheme="https://v2grad.com/categories/machinelearning/"/>
    <category term="机器学习" scheme="https://v2grad.com/tags/%E6%9C%BA%E5%99%A8%E5%AD%A6%E4%B9%A0/"/>
    <content>
      <![CDATA[<h2 id="mlops"><a class="markdownIt-Anchor" href="#mlops"></a> MLOps</h2><h3 id="什么是mlops"><a class="markdownIt-Anchor" href="#什么是mlops"></a> 什么是MLOps</h3><p>MLOps（Machine Learning Operations）是一组用于数据科学家和运维人员之间协作和沟通的最佳实践。应用这些实践可以提高质量，简化管理流程，并在大规模生产环境中自动部署机器学习和深度学习模型，使模型与业务需求以及规则要求保持一致变得更加容易。</p><p>MLOps的概念本身也在发展之中，不同的公司对他的描述也不一样,但基本都是沿用DevOps的思路来定义。</p><ul><li><em>Google</em>：MLOps是一种机器学习工程文化和做法，旨在统一机器学习系统开发（Dev）和机器学习系统运维（Ops）。实施MLOps意味着您将在机器学习系统构建流程的所有步骤（包括集成、测试、发布、部署和基础架构管理）中实现自动化和监控。</li><li><em>Microsoft</em>：MLOps是基于可提高工作流效率的DevOps原理和做法。目标是更快试验和开发模型，更快地将模型部署到生产环境，质量保证和端到端世系跟踪。</li><li><em>Amazon</em>：MLOps考虑了AI/ML项目在项目管理、CI/CD和质量保证方面的独特方面，帮助客户缩短交付时间，减少缺陷并提高数据科学家的工作效率。</li></ul><p><img src="https://static.v2grad.com/img/202205180632142.png" alt="MLOps" /><br />机器学习、数据工程和 DevOps 都在这个领域融合在一起。换句话说，它将机器学习与设计，构建和维护系统的任务联系起来。</p><p><img src="https://static.v2grad.com/img/202205180637430.png" alt="MLOps=ML+Dev+Ops" /><br />MLOps是一套方法架构，一套可持续、可问责、可重现的、可非同步合作的机器学习开发运行方法。<br />数据科学界普遍认为，它是围绕机器学习的最佳实践和指导原则的总称，而不是单一的技术解决方案。<br />广义来说，是企业更有系统性地去运用数据的方法，MLOps是落地AI策略的基本功。</p><h3 id="为什么需要mlops"><a class="markdownIt-Anchor" href="#为什么需要mlops"></a> 为什么需要MLOps</h3><blockquote><p>MLOps的目标是减少技术摩擦，使模型在尽可能短的时间内将想法投入生产，同时尽可能降低风险。</p></blockquote><p>生产环境中机器学习模型的使用是很困难的。机器学习生命周期由许多复杂的组件组成，例如数据引入、数据准备、模型训练、模型调优、模型部署、模型监视、可解释性等等。它还需要跨团队的协作和交接，从数据工程到数据科学再到ML工程。当然，它需要严格的操作严谨性，以保持所有这些流程的同步和协同工作。MLOps包括机器学习生命周期的试验、迭代和持续改进。</p><p>Google于2015年在NIPS上发表了《Hidden Technical Debt in Machine Learning Systems》。论文作者提出，如今大量机器学习库和框架方便易用，但由于缺乏系统化的理论指导导致形成了大量技术债务，在生产环境中面临高昂的维护成本。</p><p>业务实践过程中可以看到，很多同学过分关注在算法的优化上，似乎只求在‘正常’的情况下稳定工作即可，对整个系统的问题视而不见。</p><p><img src="https://static.v2grad.com/img/202205200634081.png" alt="真实的机器学习系统" /></p><p>AI产业化时代，机器学习技术越来越多应用到各个领域，如何构建一个稳定可靠的机器学习系统变得至关重要。</p><h3 id="mlops-vs-devops"><a class="markdownIt-Anchor" href="#mlops-vs-devops"></a> MLOps Vs DevOps</h3><p>DevOps是指将软件开发的开发，测试和运维结合在一起。MLOps从DevOps中获取了许多原则，DevOps是首先被提出，并被引入到简化机器学习生命周期的方法。</p><p><strong>相似之处</strong></p><ul><li><p>DevOps和MLOps都是关于<strong>简化流程的</strong>。DevOps将软件开发的开发、测试和运维结合在一起。它旨在将这些孤立的流程转变为组织内一组连续的内聚步骤。同样，MLOps是用于从头到尾简化机器学习生命周期的方法。它旨在弥合设计，模型开发和运维之间的差距，以缩短ML开发中的周转时间。</p></li><li><p>DevOps和MLOps是关于<strong>沟通</strong>的。对于DevOps而言，清晰的沟通对于流程自动化、持续交付和反馈循环至关重要，因为它依赖于部门之间的顺利合作以及一组以可见方式巩固和促进这些流程的工具（例如，CI/CD 系统）。对于 MLOps 而言，沟通是系统管理员、数据科学团队和整个组织中其他部门之间协作的基础，从而对如何开发和维护生产模型达成共识。</p></li></ul><p><strong>差异之处</strong></p><ul><li><strong>版本控制</strong>：通过 DevOps，代码版本控制可用于确保有关对正在开发的软件所做的任何更改或调整的清晰文档。然而，对于机器学习，代码并不是唯一不断变化的输入。数据是需要管理的另一个关键输入，参数、元数据、日志以及最后的模型也是如此。<br /><img src="https://static.v2grad.com/img/202205210815512.png" alt="DevOps和MLOps的差异-机器学习的版本控制" /></li><li><strong>所需硬件</strong>：训练机器学习模型，尤其是深度学习，往往是非常计算密集型的。对于大多数软件项目来说，构建时间是完全无关紧要的，因此完成构建的硬件也是无关紧要的。然而，较大的模型可能需要数小时到数周的时间来训练，即使在云供应商提供的大多数GPU机器上也是如此，这意味着MLOps设置需要更复杂地管理哪种机器。<br /><img src="https://static.v2grad.com/img/202205210815835.png" alt="DevOps和MLOps的差异-所需硬件" /></li><li><strong>持续监控</strong>：监控也是良好 DevOps 实践的一部分。在过去几年中，站点可靠性工程（SRE）风靡一时，凸显了监控在软件开发中的重要性。DevOps和MLOps中的监控之间的区别在于，软件不会降级，而机器学习模型会降级。将模型部署到生产环境后，它开始从现实世界接收的新数据生成预测。这些数据将随着业务环境的变化和调整而继续变化和调整，从而导致模型退化。MLOps 提供了促进持续监视和重新训练的过程，以便算法可以继续在生产中使用。</li></ul><p>随着机器学习成为许多软件产品的标准部分，DevOps和MLOps可能会合并，数据版本控制和持续训练管道等内容被添加到现有的技术堆栈中。<br /><img src="https://static.v2grad.com/img/202205210818305.png" alt="MLOps概念可能会建立在DevOps堆栈之上" /></p><h3 id="model-centric-vs-data-centric"><a class="markdownIt-Anchor" href="#model-centric-vs-data-centric"></a> Model-centric VS Data-centric</h3><p>吴恩达老师21年3月开了一个直播讲： A Chat with Andrew on MLOps: From Model-centric to Data-centric AI。吴恩达认为<strong>在一个AI 系统中，数据质量要比模型本身更重要，与其更强调调优模型，不如尽可能地清理数据</strong>。在钢板缺陷检测任务当中，baseline准确率为76.2%，各种换模型调参数之后，对准确率几乎没有提升。但是对数据集的优化却将准确率提升了16.9%，其它项目的经验也证明了这点。<br /><img src="https://static.v2grad.com/img/202205210827233.png" alt="improving the code vs the data" /></p><p><strong>Model-centric</strong>: 以调整模型代码、调优模型超参数为主的系统调优策略，在这种策略下，可以认为数据集是固定的。<br /><strong>Data-centric</strong>: 与Model-centric相对，以调整数据集为主的系统调优策略，在这种策略下，可以认为模型是固定的（只对数据集作适应性调整）<br /><img src="https://static.v2grad.com/img/202205210832999.png" alt="Making it systematic: MLOps" /></p><h2 id="机器学习工作流"><a class="markdownIt-Anchor" href="#机器学习工作流"></a> 机器学习工作流</h2><p>机器学习项目的目标是通过使用收集的数据并对其应用机器学习算法来构建统计模型。因此，每个基于 ML 的软件都包含三个主要组件：数据、模型和代码。与这些组件相对应，典型的机器学习工作流由三个主要阶段组成：</p><ul><li><strong>数据工程（Data Engineering）</strong>：数据采集和数据准备</li><li><strong>模型工程（Model Engineering）</strong>：ML模型训练和服务</li><li><strong>代码工程（Code Engineering）</strong>：将ML模型集成到最终产品中<br /><img src="https://static.v2grad.com/img/202206040958860.png" alt="机器学习系统组成Data+Model+Code" /></li></ul><h3 id="数据工程data"><a class="markdownIt-Anchor" href="#数据工程data"></a> 数据工程Data</h3><p>任何数据科学工作流的初始步骤都是获取和准备要分析的数据，通常，数据是从各种数据源集成的，并且具有不同的格式。数据准备是一个迭代和敏捷的过程，用于探索，组合，清理原始数据并将其转换为建模需要的数据集，用于数据集成，数据科学，数据发现和分析/商业智能（BI）等场景。尽管数据准备只是一个中间阶段，但该阶段在资源和时间方面的投入是最大的。数据准备是数据科学工作流中的一个关键活动，因为这一阶段的错误会传播到下一阶段，导致从数据中挖掘出错误的知识。</p><p>数据工程管道包括对可用数据的一系列操作，这些操作导致为机器学习算法提供训练和测试数据集：</p><ul><li><strong>数据摄取</strong>：使用各种框架和格式（如 Spark、HDFS、CSV 等）收集数据。此步骤还可能包括综合数据生成或数据扩充。</li><li><strong>探索和验证</strong>：包括数据探查，以获取有关数据内容和结构的信息。此步骤的输出是一组元数据，例如最大值、最小值、平均值。数据验证操作是用户定义的错误检测函数，用于扫描数据集以发现某些错误。</li><li><strong>数据清理</strong>： 重新格式化特定属性和更正数据中的错误（如缺失值插补）的过程。</li><li><strong>数据标记</strong>： 数据工程管道的操作，其中每个数据点都分配给特定类别。</li><li><strong>数据拆分</strong>： 将数据拆分为训练、验证和测试数据集，以便在核心机器学习阶段使用以生成ML模型。</li></ul><h3 id="模型工程model"><a class="markdownIt-Anchor" href="#模型工程model"></a> 模型工程Model</h3><p>机器学习工作流的核心是编写和执行机器学习算法以获取机器学习模型的阶段。“模型工程”管道包括许多生成最终模型的操作：</p><ul><li><strong>模型训练</strong>：对训练数据应用机器学习算法以训练 ML 模型的过程。它还包括特征工程和模型训练活动的超参数调优。</li><li><strong>模型评估</strong>： 验证训练的模型，以确保其满足原始编纂的目标，然后再将生产中的 ML 模型提供给最终用户。</li><li><strong>模型测试</strong>：使用保留测试数据集执行最终的“模型验收测试”。</li><li><strong>模型打包</strong>：将最终 ML 模型导出为特定格式（例如 PMML、PFA 或 ONNX）的过程，用于描述模型，以便业务应用程序使用。</li></ul><h3 id="代码工程code"><a class="markdownIt-Anchor" href="#代码工程code"></a> 代码工程Code</h3><p>一旦我们训练了机器学习模型，我们就需要将其部署为业务应用程序（如移动或桌面应用程序）的一部分。机器学习模型需要各种数据点（特征向量）来生成预测。机器学习工作流程的最后阶段是将以前设计的机器学习模型集成到现有软件中。此阶段包括以下操作：</p><ul><li><strong>模型服务</strong>： 在生产环境中处理机器学习模型组件的过程。</li><li><strong>模型性能监视</strong>：根据实时和以前未见过的数据（如预测或建议）观察模型性能的过程。特别是，我们对ML特定的信号感兴趣，例如预测与先前模型性能的偏差。这些信号可以用作模型重新训练的触发器。</li><li><strong>模型性能日志记录</strong>： 每个推理请求都会生成日志记录。</li></ul><h3 id="流水线pipeline"><a class="markdownIt-Anchor" href="#流水线pipeline"></a> 流水线Pipeline</h3><p>在任何机器学习项目中，定义业务用例并确定成功标准后，将机器学习模型交付给生产环境的过程涉及以下步骤。<br />这些步骤可以手动完成，也可以由自动流水线完成。<br /><img src="https://static.v2grad.com/img/202206040945422.png" alt="机器学习工作流" /></p><ul><li><strong>数据提取</strong>：为机器学习任务选择和集成来自各种数据源的相关数据。</li><li><strong>数据分析</strong>：执行探索性数据分析 (EDA) 以了解可用于构建机器学习模型的数据。此过程将产生以下结果：1）了解模型预期的数据架构和特性，2）识别模型所需的数据准备和特征工程。</li><li><strong>数据准备</strong>：为机器学习任务准备数据。此准备工作涉及数据清理，即将数据拆分为训练集、验证集和测试集。还可以将数据转换和特征工程应用于解决目标任务的模型。此步骤的输出是准备格式的数据分片。</li><li><strong>模型训练</strong>：数据科学家使用准备好的数据实现不同的算法，以训练各种机器学习模型。此外，还需要对实现的算法进行超参数调节，以获得最佳机器学习模型。此步骤的输出是经过训练的模型。</li><li><strong>模型评估</strong>：在保留测试集上评估模型，以评估模型质量。此步骤的输出是一组用于评估模型质量的指标。</li><li><strong>模型验证</strong>：模型已确定适合部署 - 它的预测性能优于特定基准。</li><li><strong>提供模型</strong>：经过验证的模型会部署到目标环境以提供预测。此部署可以是以下其中一项：1）具有 REST API 的微服务，可用于提供在线预测。2）边缘设备或移动设备的嵌入式模型。3）批量预测系统的一部分。</li><li><strong>模型监控</strong>：监控模型预测性能，以便在机器学习过程中潜在调用新的迭代。</li></ul><p>这些步骤的自动化级别决定了机器学习过程的成熟度，成熟度反映了使用新数据训练新模型或者使用新实现训练新模型的速度。以下部分介绍了三个级别的 MLOps，从最常见的级别（该级别不涉及自动化）开始，一直到自动执行机器学习和 CI/CD 流水线。</p><h2 id="mlops的成熟度级别"><a class="markdownIt-Anchor" href="#mlops的成熟度级别"></a> MLOps的成熟度级别</h2><h3 id="mlops级别-0手动过程"><a class="markdownIt-Anchor" href="#mlops级别-0手动过程"></a> MLOps级别 0：手动过程</h3><p>许多团队都有数据科学家和机器学习研究人员，他们可以构建领先的模型，但他们构建和部署机器学习模型的过程完全是手动的。这样的级别被视为基本成熟度级别（级别 0）。</p><p>下图展示了此过程的工作流。<br /><img src="https://static.v2grad.com/img/202205250615037.png" alt="将模型用作预测服务的手动机器学习步骤" /></p><p><strong>特性</strong></p><ul><li>Pipeline中每个步骤（包括数据分析、数据准备、模型训练和验证）都是<strong>交互式手动的过程</strong>，一般是指在jupyter中编写和执行的实验性代码驱动，直到生成有效的模型为止。</li><li><strong>创建模型的数据科学家和将模型用作预测服务的工程师是分开的</strong>，数据科学家将训练好的模型交付给工程团队，以便在其API基础架构上进行部署，这可能会导致训练-应用偏差。</li><li><strong>不频繁发布迭代</strong>，模型一年仅部署几次。</li><li>因为模型基本不做更改，因此<strong>无CI/CD</strong>。</li><li><strong>部署指的是预测服务</strong>，而不是整个机器学习系统。</li><li>没有记录模型预测的数据，缺少模型性能下降和其他模型行为偏移检测所必要的信息，<strong>缺少主动性能监控</strong></li></ul><p><strong>挑战</strong><br />MLOps 级别 0 在许多开始将机器学习应用于其用例的企业中很常见。如果难得更改或训练模型，则由数据科学家驱动的此手动过程可能就足够了。实际上，在现实环境中部署模型时，模型通常会失效。模型无法适应环境的动态变化或描述环境的数据的变化。如需战胜这些挑战并保持模型在生产环境中的准确性，您需要执行以下操作：</p><ul><li>在生产环境中主动监控模型的质量</li><li>频繁地重新训练生产模型</li><li>不断尝试新的实现以生成模型</li></ul><p>为了战胜此手动过程的挑战，CI/CD 和 CT 的 MLOps 做法很有用。通过部署机器学习训练流水线，您可以启用CT，并且可以设置 CI/CD 系统以快速测试、构建和部署机器学习流水线的新实现。</p><h3 id="mlops级别-1ml-流水线自动化"><a class="markdownIt-Anchor" href="#mlops级别-1ml-流水线自动化"></a> MLOps级别 1：ML 流水线自动化</h3><p>级别1的目标是通过自动执行机器学习流水线来持续训练模型；这样可以持续交付模型预测服务。如需自动执行在生产环境中使用新数据重新训练模型的过程，您需要在流水线中引入自动化数据和模型验证步骤，以及流水线触发器和元数据管理。</p><p>下图是针对 CT 的自动化机器学习流水线的示意图。<br /><img src="https://static.v2grad.com/img/202205260558935.png" alt="针对 CT 的机器学习流水线自动化" /></p><p><strong>特性</strong></p><ul><li>机器学习pipeline中的各个步骤都被编排过，步骤之间的转换是自动执行的，可以<strong>快速迭代实验</strong>。</li><li>实验环境测试好的pipeline，可以在生产环境中根据实时pipeline触发器使用新数据自动训练模型，可以实现<strong>生产环境中模型的CT</strong>。</li><li>实验环境中使用的pipeline实现会在预生产和生产环境中使用，<strong>实验与运维之间具有一致性</strong>。</li><li>机器学习pipeline中各个组件是可重复使用、可组合、并且可能可以跨pipeline共享，<strong>pipeline是被组件化的</strong>。</li><li>生产环境的模型训练可以例行化地执行，修改过的pipeline可以自动基于最新版的数据进行训练并<strong>持续交付</strong>。</li><li>部署的不仅仅是把预测服务部署到生产环境，而且包括把<strong>整个训练pipeline部署生产环境</strong>。</li></ul><p><strong>实现CT需要依赖的组件</strong></p><ul><li><strong>数据和模型验证</strong>：开始训练之前，需要检查是否存在<strong>数据结构偏差</strong>或者<strong>数据值的偏差</strong>；训练结束之后，需要在验证集上进行<strong>模型评估</strong>，上线过程要走<strong>灰度发布</strong>并走<strong>AB测试</strong>。</li><li><strong>Feature Store</strong>：一个集中式存储区，可以在其中对<strong>特征的定义、存储和访问进行标准化处理</strong>，以方便训练和提供服务。需要为特征值提供<strong>高吞吐量批量服务</strong>和<strong>低延时实时服务的API</strong>，以及支持训练和服务工作负载。</li><li><strong>元数据管理</strong>：记录有关机器学习流水线每次执行情况的信息，以帮助实现数据和组件沿袭、可重现性以及比较。</li><li><strong>pipeline任务调度</strong>：可以自动执行机器学习pipeline，根据场景使用最新数据进行模型训练。可以手动触发也可以定时触发，或者其他条件触发新模型训练。</li></ul><p><strong>挑战</strong><br />假设pipeline的新实现不经常部署，并且我们只管理几个管道，那么通常需要手动测试和部署pipeline及其组件。此外，还需要将pipeline的测试源代码提交给IT团队，以部署到目标环境，这种设置适用于基于新数据（而不是基于新的ML想法）部署新模型的情况。</p><p>但是，您需要尝试新的ML想法并快速部署ML组件的新实现。如果在生产环境中管理多个ML管道，则需要CI/CD设置来自动执行pipeline的生成、测试和部署。</p><h3 id="mlops级别-2cicd-流水线自动化"><a class="markdownIt-Anchor" href="#mlops级别-2cicd-流水线自动化"></a> MLOps级别 2：CI/CD 流水线自动化</h3><p>如果需要在生产环境中快速、可靠的更新pipeline，那么我们就需要一个可靠的自动化CI/CD系统，让数据科学家可以快速探索有关特征工程、模型架构和超参数的新想法。数据科学家可以实现这些想法，并自动构建、测试新的pipeline组件并将其部署在目标环境。</p><p>下图显示了使用 CI/CD 的机器学习流水线的实现，它具有自动化机器学习流水线设置的特性以及自动化 CI/CD 例程。<br /><img src="https://static.v2grad.com/img/202207180844442.png" alt="CI/CD 和自动化机器学习流水线。" /></p><p>为了MLOps级别2的水平，需要依赖以下组件：</p><ul><li>源代码控制</li><li>测试和构建服务</li><li>部署服务</li><li>模型注册表</li><li>特征存储区</li><li>机器学习元数据存储区</li><li>机器学习流水线任务调度器</li></ul><p><strong>特性</strong></p><p>下图展示了机器学习 CI/CD 自动化流水线的各个阶段：<br /><img src="https://static.v2grad.com/img/202205311902531.png" alt="CI/CD 自动化流水线的各个阶段" /></p><p>流水线包括以下阶段：</p><ul><li><strong>开发和实验</strong>：在已经编排好机器学习各个步骤的流水线上，反复尝试新的机器学习算法和新的建模方案。这个阶段的输出是机器学习流水线各个步骤的的源代码，最后都会被统一推送到源代码库中。</li><li><strong>流水线持续集成</strong>：构建源代码并运行各种测试。这个阶段的输出是要在后续阶段部署的流水线组件（软件包、可执行文件和工件）。</li><li><strong>流水线持续交付</strong>：可以将CI阶段生成的组件部署到目标环境。此阶段的输出是已部署的流水线，其中包含模型的新实现。</li><li><strong>自动触发</strong>：流水线会根据时间表或响应触发器而自动在生产环境中执行。此阶段的输出是已推送到模型注册表并且经过训练的模型。</li><li><strong>模型持续交付</strong>：您可以将经过训练的模型用作预测服务。此阶段的输出是已部署的模型预测服务。</li><li><strong>监控</strong>：可以实时收集模型性能的统计信息。此阶段的输出是用于执行流水线或执行新实验周期的触发器。</li></ul><p>在流水线开始实验的新迭代之前，数据分析步骤仍然是数据科学家手动执行的过程。模型分析步骤也是手动执行的过程。</p><h2 id="mlops的原则"><a class="markdownIt-Anchor" href="#mlops的原则"></a> MLOps的原则</h2><h3 id="自动化automation"><a class="markdownIt-Anchor" href="#自动化automation"></a> 自动化Automation</h3><p>在整个workflow中所有可以自动化的环节，我们都应该进行自动化，从数据的接入到最后的部署上线。<br /><img src="https://static.v2grad.com/img/202206091001228.png" alt="automated ML pipeline with CI/CD routines" /></p><h3 id="持续化continuous-x"><a class="markdownIt-Anchor" href="#持续化continuous-x"></a> 持续化Continuous X</h3><p>一说起DevOps，大家就很容易联想到CI/CD，也从侧面印证这条原则的重要性。MLOps在持续集成，持续部署，持续监控的基础上，还增加了持续训练的概念，即模型在线上运行过程中可以持续得到自动化的训练与更新。我们在设计开发机器学习系统时，要持续思考各个组件对“持续”性的支持，包括流程中用到的各种artifacts，他们的版本管理和编排串联等。</p><p>MLOps是一种ML工程文化，包括以下实践：</p><ul><li><strong>持续集成Continuous Integration (CI)</strong>：不仅仅是对代码（Code），还包括对数据（Data）和模型的持续测试和验证。</li><li><strong>持续交付Continuous Delivery (CD)</strong>：不仅仅对软件包进行持续部署，还包括对预测服务的持续部署和更新（因为更新预测服务有时候是只更新模型，有时候是模型和数据一起更新，并不更新代码）</li><li><strong>持续训练Continuous Training (CT)</strong>： 这是机器学习所特有的，需要对模型进行自动的持续训练</li><li><strong>持续监控Continuous Monitoring (CM)</strong>： 不只是监控服务的可用性，还需要监控预测服务的准确性、召回率等性能指标，如果有下降可能触发持续训练。</li></ul><h3 id="版本控制versioning"><a class="markdownIt-Anchor" href="#版本控制versioning"></a> 版本控制Versioning</h3><p>版本化管理也是DevOps的重要最佳实践之一，在MLOps领域，除了pipeline代码的版本管理，数据，模型的版本管理属于新涌现的需求点，也对底层infra提出了新的挑战。<br /><img src="https://static.v2grad.com/img/202206091018402.png" alt="数据版本控制工具" /></p><h3 id="实验追踪experiment-tracking"><a class="markdownIt-Anchor" href="#实验追踪experiment-tracking"></a> 实验追踪Experiment Tracking</h3><p>实验管理可以理解为version control中commit message的增强。对于涉及模型构建相关的代码改动，我们都应该能记录当时对应的数据，代码版本，以及对应的模型artifacts存档，作为后续分析模型，选择具体上线的版本的重要依据。</p><h3 id="测试testing"><a class="markdownIt-Anchor" href="#测试testing"></a> 测试Testing</h3><p>机器学习系统中主要涉及到3种不同的pipeline，分别是数据pipeline，模型pipeline和应用pipeline（类似于模型与应用系统的集成）。针对这3个pipeline，需要构建对应的数据特征测试，模型测试以及应用infra测试，确保整体系统的输出与预期的业务目标相符，达到将数据insights转化为业务价值的目的。</p><p>这方面Google的ML test score是一个很好的参考。《The ML Test Score:A Rubric for ML Production Readiness and Technical Debt Reduction》<br />传统的系统测试和监控 VS 基于ML的系统测试和监控<br /><img src="https://static.v2grad.com/img/202206091029475.png" alt="传统的系统测试和监控 VS 基于ML的系统测试和监控" /></p><p>Google Data/Model/Infra/Monitor监控列表<br /><img src="https://static.v2grad.com/img/202206091033052.png" alt="Google Data/Model/Infra/Monitor监控列表" /></p><h3 id="监控monitoring"><a class="markdownIt-Anchor" href="#监控monitoring"></a> 监控Monitoring</h3><p>监控也是一项软件工程的传统最佳实践。上面提到的ML test score中也有一部分是与监控相关。除了传统的系统监控，例如日志，系统资源等方面外，机器学习系统还需要对输入输出数据，模型相关指标进行监控，确保预测的质量和效率，并在出现异常情况时自动触发一些应对机制，例如数据或模型的降级，模型的重新训练与部署等。</p><p>下图显示可以通过跟踪模型预测的精度、召回率和 F1-score 以及时间来实现模型监控。 精度、召回率和 F1 分数的降低会触发模型重新训练，从而使模型恢复之前的效果。<br /><img src="https://static.v2grad.com/img/202206091042395.png" alt="监控Monitoring" /></p><h3 id="可复现reproducibility"><a class="markdownIt-Anchor" href="#可复现reproducibility"></a> 可复现Reproducibility</h3><p>与传统软件系统的确定性行为不同，机器学习中带有不少“随机化”的成分，这对各种问题的排查，版本回滚，输出效果的确定性都提出了一定的挑战。因此我们在开发过程中也需要时刻将可复现原则放在心上，设计相应的最佳实践（如设定随机数种子，运行环境等各类依赖的版本化等）。</p><p><img src="https://static.v2grad.com/img/202206091059177.png" alt="机器学习工作流中的可重复性意味着数据处理、ML 模型训练和 ML 模型部署的每个阶段都应在给定相同输入的情况下产生相同的结果" /></p><h2 id="mlops实践"><a class="markdownIt-Anchor" href="#mlops实践"></a> MLOps实践</h2><p><img src="https://static.v2grad.com/img/202206041155898.png" alt="机器学习框架" /><br /><strong>离线框架</strong><br />离线关键问题:快速迭代，高效开发</p><ul><li>业务/模型分离</li><li>逻辑/工具分离</li></ul><p>离线框架方向</p><ul><li>灵活支持多个APP</li><li>快速、灵活支持数据、特征迭代</li></ul><p><strong>模型平台</strong><br />模型平台关键问题:大数据量，快速尝试新模型</p><ul><li>分布式机器学习平台</li></ul><p>模型平台发展方向</p><ul><li>高效</li><li>快速支持新模型迭代对业务透明</li></ul><p><strong>在线排序</strong><br />在线关键问题:可拓展，高性能</p><ul><li>可配置的特征抽取模块</li><li>支持多业务线的方案</li></ul><p>在线计算平台方向</p><ul><li>作为一种资源，对应用透明</li><li>高效可依赖(高并发、短时延)</li></ul><h3 id="管道和流程的自动化"><a class="markdownIt-Anchor" href="#管道和流程的自动化"></a> 管道和流程的自动化</h3><p>能够快速部署，稳定工作流程（触发训练、部署以及运行等工作）快速运行。</p><p><strong>在调度过程中，定义两个组件Job和Flow，抽象工作流的各个步骤和依赖关系</strong><br /><strong>Job</strong>：机器学习流水线的一个步骤</p><figure class="highlight dust"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br><span class="line">20</span><br><span class="line">21</span><br><span class="line">22</span><br><span class="line">23</span><br><span class="line">24</span><br><span class="line">25</span><br><span class="line">26</span><br><span class="line">27</span><br></pre></td><td class="code"><pre><code class="hljs dust"><span class="language-xml"><span class="hljs-meta">&lt;?xml version=<span class="hljs-string">&quot;1.0&quot;</span>?&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml"><span class="hljs-tag">&lt;<span class="hljs-name">configuration</span> <span class="hljs-attr">xmlns:xi</span>=<span class="hljs-string">&quot;http://www.w3.org/2001/XInclude&quot;</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">xi:include</span> <span class="hljs-attr">href</span>=<span class="hljs-string">&quot;../application.xml&quot;</span>/&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>flow.job.name<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>feature.ad<span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>job.name<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>$</span><span class="hljs-template-variable">&#123;application.package&#125;</span><span class="language-xml">.$</span><span class="hljs-template-variable">&#123;flow.job.name&#125;</span><span class="language-xml">: $</span><span class="hljs-template-variable">&#123;bizdate&#125;</span><span class="language-xml"><span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>inputs.dir<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>$</span><span class="hljs-template-variable">&#123;application.output&#125;</span><span class="language-xml">/$</span><span class="hljs-template-variable">&#123;raw.ad.version&#125;</span><span class="language-xml">/$</span><span class="hljs-template-variable">&#123;bizdate&#125;</span><span class="language-xml">/raw/ad<span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>output.dir<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>$</span><span class="hljs-template-variable">&#123;application.output&#125;</span><span class="language-xml">/$</span><span class="hljs-template-variable">&#123;feature.ad.version&#125;</span><span class="language-xml">/$</span><span class="hljs-template-variable">&#123;bizdate&#125;</span><span class="language-xml">/feature/ad<span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml"><span class="hljs-tag">&lt;/<span class="hljs-name">configuration</span>&gt;</span></span><br></code></pre></td></tr></table></figure><p><strong>Flow</strong>：各个步骤之间的依赖关系。</p><figure class="highlight xml"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br></pre></td><td class="code"><pre><code class="hljs xml"><span class="hljs-meta">&lt;?xml version=<span class="hljs-string">&quot;1.0&quot;</span>?&gt;</span><br><br><span class="hljs-tag">&lt;<span class="hljs-name">flow</span> <span class="hljs-attr">name</span>=<span class="hljs-string">&quot;feature&quot;</span>&gt;</span><br><br>  <span class="hljs-tag">&lt;<span class="hljs-name">node</span>&gt;</span><br>    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>raw.ad<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span><br>  <span class="hljs-tag">&lt;/<span class="hljs-name">node</span>&gt;</span><br><br>  <span class="hljs-tag">&lt;<span class="hljs-name">node</span>&gt;</span><br>    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>feature.ad<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span><br>    <span class="hljs-tag">&lt;<span class="hljs-name">dependencies</span>&gt;</span>raw.ad<span class="hljs-tag">&lt;/<span class="hljs-name">dependencies</span>&gt;</span><br>  <span class="hljs-tag">&lt;/<span class="hljs-name">node</span>&gt;</span><br><br><span class="hljs-tag">&lt;/<span class="hljs-name">flow</span>&gt;</span><br></code></pre></td></tr></table></figure><h3 id="数据和模型版本管理"><a class="markdownIt-Anchor" href="#数据和模型版本管理"></a> 数据和模型版本管理</h3><p>在机器学习项目中，数据科学家不断致力于开发模型，这个过程需要尝试不同的数据、参数和算法组合。一个可以在新旧实验中来回进行的环境是非常重要的，可以做有效对比。</p><p><strong>通过路径区分版本</strong><br /><strong>Version</strong>：配置当前flow的各个步骤</p><figure class="highlight dust"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br><span class="line">8</span><br><span class="line">9</span><br><span class="line">10</span><br><span class="line">11</span><br><span class="line">12</span><br><span class="line">13</span><br><span class="line">14</span><br><span class="line">15</span><br><span class="line">16</span><br><span class="line">17</span><br><span class="line">18</span><br><span class="line">19</span><br></pre></td><td class="code"><pre><code class="hljs dust"><span class="language-xml"><span class="hljs-meta">&lt;?xml version=<span class="hljs-string">&quot;1.0&quot;</span>?&gt;</span></span><br><span class="language-xml"><span class="hljs-tag">&lt;<span class="hljs-name">configuration</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>application.version<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>v1<span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>raw.ad.version<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>$</span><span class="hljs-template-variable">&#123;application.version&#125;</span><span class="language-xml"><span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml">  <span class="hljs-tag">&lt;<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">name</span>&gt;</span>feature.ad.version<span class="hljs-tag">&lt;/<span class="hljs-name">name</span>&gt;</span></span><br><span class="language-xml">    <span class="hljs-tag">&lt;<span class="hljs-name">value</span>&gt;</span>$</span><span class="hljs-template-variable">&#123;application.version&#125;</span><span class="language-xml"><span class="hljs-tag">&lt;/<span class="hljs-name">value</span>&gt;</span></span><br><span class="language-xml">  <span class="hljs-tag">&lt;/<span class="hljs-name">property</span>&gt;</span></span><br><span class="language-xml"></span><br><span class="language-xml"><span class="hljs-tag">&lt;/<span class="hljs-name">configuration</span>&gt;</span></span><br></code></pre></td></tr></table></figure><h3 id="用于机器学习的cicd"><a class="markdownIt-Anchor" href="#用于机器学习的cicd"></a> 用于机器学习的CI/CD</h3><p>MLOps = ML + DEV + OPS</p><p><strong>持续集成（CI）</strong><br />ML中的持续集成意味着每次更新代码或数据时，ML管道都会重新运行，这是以所有内容都是版本化和可重现的方式完成的，因此可以跨项目和团队共享代码库。每次重新运行都可能包括训练、测试或生成报告，从而更容易在生产环境中其他版本之间进行比较。</p><p><strong>持续部署（CD）</strong><br />持续部署是一种将新版本自动部署到生产环境或任何环境的方法。这种做法更容易接收用户的反馈，因为变换更快、更稳定，以及用于再训练或新模型的新数据。</p><p><strong>实践：统一线上线下的特征抽取模块</strong>：<br />线上线下公用一套特征抽取模块，线上server定期加载模型，离线训练好的模型+配置+特征抽取的so一起推送到线上的服务器。<br /><img src="https://static.v2grad.com/img/202206041219715.jpeg" alt="统一线上线下的特征抽取模块" /></p><ul><li><strong>代码的一致性(即处理流程一致性)</strong>：不同语言即使是相同的代码逻辑和运算方法，也可能存在语义上的不一致性，所以必须在Online和Offline使用同一套代码。我们使用C++将特征抽取的代码封装在一个so中，Online编译时链接这个so，Offline使用Java的JNI技术调用so中的代码。</li><li><strong>配置的一致性</strong>：要实现灵活的特征抽取而不是每次都去修改代码，就需要将特征抽取的过程做成可配置化的，我们首先在代码内部建立字母代号和特征抽取的映射关系，这样单特征我们用字母表示，组合特征的配置就可以直接使用多个字母的组合表示，使得整个特征抽取的逻辑可配置度非常高。</li><li><strong>数据的一致性</strong>：输入数据的结构也需要Online和Offline一致，我们将特征抽取的输入定义成一个Protobuf的格式，线上线下都向同一个protobuf填充数据。</li></ul><h3 id="模型的持续监控"><a class="markdownIt-Anchor" href="#模型的持续监控"></a> 模型的持续监控</h3><p><strong>离线监控</strong><br /><img src="https://static.v2grad.com/img/202206041208176.png" alt="离线监控" /></p><p><strong>在线监控</strong><br />在线服务性能监控：<br /><img src="https://static.v2grad.com/img/202206041212110.png" alt="在线服务性能监控" /></p><p>在线模型指标监控：<br /><img src="https://static.v2grad.com/img/202206041212773.png" alt="在线模型指标监控" /></p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><p><a href="https://zhuanlan.zhihu.com/p/357897337">从小作坊到智能中枢: MLOps简介</a><br /><a href="https://ml-ops.org/">Machine Learning Operations</a><br /><a href="https://www.deeplearning.ai/wp-content/uploads/2021/06/MLOps-From-Model-centric-to-Data-centric-AI.pdf">MLOps: From Model-centric to Data-centric AI / Andrew Ng</a><br /><a href="https://www.bilibili.com/video/BV1WB4y1P7Hw">吴恩达新课：从以模型为中心到以数据为中心的AI / Andrew Ng</a><br /><a href="https://neptune.ai/blog/data-centric-vs-model-centric-machine-learning">Data-Centric Approach vs Model-Centric Approach in Machine Learning</a><br /><a href="https://services.google.com/fh/files/misc/practitioners_guide_to_mlops_whitepaper.pdf">Practitioners guide to MLOps WhitePaper / Google</a><br /><a href="https://cloud.google.com/architecture/mlops-continuous-delivery-and-automation-pipelines-in-machine-learning?hl=zh-cn#mlops_level_0_manual_process">MLOps：机器学习中的持续交付和自动化流水线 / Google Cloud</a><br /><a href="https://static.googleusercontent.com/media/research.google.com/zh-CN//pubs/archive/aad9f93b86b7addfea4c419b9100c6cdd26cacea.pdf">The ML Test Score:A Rubric for ML Production Readiness and Technical Debt Reduction /  E.Breck / 2017</a></p>]]>
    </content>
    <id>https://v2grad.com/2022/06/10/mlops/</id>
    <link href="https://v2grad.com/2022/06/10/mlops/"/>
    <published>2022-06-10T02:00:00.000Z</published>
    <summary>MLOps是机器学习时代的DevOps，它是一组用于数据科学家和运维人员之间协作和沟通的最佳实践，其目标是减少技术摩擦，使模型在尽可能短的时间内将想法投入生产，同时尽可能降低风险。</summary>
    <title>MLOps的概念、原则和实践</title>
    <updated>2022-06-09T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="读书笔记" scheme="https://v2grad.com/categories/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="读书笔记" scheme="https://v2grad.com/tags/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <content>
      <![CDATA[<p>第一次知道李玫瑾老师是在网上看到他关于家庭教育的演讲视频，听了以后对里面的很多内容非常认同。这是我读的第一本关于育儿的书，这本书从理论到实操给了一份完整的家庭教育方案，是值得反复阅读和实践的好书。心理抚养主要包括<strong>情感、性格、观念、能力</strong>四个方面，父母必须参与心理抚养的全过程，通过陪伴、关爱、获得孩子的依恋感，进而获得管教孩子、“立规矩”的资本。家长通过参与孩子成长，进行情感抚育，教他做人做事，这种心理抚养比满足孩子的物质需求更重要。</p><h2 id="关于作者-李玫瑾"><a class="markdownIt-Anchor" href="#关于作者-李玫瑾"></a> 关于作者 - 李玫瑾</h2><p><img src="https://static.v2grad.com/img/202204240953392.jpeg" alt="李玫瑾" /><br />李玫瑾，著名犯罪心理学家，中国关心下一代工作委员会委员，中国预防青少年犯罪研究会副会长，中国家庭教育学会常务理事，代表作有《谁在犯罪》。她通过三十余年的教学与研究发现，<strong>人的心理问题与早年的养育息息相关，由此提出了人的养育要关注早年心理抚养</strong>，尤其要关注与人性相关的情感、与命运相关的性格等观点。她的相关讲座被广泛传播，以其内容为主的著作 <strong>《幽微的人性》</strong> 也因此广受好评。</p><h2 id="家庭教育很重要"><a class="markdownIt-Anchor" href="#家庭教育很重要"></a> 家庭教育很重要</h2><blockquote><p>人的胃口是喂出来的，脾气是带出来的，观念是唠叨出来的，残忍是孤弱无助熬出来的，无耻是百般迁就宠溺出来的。</p></blockquote><p>人，其实是“<strong>养育+教育</strong>”的产品。学校教育之前的<strong>家庭养育</strong>，尤其是<strong>心理抚养</strong>的好坏，可以影响乃至决定人的一生。因为决定一个人有没有“<strong>人味</strong>”，要看他对人间悲欢离合的感悟，以及他带给别人和社会的感受。一个人能让身边的人感到舒服和幸福，能为社会做出贡献，这应该是父母最开心的事。能养育出这样的孩子就是父母最大的功德。</p><h3 id="孩子的问题是成人造就的"><a class="markdownIt-Anchor" href="#孩子的问题是成人造就的"></a> 孩子的问题是成人造就的</h3><p><strong>&gt;所有社会问题其实都是人的问题</strong></p><p>社会其实是一个责任说不太清的世界。社会即使有责任，也要落实到每一个人身上。</p><p><strong>&gt;人的问题源于早年的养育</strong></p><p>问题往往不是出在眼前，而是源于过去。人成年后的问题基本上都可以在他早年的经历中找到影子。</p><p>一个从小没有被爱过的人，怎会懂得爱别人？一个从小没有感受过快乐的人，怎会拥有阳光健康心态？一个从小没有被尊重过的人，怎会尊重他人的权利？一个从小没有被善待过的人，怎会善待他人？</p><p><strong>&gt;孩子的问题多由身边的大人造就</strong></p><p>“<strong>不教而善</strong>”需要两个条件：一是孩子一直跟父母在一起生活；二是父母的言谈举止表现出来的都是善良、正派，即父母本身就是非常好的人。有的父母非常自律，认真工作，顾及家庭，还爱学习，爱思考，爱在家里讨论问题，孩子耳闻目睹就会潜移默化，不教而善。</p><p>抓家庭养育，关键是要抓家长，而不是抓孩子。看到孩子的问题时，家长要先想想自己有什么责任，以往哪些地方做得不太好，想明白了就赶快调整。家长一调整，孩子也就跟着调整了。</p><h3 id="亲自陪伴比物质更重要"><a class="markdownIt-Anchor" href="#亲自陪伴比物质更重要"></a> 亲自陪伴比物质更重要</h3><p>养育孩子这件事，并不是有钱就能解决好的。与其给孩子挣钱，不如亲自陪伴孩子。与其给孩子存钱，不如教孩子如何为人处世。<strong>对于年幼的孩子来说，他不在乎家里有钱还是没钱，只希望父母不要离开他。</strong></p><p>在人的成长过程中，亲情陪伴比金钱重要得多。孩子早年最需要的不是家里有钱，而是一个温馨的家。只要有父母在身边陪着，哪怕家里并不富裕，孩子也会感到幸福。</p><p><strong>&gt;家庭结构齐全不等于功能健全</strong></p><p>虽然房屋是家庭的必备住所，但是，没有生活味道的房子不是家。</p><p>家庭最基本的功能是什么？是家人生活在一起，互相照顾，互相温暖，还有育儿和养老，这些都需要花时间相伴。缺爱的心灵就像荒漠，心理贫困有时比经济贫困更让人绝望。</p><p><strong>&gt;家庭功能体现在父母的修为中</strong></p><p>人的问题在早年，早年的问题在家庭，家庭的问题在家长，而家长的问题在婚姻。有子女的婚姻不单单是夫妻两个人的事情了。</p><p>无论是男性还是女性，性情好和有责任感最重要。那么，如何考察呢？一定要先看对方的父母关系好不好。如果对方父母恩爱、家庭和睦，你可以闭着眼睛跟他结婚。如果对方父母关系紧张，家庭成员感情冷漠、怨气十足，这种家庭要慎入。</p><p><strong>&gt;大人好好学习，孩子才能天天向上</strong></p><p>有的父母生而不养、养而不教或教而不当。让这些不称职的父母去“家长学校”学习，或许应成为一道法令。</p><p>孩子不是父母的私有财产，而是全社会的。如果一个孩子得到很好的养育，长大后成为栋梁，就会造福社会。相反，如果一个孩子没有养育好，长大后成为犯罪人，将是社会的灾难。所以，养育孩子不仅是父母的责任，社会也有义务提供相应的支持。</p><h2 id="什么是心理现象"><a class="markdownIt-Anchor" href="#什么是心理现象"></a> 什么是心理现象</h2><blockquote><p>心理学最重要的是帮助人认知自己。研究人的心理，即是在研究“心理现象”.</p></blockquote><p>现在给孩子做思想工作越来越难，主要是因为孩子接受信息的渠道很多，你说的道理他都懂。<strong>思想</strong>，即认识，属于心理活动中有意识的内容之一，我们做思想工作是在这一层；<strong>心理</strong>，更为复杂，包含多种影响并决定人行为的内容，心理似乎永远寄居在躯体内，是一种可以支配、引领、决定躯体活动方向与活动方式的力量。</p><p>我们 <strong>研究人的心理，即是在研究“心理现象”</strong>，有时也用“精神”来形容，属于摸不着、抓不住的存在。如果用最简约的方式来表述一个正常人的<strong>心理现象</strong>涉及什么的话，那么，至少包括以下六个内容：</p><ul><li>一是决定心理现象发生的遗传与<strong>生理基础</strong>；</li><li>二是决定人一生心理基础的早期<strong>心理发展</strong>内容；</li><li>三是对心理内容进行分层管理、存储与提取的<strong>意识活动</strong>；</li><li>四是人与外界互动及对外反应的<strong>认识活动</strong>；</li><li>五是显现心理活动的动向和程度的<strong>情绪情感</strong>；</li><li>六是体现个人心理风格与特性的<strong>人格或个性</strong>。</li></ul><p><img src="https://static.v2grad.com/img/202204190630771.png" alt="心理现象" /></p><h3 id="生理基础"><a class="markdownIt-Anchor" href="#生理基础"></a> 生理基础</h3><blockquote><p>相当于电脑的硬件</p></blockquote><p><strong>&gt;遗传与生理相当于“心理硬件”</strong></p><p>不可否认，心理品质的基础取决于遗传，所以优生优育很重要。</p><p><strong>&gt;人的心理遗传中包含着祖上的修为</strong></p><p>人生经历形成的记忆不仅停留在相关的神经细胞中，还会遗传给后代。这意味着我们今天学习和努力的经历，会成为下一代甚至是下下一代的能力。</p><p>中国古人讲“祖上积德，福泽子孙”，这是一种很高的智慧。所以，每个人在为人父母后，要为自己的血统和后代着想，注意自我修行，要自律，努力成为好父亲、好母亲。当然，前提是要先做个好丈夫、好妻子。</p><h3 id="心理发展"><a class="markdownIt-Anchor" href="#心理发展"></a> 心理发展</h3><blockquote><p>相当于系统软件，这是决定性的基础软件。家庭，就是人的心理系统软件制造商。</p></blockquote><p><strong>&gt;早年养育相当于系统软件编程</strong></p><p>家庭为孩子编写程序，首先是在人生的第一个六年。其中前三年，有血缘关系的抚养占据绝对主导的地位，后三年家庭生活仍是主导，只是有时候幼儿园的养护也加入进来，也具有编程资格。</p><p>从人生的第二个六年开始，父母把孩子送到学校去接受教育，学校开始加入人的软件编程过程中。学校编程与家庭编程最大的不同在于，家庭编写的是人基础的<strong>系统软件</strong>，而学校重点是编写<strong>应用程序</strong>。</p><p><strong>&gt;心理系统有缺陷会成终身“漏洞”</strong></p><p>就像系统软件在设计、编程时有漏洞和缺陷会影响电脑的性能一样，如果人早年的家庭养育有缺陷，在随后的人生道路上就容易麻烦不断，甚至半路夭折。家长要明白，<strong>孩子六岁之前的养育，谁都无法替代，谁都无法扭转</strong>。</p><p><strong>家庭是养育的场所，养之育</strong> 需要家长在照顾、陪伴孩子的过程中培养情感，以浸润的方式告知或带领孩子学习如何做人做事。而 <strong>学校是教育的场所，教之育</strong> 是老师在规范的要求下，在一视同仁的背景下，以讲授和练习的方式让学生学习知识。</p><h3 id="意识活动"><a class="markdownIt-Anchor" href="#意识活动"></a> 意识活动</h3><blockquote><p>相当于电脑的C盘，具有储存系统文件等功能。这些文件就像人的无意识内容，虽然具有重要的功能，但人平时并不十分清楚它们的存在。</p></blockquote><p><strong>&gt;意识水平标志着人的心理水准</strong></p><p>意识是人的一种觉知状态，包括人对外界的觉知和对自己的觉知。</p><p>人的意识可以发展出不同的层次，从最初的自然意识到社会意识，再到自我意识。</p><ul><li><strong>自然意识</strong>是人一出生就有了，正常婴儿对温度、光亮、声音等外界刺激都有觉知。</li><li><strong>社会意识</strong>起源于人对他人的认知。当婴儿半岁左右开始出现认人的现象时，就意味着他对与自己有关系的人有觉知了。到三至五岁时，孩子一般会寻找同伴了，开始出现社会关系的意识。例如，孩子听到别的小朋友喊爸爸妈妈，会知道那不是自己的爸爸妈妈。</li><li><strong>自我意识</strong>大概出现在两三岁时。当孩子能够表达自己的感受，比如说“我饿了”或“我肚子疼”，说明他对自己有觉知了。</li><li><strong>自我反思意识</strong>，一般要到18岁以后才会出现，人有了在思维中反观自己的能力，也就是自我反思意识。有这个本事的人可以不用别人告知，自己就知道错在哪儿了，然后通过提高自我修养来改善。自我反思意识需要拥有成熟的社会意识和抽象思维，是人心理成熟的重要标志。</li></ul><p><strong>&gt;缺少自我反思意识的人心理不成熟</strong></p><p>缺少自我反思意识的人往往是“因变量”，总指望别人的改变来改变现实，永远不知道自己该如何成为主动的“自变量”。遇事只期待别人改变，这是将自己的命运系于别人身上的表现。这种人在社会生活中一定会遇到很多挫折。</p><p><strong>&gt;跳出自我中心，才能更好地识人识己</strong></p><p>想认识自己，也需要多听听别人的看法。跳出自己的视野，去了解别人的想法，从而能够反观事情的真相。</p><h3 id="认识活动"><a class="markdownIt-Anchor" href="#认识活动"></a> 认识活动</h3><blockquote><p>认识就相当于我们每天使用电脑的活动，我们要不停地移动鼠标，敲击键盘，输入信息，储存或等待处理结果，然后完成任务要求，看到最终结果显示在屏幕上。这个过程就像我们睁开双眼，移动手脚，在不同地方通过感官（眼、耳、鼻、舌、身）接收各种外界信息，有的信息进入我们的“内存”（记忆），有的信息进入“中央处理器”（思维），然后我们做出反馈（反应）。</p></blockquote><p><strong>&gt;改变认识是做思想工作的重点</strong></p><p>做思想工作主要针对人的认识问题，并不能解决很多心理问题。</p><p>当一个人的心理出现问题，如果你不了解人的心理整体的发生原理，只看到显现的问题表面，只用一种方法，即点击鼠标或敲击键盘，用输入信息的方式不停地给他讲道理、提要求，可能他的程序已经发生冲突或者内存已满，结果只会适得其反。</p><p>教育孩子也是同样的道理。许多父母不懂心理学，一天到晚只会耐心地给孩子讲道理。有些母亲就不解地问我：“我对孩子特别好，从不吼他，总是耐心地给他讲道理，可他总躲着我，就怕我说话。这是怎么回事？”我说：“你的声音就是他恐惧的原因。因为你的话太多了，你总是重复类似的话，比如‘好好学习’‘多看书’‘别惹事’，他天天听，早就烦了。”</p><p><strong>&gt;让心理困扰者自我成长是心理咨询的要义</strong></p><p>心理咨询并非给人出主意。优秀的心理咨询师不会给你出主意，而是帮助你<strong>认清自己</strong>，引导你去寻求解决之道。</p><p>心理咨询与做思想工作有一点不同：做思想工作是主导者在说，对方要听着，被动接受；心理咨询则是主导者在听，让对方说，然后用提问的方式让对方思考答案，并自己意识到问题所在。</p><p>为什么我们过去做思想工作很有效呢？因为在信息闭塞的年代，缺乏信息的人容易出现认知狭隘，当有知识、有阅历、有思想的人讲出他所不懂、所不知的道理时，就能让他改变原有的认识。</p><h3 id="情绪情感"><a class="markdownIt-Anchor" href="#情绪情感"></a> 情绪/情感</h3><blockquote><p>当我们打开电脑，开始移动鼠标、敲击键盘时，就开始了人机互动。输入信息以后，电脑就开始处理了，我们如何知道结果呢？观察电脑内部活动的窗口主要是屏幕，还有声音和鼠标移动的状态。打个比方，电脑屏幕相当于人的面部表情，声音相当于人的言语，移动鼠标相当于人的肌肉运动。</p></blockquote><p><strong>&gt;情绪是观察心理的窗口</strong></p><p>情绪是人的<strong>心灵之窗</strong>，情绪的表达能让内心活动显露于外。因此，要洞悉人的心理，可通过情绪这个窗口来观察。观察心理的三个窗口：面部表情，言语或文字，行为举止。</p><p>情绪也是人的<strong>心理温度计</strong>，我们可通过观察表情、言语和动作来了解一个人的情绪温度。情绪表达的四个层次：微表情情绪，表情情绪，声音情绪，动作情绪。</p><p>最好的情绪表达方式是言语沟通，你可以表达你的想法和建议，但不必强求别人接受。</p><p>当人被他人的言语、动作等冒犯后感到不快时，不能一味忍受，该表达就要表达，不然会郁闷，但表达时又不能太过，要适度和有节制。这种分寸感，很多人觉得很难把握。</p><p><strong>&gt;情绪需要表达，更需要管理</strong></p><p>如果你有情绪了，却不表达出来，那叫压抑，容易得癌症。但是，如果你一遇事就表达强烈的情绪，如发飙、怒发冲冠，那也容易得心血管病，比如心源性猝死。</p><p>情绪管理的重要表现就是能做到情绪自律。情绪自律可以彰显一个人的修养水平，也标志着一个人的心理发展水平。</p><p><strong>&gt;情绪宜解不宜结，否则容易得“心癌”</strong></p><p>人生就像一条顺时延伸的线，如果你一直纠缠于已经过去的某件事，摆脱不掉痛苦，你的人生线就在这里打了一个结，也就是心结。就像你体检时发现身体里有个结节一样，并不是什么好事。</p><p>心结的特点是，起因于过去某次失败的反应，纠结于失败的痛苦感受，执着于对过去失败的挽回。心结使人不再关注现在与未来，也不考虑这样执意不放手是否合理，而是消耗全新的每一天去守着那个已经过去的失败。</p><p>如何化解不良情绪呢？下面介绍三种简单易行的方法：一是有意去<strong>运动</strong>。当你感受到不良的情绪，尤其是真的很气愤，有气没地方撒时，不妨冲出去跑几千米。当你跑得上气不接下气时，闷气自然就消散了；二是<strong>寻找美好的感觉去体验</strong>。比如，你可以听音乐或看喜欢的影视剧，沉浸其中感受另一种良好的情绪，以此摆脱不良情绪的感受和记忆；三是<strong>找朋友聊天或吃饭</strong>。虽然吃胖了不好，但美食确实能让人身心愉悦，能吃者大多没有过不去的坎。当然，能吃者也要消耗大，多运动仍是必要的。</p><h3 id="个性人格"><a class="markdownIt-Anchor" href="#个性人格"></a> 个性/人格</h3><blockquote><p>个性和人格就相当于计算机的性能，如果一台电脑运行速度快，存储空间大，键盘反应灵敏，屏幕显示稳定，性能就很好。同样，我们评价一个人，如果一个人身体健康，有良好的家庭养育与学校教育背景，头脑聪明，见多识广，心胸开阔，情绪稳定，善于沟通，个性就很好。</p></blockquote><p><strong>&gt;个性是人的“心理名片”</strong></p><p>心理学给“个性”下的定义是：一个人独特、稳定、整体的心理倾向和心理特征。一个人的个性一旦稳定下来，就会在行为中处处体现他的风格，所以个性又称人格。个性是一个人的“心理名片”，他就是他，你就是你。</p><p>当我们强调一个人与众不同即独特时，常用“个性”来表述。当我们强调一个人方方面面都带有某种整体风格或惯性时，常用“人格”来表述。</p><p>个性包含心理倾向和心理特征两部分。其中，心理倾向包括人的<strong>需要、兴趣、三观、信仰</strong>等，这些会影响人在生活中的关注点、追求、取向等。前两项即需要和兴趣可以成为人的心理动力，后两项即三观和信仰则可以决定人生的方向。</p><p><strong>&gt;危险人格的形成往往与家庭养育方式有关</strong></p><p>根据人格形成的不同背景，我把危险人格分为两类：一类是以先天禀赋为主的危险人格，即反社会人格；另一类是以后天养成为主的危险人格，包括犯罪人格和缺陷人格两种。</p><p>所谓“匮乏性抚养”，主要是指没有情感与关爱的抚养。有些父母生而不养，使孩子过早处于自生自灭的境地。当弱小的孩子不得不挣扎着自求生存时，往往会不择手段，渐渐走上违法的道路，甚至一生与犯罪为伍。</p><h2 id="人的心理发展路径"><a class="markdownIt-Anchor" href="#人的心理发展路径"></a> 人的心理发展路径</h2><blockquote><p>人的心理也有着内在的发展路径。一个人今天表现出来的心理特点、心理风格，一定跟他过去的经历有关。</p></blockquote><h3 id="心理发展时期表"><a class="markdownIt-Anchor" href="#心理发展时期表"></a> 心理发展时期表</h3><p><img src="https://static.v2grad.com/img/202204220625229.png" alt="人的心理发展时期表" /></p><p>以百年为大致框架，把人的心理发展分为10个时期：乳儿期（0～1岁）、婴儿期（1～3岁）、幼儿期（3～6岁）、学龄初期（6～12岁）、青春初期（12～15岁）、青春后期（15～18岁）、青年初期（18～25岁）、青年后期（25～35岁）、中年期（35～60岁）和老年期（60岁以上）。</p><p>大致而言，人一生的身心变化如下：</p><ul><li>0～1岁时，人主要在养育者的怀里吃奶，还不能自由行动。</li><li>2～3岁时，人还不能很好地控制大小便，生活还不能自理，动辄需要大人帮忙。</li><li>3岁时，人的自由度比以前大很多，但仍不能独自行动，需要人看护。</li><li>6岁时，人基本上可以衣食自理了，可以离家去学校接受基础教育了。</li><li>12岁左右时，人开始性发育了，随后身高迅速达到成年人的高度，于是经常觉得自己已经长大了，想自己处理问题了。</li><li>15岁时，人的身体发育接近成熟，开始对异性、对成年人的事情和世界感兴趣了。</li><li>18岁时，人的身高基本定型了，性发育完成了，认知能力也接近成熟了，意味着拥有独立选择、判断与反应的能力，在多数情况下能自我保护了。</li><li>25岁左右时，很多人已找到能养活自己的工作了，并开始组建家庭，不久将为人父母。</li><li>35岁左右时，很多人工作上已逐渐步入正轨，开始独当一面，在社会不同的位置上努力发展着，但养育孩子相当耗费时间和精力。他们就这样忙忙碌碌，当孩子已成年、父母已年老时，自己也年过六旬了。</li><li>60岁以后，人们逐渐退出社会职务，治疗过去因操劳积累的病痛，开始注重养生。如果身体养好了，再活60年的人也有，但究竟能活多久则因人而异。</li></ul><h3 id="心理发展阶梯递进"><a class="markdownIt-Anchor" href="#心理发展阶梯递进"></a> 心理发展阶梯递进</h3><p><img src="https://static.v2grad.com/img/202204220641520.png" alt="人的心理发展四个重要台阶" /></p><p><strong>&gt;情感，需要抚养。这是心理发展的第一个台阶，主要由家中的哺乳者来完成。</strong></p><p>情感抚养是在孩子还不能自主行动的情况下，发出每一次呼喊时，抚养人能及时回应并照顾到位。当情感抚养到位时，孩子就会记住抚养人的气味、声音和相貌，因为这个人是他快乐的来源。这样持续四个月到半年，孩子就会出现人生的第一份情感——<strong>依恋</strong>。这是初来人世间的人对这个世界最初的情感。孩子依恋的对象就是自己稳定的抚养人，只眷恋并信任这个人。</p><p>当依恋情感能够持续地得到满足时，孩子就会对外界产生信任感和安全感，心扉就比较开放，容易继续发展亲情、伙伴情等。而且，当依恋关系建立起来后，抚养人就有资本对孩子说“不”，为下一个台阶即性格教养奠定基础。</p><p>依恋情感是人心理发展的起点，也是其他心理内容发展的基础。最重要的是，情感是人性的核心，有情感就有人性，毫无情感则毫无人性。</p><p><strong>&gt;性格，需要教养。这是心理发展的第二个台阶，主要由孩子所依恋的人在家庭生活中完成。</strong></p><p>性格教养与情感抚养最重要的不同在于，情感抚养更多的是要照顾和满足孩子，而性格教养更多的是要规范和约束孩子。</p><p>所谓性格，是指人在后天形成的与他人有关的社会行为方式。</p><p><strong>&gt;能力，需要培养。这是心理发展的第三个台阶，主要由不同层级学校的老师通过教育活动来完成。</strong></p><p>能力包括智能、技能、特殊能力等。其中，智能是基础性能力，具有遗传的背景；特殊能力是具有个人天赋色彩的能力；技能则需要后天通过努力学习和训练才能获得。</p><p>能力与个人的两个因素有关：一是先天禀赋，二是后天努力。其中，个人的刻苦努力是一个非常艰辛的过程，有良好的性格教养作为基础会顺利得多，否则容易半途而废。</p><p><strong>&gt;自我，需要修养。这是心理发展的第四个台阶，由独立进入社会生活的个体自己来完成。</strong></p><p>自我，在这里是指一个人对自己的认识和要求。</p><p>人一旦成年，许多事情就需要由自己来独立判断或决定，其结果好坏通常要由他人和社会的反应来衡量。成熟的人可将社会生活中好的人物作为自己的榜样，或者通过阅读，把好书当作心灵导师，活到老学到老，不断提高自己的修养。</p><h3 id="各阶段养育方法"><a class="markdownIt-Anchor" href="#各阶段养育方法"></a> 各阶段养育方法</h3><p><strong>&gt;养育的最佳时期是依恋期0～12岁</strong></p><p>父母与孩子的亲缘，最浓时分就在依恋期。好好珍惜孩子的依恋，这是父母未来教育孩子的一种心理资本。<br /><img src="https://static.v2grad.com/img/202204220940652.png" alt="人生各个心理期及年数" /></p><p>如果把这18年平均分成三段，即0～6岁、6～12岁和12～18岁，哪个年龄段包含的时期最多？答案显而易见：6岁之前排第一，包含乳儿期、婴儿期和幼儿期三个时期；青春期排第二，包含青春初期和青春后期两个时期；只有第二个六年即学龄初期仅一个时期，弗洛伊德称之为“潜伏期”。<strong>每个年龄段的时期多与少意味着什么？时期多意味着这个年龄段的变化多，变化多意味着可塑性强，而可塑性强意味着这是育人的最佳时期。</strong></p><p><strong>&gt;青春期最需要父母的智慧12～18岁</strong></p><p>人生也有转型期，青春期就是人从依恋到独立的一个重要转型期。对这个时期孩子的各种挣脱表现，养育者“不急”是唯一的破解之道。</p><p>若是孩子在青春期出现敌对情绪，父母一定要耐心和坚忍，记住“<strong>和善而坚定</strong>”的原则，更要有“<strong>船急不可猛掉头</strong>”的意识。若与孩子发生冲突，父母切忌只表达自己的看法，不要用要求、命令、强制等方式，那样会激发孩子的青春冲动。</p><p><strong>&gt;对成年子女要学会放手与接受18+岁</strong></p><p>有人说，放手的爱，是母鹰亲手将雏鹰推下悬崖那一刻的痛心与坚定。</p><p>在成年阶段，人的心理发展共分四个时期，即青年初期、青年后期、中年期和老年期。其中，青年初期（18～25岁）又称成年初期，是四个时期中最短的一个，约持续七年。</p><h2 id="0~3岁的心理抚养"><a class="markdownIt-Anchor" href="#0~3岁的心理抚养"></a> 0～3岁的心理抚养</h2><blockquote><p>心理抚养是心理发生和发展的第一个台阶，即人性的唤醒与情感关系的建立。</p></blockquote><h3 id="心理抚养影响孩子的几个方面"><a class="markdownIt-Anchor" href="#心理抚养影响孩子的几个方面"></a> 心理抚养影响孩子的几个方面</h3><ul><li><strong>情感</strong>：情感的心理抚养必须是无假的爱，一个人的情感发展取决于他生命的第一年，是否在抚养中拥有出于真正的爱而给予的足够耐心、细心、宽容，甚至小小的纵容。对于一岁之内的初生儿，爸妈大可放开地去爱他，给他足够的情感营养，用你的身体、你的拥抱、你的抚慰、你的笑容、你的声音去表达爱，而不能用钱或借他人之手间接表达你的爱，那是被偷工减料的心理营养。</li><li><strong>脾气/气质</strong>：脾气的心理抚养是及时到位的照应，一个成年人脾气暴躁，大致可以判断他在一岁之内的心理抚养是贫困的。暴脾气的人多在生命初期被亏待过，我们要努力改变以往那种粗放型的养育方式，要养性情平和的人，而不要养太多那种“哭着长劲”的暴脾气的人。</li><li><strong>言语</strong>：言语的心理抚养是耳边人声丰富，一个可爱的小话痨，意味着他从小就享受着多人的宠爱。言语，是人在社会活动中非常重要的能力之一。不善言语表达的人，往往在人际关系上、在社会活动中都表现得较为消极，甚至出现口讷、语迟、自卑等。这种人往往在与人交流或沟通时出现障碍。</li><li><strong>亲社会行为/善良</strong>：一个从小没有被人善待过的人，你不要指望他长大后能够善待这个社会。一个小孩看到别人没有按电梯，就主要提醒别人并帮助别人，孩子虽不认识别人，却不怯生，主动搭讪，说明他是个喜欢与人亲近的孩子。这种心理表现在心理学中有一个专门的术语，被称为“亲社会行为”。</li><li><strong>认知方式</strong>：如果说认知能力取决于智力，那<strong>认知方式则主要取决于后天与人互动形成的亲社会行为反应方式</strong>。情感、言语、亲社会行为的发展会深刻影响孩子的认知方式。如前所说，在多成员大家庭里长大的孩子，往往乐于与人接触和交流。相反，家庭成员少、抚养人单一背景下长大的孩子往往比较安静，不爱声张。这些看似是性格问题，其实与他的家庭抚养背景密切相关。重要的是，抚养背景还会影响孩子的认知方式。</li><li><strong>观念</strong>：何为观念呢？例如，你看了一部墨西哥电影，以后有人在你面前提到墨西哥这个国家时，你脑海里会立即闪现出这部电影的画面。脑海中有关墨西哥的印象、观念就是这部电影留下的画面。一个人的观念来自哪儿？那一定是他从小耳闻目睹、见得最多的情景，听得最多的声音，是那些在他眼前摇来晃去、一遇事情就唠唠叨叨的抚养人，最后<strong>父母在意并强调的东西会成为孩子的观念</strong>。观念往往体现了人的内心和行为的界限，甚至是底线，缺乏好的观念的人为人处世时往往是没有界限、没有底线的。所以说，<strong>观念决定人的行为好坏，有时还涉及人品优劣。</strong></li></ul><h3 id="心性健全首先要有人性"><a class="markdownIt-Anchor" href="#心性健全首先要有人性"></a> 心性健全首先要有人性</h3><p><strong>&gt;一个人有情感就有人性</strong></p><p>何为人性？一个人有情感就有人性。他若尚有情感，就尚有人性；他若毫无情感，他就毫无人性。</p><p>对人最有力、最无价的控制力量就是情感。越是弱者，越是一无所有的人，有时越需要一种柔软的情感去唤醒他的人性。</p><p>人性中的情感是养育而来的，人类生命初期的无能无助正是大自然的精心设计。自然的智慧还显现在越是低等的动物，它们在生命初期自立的能力就越强；相反，越是高级的动物，它们在生命初期自立的能力就越弱。</p><p><strong>&gt;依恋情感是第一份安全感</strong></p><p>类幼子在出生时，对外界几乎没有任何选择能力，有句俗语“有奶便是娘”说的就是这种情况，谁养孩子孩子就跟谁亲。这个养的过程大概经历一百多天，一般在四个月到半年内，孩子出现了他第一个主观表现，“认人”。</p><p>依恋的形成，需要一个稳定的抚养人。每当孩子有需要，这个人能马上出现，孩子就会身心愉悦。相反，孩子每次一睁眼，眼前晃悠的是不熟悉的人，就会害怕。所以，人早年缺少一对一的抚养，就容易焦躁。</p><p>依恋情感是教养孩子的心理资本，钱能生钱即资本，心理抚养就在于积累心理资本，你用辛苦付出拥有了他对你的依恋，你才拥有对他的心理影响和约束力。</p><p><strong>&gt;人的情感越丰富，人性就越丰满</strong></p><p>人性始于情感，一个人情感越丰富，人性越丰满，情感越单一，人性就越单薄。无论哪一种情感，只要一个人内心尚有部分情感，他就尚有人性；如果他毫无情感表现，这个人就毫无人性。</p><p>在孩子早年的成长过程中，亲自抚养和稳定抚养是非常重要的。连续稳定的抚养，可以影响孩子人格的形成。人格是一个人整体的、稳定的、独特的心理活动倾向和心理征象，其形成一直要持续到18岁，所以需要稳定的抚养。</p><p>父爱在幼儿的成长中不可或缺。凡是人性丰满、情感良好的人，一定有一对恩爱有加、相敬如宾的父母。</p><h2 id="3~6岁的心理教养"><a class="markdownIt-Anchor" href="#3~6岁的心理教养"></a> 3～6岁的心理教养</h2><blockquote><p>心理教养是心理发展的第二个台阶，是在初级情感基础上，让情感发展得更为完整。</p></blockquote><h3 id="心理教养塑造良好性格"><a class="markdownIt-Anchor" href="#心理教养塑造良好性格"></a> 心理教养塑造良好性格</h3><p><strong>&gt;不以规矩，不能成方圆</strong></p><p>行为界限和行为规矩，若在六岁前的养育过程中有意教导，他的行为就会体现出教养。</p><p>随事而教，制止与否，都会影响他今后社会行为方式的建立。对孩子某种不当的行为要不要马上制止，你当时的反应就是为他建立处事规则。</p><p>心理养育需要<strong>恩威并施</strong>，养孩子，不能不批评，也不能总是批评，当孩子反复出现同类错误时，就不能再简单地训斥了，而是找出他某次做得好的时候予以充分表扬和肯定。同时，也不能总是表扬——如果某类事情是他应该做的，过度表扬反而多余，以后做同类事情没听到表扬他会感觉若有所失。</p><p><strong>&gt;性格取决于后天养成</strong></p><p>什么是性格？简单说，性格是一个人后天形成的社会行为方式。其中有三个关键点，后天形成、社会行为和行为方式。“<strong>社会行为</strong>”的含义是指此种行为只会发生在与他人有关的活动中。“<strong>行为方式</strong>”的含义是指此种行为是较为固定的行为风格。“<strong>后天形成</strong>”是界定，既然社会行为与别人有关，那么人只有在出生后在与他人的互动中，将某种社会行为固定化，最后成为稳定的反应方式。</p><p>“后天形成的行为或反应”还有几个重要的特点：</p><ul><li>行为的第一次会对性格形成很大影响。</li><li>凡是与人互动的行为发生的时间越早，对成年后的性格影响也越大。</li><li>与互动的人关系是否稳定，抚养人互动模式是否一致，对其成年后的性格影响也很重要。</li><li>人进入青春期时（14周岁上下）性格基本成形，到成年后（18周岁）性格基本稳定。若超过此时再要求改变和重塑性格，那将十分困难。</li></ul><p><strong>&gt;性格决定命运</strong></p><p>好的性格能在心里有别人，这种性格不仅可以弥补相貌、外形等不足，还可弥补能力的不足。那些能在事业上成功并走得很远的人，那些能被人们敬佩与铭记的人，一定具有人类最基本的情感，有同情心，有责任感，能自制，肯付出，能够宽容不同性格，能够与人合作分享。这些助人成功的心理内容都不在智力的范畴，因此有人总结，性格决定命运。</p><p>性格决定命运，是因为社会行为方式决定人的行为轨迹，前面一步走错，后面步步错位。</p><ul><li>早年的娇生惯养和放纵，导致学习不努力，进而工作吃力，结婚后养家困难，离婚后一无所有，这种人生路径会越走越窄。如果你选择早年吃苦，从小日复一日地吃了很多的苦，你就一定会在吃苦过程中养成忍耐力，都说“吃苦耐劳”嘛，耐劳就是忍受辛苦。当你不怕辛苦，你就能控制自己的身体和心理，最重要的是能控制自己的“心”，就不会由着欲望乱来。</li><li>耐挫之心越早历练越好，人的躯体抗压性差别不大，抗压性差别最大的是人的内心，而内心的强大没有一个是靠天天夸奖夸出来的。</li><li>心理弹性需要从小练就，对孩子的爱不单单表现在呵护上，还表现在磨炼上。狠下心来磨炼孩子比呵护更难，更需要父母的勇气与胆量。</li></ul><h3 id="良好性格塑造方法"><a class="markdownIt-Anchor" href="#良好性格塑造方法"></a> 良好性格塑造方法</h3><p>当一个人通过家庭教养培养出<strong>自律能力</strong>时，他就能够对自己的欲望进行克制，不会轻易抛弃婚姻等以法律为名的承诺，不会轻易地放弃对父母的赡养或幼子的抚养；当他通过家庭教养培养出<strong>自省能力</strong>时，他会更加包容与自己个性不同的人，能够与人合作，进而有更大的社会作为；当他通过家庭教养培养出<strong>同情心</strong>，他对别人的苦难就会有一份更深切和博大的情感，进而主动承担社会责任，对生养自己的土地和人民怀有报效的情感。</p><p><strong>&gt;对三到六岁的孩子说“不”</strong></p><p>这一要求就是让孩子知道，哪些事可以做，哪些事不能做。可以做的事情，父母可以默许或者不表态，但不可以做的事情，父母应该在第一时间内制止孩子，并告诉他为什么。<strong>三岁之前有恩于他，从三岁开始立威于他，威就是威严</strong>。</p><p>管教孩子，需要家中大人们形成共识：<strong>管教角色不要越位，父母优先，家中任何一个人在管教孩子时，别人尽量回避。</strong> 当孩子出现任性哭闹、满地打滚，或摔东西、打人等不当行为时，家里的大人，顺序应该是妈妈在先，然后是爸爸，如果爸妈都不在，那么最好是他熟悉并依赖的那个人，与他形成一对一的关系。这是因为对孩子说“不”时要讲究说的环境，一定要让孩子单独面对一个人，而不要让他能看到别人，因为有其他人在场，聪明的孩子心里会知道，在场的人一定有人不忍心看他哭。</p><p><strong>&gt;性格历练</strong></p><ul><li><strong>与人沟通，学会讲理、互动</strong>：教会孩子一种重要的社会行为方式，有想法、有要求、有情绪时，要学会好好说话，不要闹。</li><li><strong>延迟满足练就耐性</strong>： 生活中的诱惑实在太多，一个没有耐性的人不可能有长远的未来，有些事做早了事倍功半，只有看准时机才会事半功倍。有许多事情“做与不做”不能仅凭自己“想与不想”，还必须要关注外部是否允许。在不被允许的情况下，要学会表达与沟通。那么，沟通不成呢？这需要进一步培养他第二个性格特点，即等待和忍耐，这是一个人能否将自己的价值提升至最大化的重要性格品质。</li><li><strong>诱惑训练，教其自我管理</strong>：培养孩子的耐性，尤其在他出现较强烈的欲望后，让其能够等待，延迟其满足。让孩子明白，生活中并不能事事如意。在不如意面前，要学会克制自己，忍耐并等待时机成熟，当通过与父母的共同努力实现愿望后，则能得到寓意更深和更有内容的满足。</li><li><strong>与人接触，学会礼貌为先</strong>：与人接触的言行需要从小有人教，进而养成言语文明的风格，这不仅会体现家庭的教养水准，也会使自身在良好的人际互动中如沐春风。</li><li><strong>与人相处，学会分享、包容</strong>： 人生不会总遇到投缘的人，我们随时会遇到与自己完全不同的人，能与各种人平和礼貌相处，这是一种涵养。在一个群体里生活，做事一定要考虑到别人。所以，在性格培养关键期，父母要有意地告诉孩子，只要有他人在场或在附近，都要考虑自己的行为是否会影响到别人。</li><li><strong>体力之苦练就坚韧意志</strong>：有一点需要明确，在生理与心理之间，生理是心理韧性或弹性的基础。简单说，要想让孩子心理坚强并有韧性，一定要从身体之苦进行磨炼。培养这种体力之苦可以在孩子四岁前后开始。在这方面，我给大家两个建议：孩子四岁左右，先让他练习跑步，然后让他学习游泳。</li></ul><h2 id="写在最后"><a class="markdownIt-Anchor" href="#写在最后"></a> 写在最后</h2><p>一个优秀的孩子不是一天两天形成的，而是父母长期的用心经营，并不断完善和改变自己来启发和引导逐步实现的。</p><p>幸福的人用童年治愈一生，不幸的人用一生治愈童年。</p><p>养育孩子，是父母的一场自我修行，努力当个好爸爸！</p>]]>
    </content>
    <id>https://v2grad.com/2022/04/24/reading-xin-li-fu-yang/</id>
    <link href="https://v2grad.com/2022/04/24/reading-xin-li-fu-yang/"/>
    <published>2022-04-24T02:00:00.000Z</published>
    <summary>人的胃口是喂出来的，脾气是带出来的，观念是唠叨出来的，残忍是孤弱无助熬出来的，无耻是百般迁就宠溺出来的。大人好好学习，孩子才能天天向上～</summary>
    <title>《心理抚养》读书笔记</title>
    <updated>2022-04-23T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="技术洞察" scheme="https://v2grad.com/categories/technical-insight/"/>
    <category term="Web3" scheme="https://v2grad.com/tags/Web3/"/>
    <content>
      <![CDATA[<p>目前和元宇宙一起，Web 3.0也是近段时间人们对下一代互联网讨论的热词，在宏观意义上，Web 3.0将是当前热议的<strong>元宇宙的底层网络架构</strong>，其核心思想是<strong>将生产和所有权交还给参与生态、使用平台的用户</strong>，而不是由互联网平台或者说控制互联网平台公司的少数人拥有。Web 3.0由分布式技术（区块链）支持得以展望和实践，不过目前仍处于早期萌芽阶段。</p><p><img src="https://static.v2grad.com/img/202204160715152.png" alt="Web3" /></p><h2 id="什么是web-30"><a class="markdownIt-Anchor" href="#什么是web-30"></a> 什么是Web 3.0</h2><p>Web 3.0，翻译为第三代互联网，目前并没有明确定义，我们将它描述为基于区块链技术的去中心化的互联网技术的合集，有新的技术、新的范式、新的组织形式以及对应的价值观世界观。</p><p>Web 3.0这个概念最初是由HTTP的发明者<strong>Tim Berners-Lee</strong>在互联网泡沫时期提出的，是指一个集成的通信框架，互联网数据可以跨越各个应用和系统实现机器可读。Web 3.0通常也被称作为“<strong>语义网”（Semantic Web）</strong>。</p><p>到了2014年，以太坊联合创始人、Polkadot创建者<strong>Gavin Wood</strong>在一篇名为《<strong>DApp：Web 3.0是什么</strong>》的博客文章中<strong>重新定义了Berner-Lee提出的这个词</strong>，用来指代一种区块链技术，可以基于“无须信任的交互系统”在“各方之间实现创新的交互模式”。</p><p>Gavin Wood这篇文章的重点并不是加密资产，而是共识引擎和密码学等协议和技术。这些协议和技术可以实现更强大的网络社会合约。他之后又阐述了Web3的终极目标，那就是“<strong>更少信任，更多事实（Less trust, more truth.）</strong>”。目前我们讨论的主要是Gavin Wood提出的Web 3.0的概念。</p><p>Web 3.0代表互联网的下一个时代，互联网形态向着更民主的范式转变，Web3源于人们对当今互联网价值的态度的转变: 互联网巨头控制着互联网和所有人的数据，Web3代表着，很多人出现了想创造一个真正“<strong>集体所有</strong>”互联网的想法。</p><blockquote><p>去中心化就是指去中心化服务器的点对点网络，在去中心化服务器网络中，没有服务器，没有中心，或者反之，到处都是服务器，到处都是中心节点。<br /><img src="https://static.v2grad.com/img/202204162110845.png" alt="去中心化" /></p></blockquote><h3 id="基本特性"><a class="markdownIt-Anchor" href="#基本特性"></a> 基本特性</h3><p>Web 3.0 目前为止仍未有标准定义，却有一些基本的特性，包括：<strong>去中心化（Decentralization）、去信任化与无权限化（Trustless and Permissionless）、人工智能与机器学习（Artificial Intelligence and Machine Learning）、连通性与无边界网络（Connectivity and Ubiquity）</strong>。</p><ul><li><p><strong>去中心化</strong>：这是Web 3.0的核心原则。在Web 2.0中，计算机以唯一网址的形式使用HTTP来查找信息，这些信息存储在固定位置，通常存储在单个服务器上。使用Web 3.0，由于信息将根据其内容找到，因此可以同时存储在多个位置，因此可以分散。这将打破目前由Meta和Google等互联网巨头拥有的大量数据库，并将更大的控制权交给用户。在Web 3.0中，由不同且功能日益强大的计算资源（包括手机，台式机，电器，车辆和传感器）生成的数据将由用户通过分散的数据网络进行销售，确保用户保留所有权和<strong>控制权</strong>。</p></li><li><p><strong>无信任和无许可</strong>：除了去中心化和基于开源软件之外，Web 3.0还将是无信任的（即，网络将允许参与者直接交互而无需通过受信任的中介机构）和无许可（这意味着任何人都可以在没有管理机构授权的情况下参与）。因此，Web 3.0应用程序将在区块链或分散的点对点网络上运行，或者它们的组合，这些分散的应用程序被称为dApps。</p></li><li><p><strong>人工智能和机器学习</strong>：在Web 3.0中，计算机将能够通过基于语义Web概念和自然语言处理的技术来理解与人类类似的信息。Web 3.0还将使用机器学习，这是人工智能（AI）的一个分支，它使用数据和算法来模仿人类的学习方式，逐渐提高其准确性。这些功能将使计算机能够在药物开发和新材料等许多领域产生更快，更相关的结果，而不仅仅是构成当前努力大部分的有针对性的广告。</p></li><li><p><strong>连接性和无处不在</strong>：随着Web 3.0的出现，信息和内容变得更加互联和无处不在，可以通过多个应用程序访问，并且越来越多的日常设备连接到Web，其中一个例子就是物联网。资料使用的实际层面上，预期未来因为Web 3.0 出现而有重大改变。纽约大学未来网路教授Mat Dryhurst表示，过去因为每个社群、网路平台政策的不同，形成资料的“walled garden”（高墙花园），令用户虽然拥有自身数据资料，却无法完全随心所欲转移、掌握和运用。当未来资料可以放在区块链上，用户就可真正拥有，并带同这些个人资料到任何网站。</p></li></ul><h3 id="主要特点"><a class="markdownIt-Anchor" href="#主要特点"></a> 主要特点</h3><ul><li><strong>开放性</strong>：用户在某个互联网应用“领域”中的准入充分自由、门槛低。用户行为不受第三方限制、互联网应用打破原有的所谓生态内、生态间的界限，应用之间具有高度的组合性和复合性;合成资产、NFT等组合下，甚至可以在非许可、无交割的前提下将传统世界财富融合进入Web 3.0。Web 3.0内部基于不同基础设施的应用之间可以被“跨链”协议解决互联互通。</li><li><strong>隐私</strong>：数据所有权归用户所有，价值转移不需要第三方授权。</li><li><strong>共建</strong>：用户在Web2.0互联网应用中的内容创造是在受平台审核限制、跨平台限制等多方面受限的，尤其在社区治理方面，限制更多，所以就限制了用户在创作者经济共享方面的价值捕获。Web 3.0有望打破限制，区块链的代币激励机制有效反馈内容经济的价值给创作者。共建、共享的另一个方面是共治，即DAO。</li></ul><h3 id="进化简史"><a class="markdownIt-Anchor" href="#进化简史"></a> 进化简史</h3><p>在以区块链为代表的分布式技术推动下，从去中心化点对点账本实验到去中心化智能合约平台，催生了无数的新型应用(Dapp)，慢慢 DeFi 形成了数字世界里的“金融服务”， 而 NFT 加速了资产上链。我们看到，传统世界(线上和线下)之外，用户越来越接近一个相融相生的数字世界。至此，人们呼唤一个全新的网络世界——元宇宙，即可信地承载个人的社交身份和资产，社区将拥有更强大的主导权。</p><p><img src="https://static.v2grad.com/img/202204140632999.png" alt="Web 3.0 的进化简史" /></p><h2 id="范式迭代"><a class="markdownIt-Anchor" href="#范式迭代"></a> 范式迭代</h2><p><img src="https://static.v2grad.com/img/202204102208729.png" alt="the evoluation of the web" /></p><p>在谈论什么是Web 3.0 之前，我们需要简单回溯一下Web 1.0和Web 2.0的概念和内涵，才能更好地理解Web 3.0 为什么会诞生以及它所想要解决的问题。</p><h3 id="web-10只读互联网"><a class="markdownIt-Anchor" href="#web-10只读互联网"></a> Web 1.0：只读互联网</h3><blockquote><p>平台创造、平台所有、平台控制、平台受益</p></blockquote><p>Web这个概念最早诞生于1989年欧洲粒子物理研究所的一项研究中。当时，为了方便全球的研究人员能在不同计算机之间共享和更新信息，英国科学家Tim Berners-Lee提交了一项关于“<strong>在全球范围内建立超媒体信息检索系统</strong>”的提案，并将这个系统命名为 <strong>World Wide Web（万维网）</strong>。其设想是，<strong>互联网上的资源可以在一个网页里比较直观的表示出来，而这些资源可以在网页上相互链接。</strong></p><p>1990年10月，Berners-Lee已经编写了三种基本技术，这些技术成为网络的基础，包括第一个网页编辑器/浏览器（WorldWideWeb.app）：</p><ul><li><strong>HTML</strong>：超文本标记语言，Web 的标记或格式化语言</li><li><strong>URI 或 URL</strong>：统一资源标识符或定位符，用于标识 Web 上每个资源的唯一地址</li><li><strong>HTTP</strong>：超文本传输协议，允许从整个 web 检索链接的资源</li></ul><p>从万维网的发明背景和定义中我们可以看出，<strong>当时的Web是为了信息共享和交换而设计的，万维网就像是一个信息展示的平台，旨在成为人们了解更广阔世界的窗口。</strong></p><p>从1991年到2004年间，在万维网上流转的信息逐渐从文字变成了图片再变成了视频，信息门户时代汹涌而至。网景、雅虎、新浪等一大批浏览器和信息门户类网站在全球如雨后春笋般涌现。虽然这些网站彻底改变了人们了解信息的方式，<strong>但这些信息是静态的、只读的，用户只能是观众，并无法参与其中</strong>。</p><p>于是很快，一场互联网交互时代的变革到来。</p><h3 id="web-20可读写互联网"><a class="markdownIt-Anchor" href="#web-20可读写互联网"></a> Web 2.0：可读写互联网</h3><blockquote><p>用户创造、平台所有、平台控制、平台分配</p></blockquote><p><img src="https://static.v2grad.com/img/202204160723706.png" alt="Web1.0-&gt;Web2.0" /></p><p>Web 2.0最早由信息架构咨询师Darcy DiNucci在1999年撰写的文章《Fragmented Future》中首次创造，在这篇文章中她提出：“<strong>我们现在所知道的 Web 基本上是以静态形式被加载到浏览器窗口中，但这只是未来 Web 的雏形。未来的网络不再只是满屏的文本，而是一种会产生实时交互的传输机制。</strong>”</p><p>这个概念从提出到被大众广泛知晓经过了近5年，直到2004年末，O’Reilly Media Web 2.0会议在旧金山召开，O’Reilly媒体的创始人Tim O’Reilly才正式将Web 2.0带进了大众视线，并进一步阐释和丰富了Web 2的定义和内涵。<strong>他表示，Web 2.0是一种新的互联网方式，其模式将更以用户为中心，将允许用户作为内容的创建者，并通过社交媒体进行交互和协作。</strong></p><p>如今，我们所熟知的大部分科技公司都是Web 2.0时代的产物。包括以谷歌为代表的搜索引擎，以Facebook、Twitter为代表的社交网站，以YouTube、Tiktok为代表的视频社区，以维基百科为代表的知识社区等等。在用户创造内容的模式下，互联网规模开始急速膨胀，网络开始成为了人们生活必不可少的部分。而时至今日，我们其实还仍然处于Web 2.0的时代中。</p><h3 id="web-30价值互联网"><a class="markdownIt-Anchor" href="#web-30价值互联网"></a> Web 3.0：价值互联网</h3><blockquote><p>用户创造、用户所有、用户控制、协议分配</p></blockquote><p><img src="https://static.v2grad.com/img/202204160724961.png" alt="Web2.0-&gt;Web3.0" /></p><p>在Web 2.0时代，互联网的发展已经偏离了最初的设计轨道。随着用户从信息的接收者变成了参与者，用户在网络上的数字行为也被一一记录了下来，并且以数据形式由各个公司掌握。比如谷歌记录你的搜索痕迹，Facebook、Twitter记录你的人际关系和互动，亚马逊记录你的购买记录等等。这些<strong>科技型巨头通过大量的数据来获取利益，算法掌控了你的世界</strong>。</p><p>而最重要的是，你的这些<strong>个人数据并不属于你自己</strong>，而是以各个公司为中心成为了它们的盈利工具。举个例子，如果Facebook有一天倒闭了，关停了你的社交账号，那你过去发的所有动态、建立的所有关系也会随着Facebook的消失而消失，你的信息本质上并不属于你。</p><p>2014年，以太坊联合创始人Gavin Wood在自己的一篇博客《Insights into a Modern World》中首次明确提出了Web 3.0这个概念，提出了一种全新的互联网运行模式：<strong>信息将由用户自己发布、保管、不可追溯且永远不会泄露，用户的任何行为将不需要任何中间机构来帮助传递。</strong></p><p>Web 3.0的体验可能和Web 2.0区别不算太大，而差异在于使用者或创作者能对自己贡献的内容保有所有权，还能获得一定程度的回报。私隐方面，用户能清楚知道这些数据的用途，并且具有决策权。</p><p><img src="https://static.v2grad.com/img/202204102216104.png" alt="Web1.0-Web 3.0的变迁" /></p><h2 id="技术栈"><a class="markdownIt-Anchor" href="#技术栈"></a> 技术栈</h2><p>区块链脱胎于比特币系统，从本质上讲，它是一个共享数据库，存储于其中的数据或信息，具有“不可伪造”、“公开透明”、“集体维护”等特征，基于这些特征，区块链奠定了坚实的“信任”基础，创造了可靠的“合作”机制。</p><p>Web3的基础设施基于区块链技术，Web 3.0 Foundation将Web3的技术栈定义为由L0~L4组成的5层架构系统，如下图所示：</p><p><img src="https://static.v2grad.com/img/202204141351015.png" alt="Web3技术栈" /></p><h3 id="layer-0"><a class="markdownIt-Anchor" href="#layer-0"></a> Layer 0</h3><blockquote><p>基础设施和网络层，提供了数据分发和互动能力</p></blockquote><ul><li><strong>P2P internet overlay protocols</strong>：点对点互联网覆盖协议，一个允许节点以分散的方式进行通信的网络套件。</li><li><strong>Platform-neutral computation description language</strong>：平台中立的计算描述语言，一种在不同物理平台（架构、操作系统等）上执行相同程序的方式。例子包括EVM（以太坊）、UTXOs（比特币）和Wasm。</li></ul><h3 id="layer-1"><a class="markdownIt-Anchor" href="#layer-1"></a> Layer 1</h3><blockquote><p>协议层，提供了分发和互动数据的能力</p></blockquote><ul><li><strong>Data distribution protocols</strong>：数据分配协议，描述数据如何在去中心化系统的各个节点之间分配和交流的协议。例子包括IPFS、Swarm和BigchainDB。</li><li><strong>Zero/Low-trust interaction platforms</strong>：零/低信任互动平台，比如Polkadot，是一种异构多链技术。它由许多具有潜在不同特征的平行链组成，可以更容易地实现匿名或形式验证。交易可以分散在链中，允许在同一时间段内处理更多交易。Polkadot确保这些区块链中的每一个都保持安全，并且它们之间的任何交易都得到忠实执行。可以创建称为桥的专用平行链来连接独立的链。</li><li><strong>Zero/Low-trust interaction protocols</strong>：零/低信任度互动协议，描述不同节点如何相互作用并信任来自每个节点的计算和信息的协议。大多数加密货币，如比特币和ZCash，符合零/低信任交互协议的定义，它们描述了节点参与协议所需遵循的规则。</li><li><strong>Transient data messaging</strong>：瞬时数据公共/子信息传递，描述不打算永久存储的数据（如状态更新）如何被传达以及如何让节点意识到其存在的协议。例子包括Whisper和Matrix。</li></ul><h3 id="layer-2"><a class="markdownIt-Anchor" href="#layer-2"></a> Layer 2</h3><blockquote><p>中间件层，增强了L1层能力:进行提升扩展性、加密消息传递、分布式计算等功能。</p></blockquote><ul><li><p><strong>State channels</strong>：状态通道，区块链通过让节点在链外相互通信，通过在主链上 &quot;打开 &quot;和 &quot;关闭 &quot;通道，只写初始和最终结果，而不是在链上记录每个状态转换，从而提高可扩展性的一种方式。例子包括比特币的Lightning Network 和以太坊的Raiden Network。</p></li><li><p><strong>Plasma protocols</strong>：Plasma协议，Plasma是通过创建区块链的 &quot;树 &quot;来提高可扩展性的另一种方式，主链是树的根，而 &quot;子 &quot;区块链尽可能少地与更高级别的链互动。例子包括Loom的PlasmaChain和OmigeGO Plasma。</p></li><li><p><strong>Encrypted storage</strong>：加密存储，使用密码学对数据进行数学加密和解密，包括静态（即存储在特定的计算机上）和动态（即从一台计算机传输到另一台）。例如：静态指的是存储加密，动态指得是传输加密（HTTPS就是一种传输加密）</p></li><li><p><strong>Heavy computation</strong>：重型计算，可以理解为如果需要进行大量的计算，例如在数组中推送大量的对象 提供一种方法，允许计算分散在许多计算机中，并证明计算是正确进行的。这方面的例子包括以太坊的Golem和TrueBit。</p></li><li><p><strong>Distributed secret management</strong>：分布式秘密管理，允许信息只被授权方访问，包括复杂的场景，如 &quot;解密此信息需要所有六个签名者使用他们的密钥 &quot;或 &quot;7个签名者中的任何5个必须同意&quot;等等。</p></li><li><p><strong>Oracles</strong>: 预言机，将链外数据（如天气结果或股票价格）注入区块链的一种方式，一般供智能合约使用。</p></li></ul><h3 id="layer-3"><a class="markdownIt-Anchor" href="#layer-3"></a> Layer 3</h3><blockquote><p>中间件层，人类可读语言和库的层</p></blockquote><p>在这一层，开发人员和程序员们可以适当抽象，并进行程序开发。这一层包括可扩展协议的API和语言：</p><ul><li>各种语言可以用来开发应用程序，如Solidity和Vyper（Ethereum），Plutus（Cardano），和Rust（Substrate）。此外，还有各种框架。</li><li>使编程与区块链互动的应用更加容易，如ethers.js、web3.js和oo7.js。</li></ul><h3 id="layer-4"><a class="markdownIt-Anchor" href="#layer-4"></a> Layer 4</h3><blockquote><p>技术栈顶层，DApps</p></blockquote><p>参与者主要是普通用户（如同今天普通用户在浏览器前端和网页互动一样）用户们在这一层可以和单个或多个区块链（应用等）互动。例如状态、元掩码、MyCrypto、奇偶校验</p><p>协议可扩展的用户界面（“像浏览器一样”），用户用来直接与区块链互动的程序，而不需要知道如何让编程和实现细节：案例有Status、MetaMask、Parity、EtherWallet或MyCrypto。</p><p><img src="https://static.v2grad.com/img/202204150914276.png" alt="Dapp架构图" /></p><h3 id="代表项目"><a class="markdownIt-Anchor" href="#代表项目"></a> 代表项目</h3><p><img src="https://static.v2grad.com/img/202204150641778.png" alt="Web3技术栈代表项目" /></p><p><strong>核心栈（Core Stack）</strong><br />核心栈可以说是整个区块链生态运转必不可少的技术支撑，它们一类属于区块链的底层技术（基础设施），另一类是去中心化应用开发不可或缺的技术组件。</p><p>这里我们只挑出了最具影响力、最必不可少的技术组件，对它们的发展状况、去中心化的程度进行简要分析。</p><p>我们所认为的核心栈主要组件有：<strong>去中心化应用浏览器（Dapp Browser）、应用托管（Application Hosting）、查询图层（Query Layer）、状态转换机（State Transition Machine）、共识（Consensus）、对等网络层（P2P Layer）。</strong></p><ul><li><strong>去中心化应用浏览器（Dapp Browser）</strong>：代表项目：Mist、MetaMask、Coinbase Wallet、Trust Wallet、imToken</li><li><strong>应用托管（Application Hosting）</strong>：代表项目：IPFS, Swarm</li><li><strong>查询层（Query Layer）</strong>：代表项目：Chainlink，Band Protocol</li><li><strong>状态转换机（State Transition ）</strong>：以太坊虚拟机（EVM） - 以太坊1.0，Ethermint，Hashgraph，WANchain等 网络装配虚拟机 (WASM) – Dfinity, EOS, Polkadot, 以太坊 2.0 Direct LLVM exposure – Cardano, Solana 自定义状态转换机（Custom state transition machines）：Kadena，Tezos，Rchain，Coda</li><li><strong>共识层（Consensus Layer）</strong>：代表项目：POW, POS, DPOS</li><li><strong>对等网络层（P2P Layer）</strong>：代表项目：Libp2p, Devp2p</li></ul><p><strong>潜在的核心栈——扩展核心栈（Extended Core Stack）</strong><br />这些技术组件虽然不是底层链的一部分，也不是对DApp的开发必不可少的组件，但它们将很有可能成为未来开发堆栈的核心组件，这意味它们是非常值得投资机构关注的领域。</p><ul><li><strong>侧链（Sidechains）</strong>：在BTC网络中最值得注意的用例是Drivechains 和Liquid。而在以太坊体系中，最重要的是 Plasma 框架内的SKALE和近期以太坊基金会推出的Roll up证明，以及Cosmos Ethermint。</li><li><strong>支付通道和状态通道网络（Payment Channel and State Channel Network）</strong>：Blockstream 在2015年推出闪电网络，在以太坊生态系统中，则有Raiden、Loom和Celer。</li><li><strong>跨账本协议（Interledger Protocol ILP）</strong>：Ripple实验室使用跨账本协议跨界连接其产品中的银行系统。而Kava则使用跨账本协议技术在Cosmos基础上构建支持 XRP、BNB、ATOM 等资产的 DeFi 平台。</li><li><strong>不可变的结构化数据库（Immutable Structured Databases）</strong>：BigchainDB、OrbitDB 和 Bluezelle 等许多团队正在构建不可变的结构化数据库作为无需许可的独立链（Permissionless, Free Standing Chains）。鉴于使用结构化数据库可以提升性能，开发人员也许会选择原生地使用这些系统，比如像SKALE这样的团队也许会将这些开源系统作为Plasma链。</li><li><strong>零知识证明（Zero-knowledge Proof）</strong>：零知识证明最有代表性的两个技术为ZK-SNARK以及ZK-STARK。其代表项目分别为Coda和Starkware。</li></ul><h2 id="生态全景"><a class="markdownIt-Anchor" href="#生态全景"></a> 生态全景</h2><h3 id="web3应用"><a class="markdownIt-Anchor" href="#web3应用"></a> Web3应用</h3><p><strong>Web3应用是什么？</strong></p><ul><li>Web1是<strong>开放协议</strong>，服务建立在开放协议之上（如TCP、IP、SMTP、HTTP：就理解为网络通信协议）。</li><li>Web2是各家企业在开放协议之上建立了第二层<strong>专有的、封闭的协议</strong>，企业以营利为目标的科技公司，开发的软件和提供的服务，迅速超越了第一代开放协议。</li><li>Web3是社区使用和维护Web3、发展Web3的基础设施，可以获得激励和奖励。</li></ul><p><strong>Web3应用为何重要？</strong><br />Web3的去中心化网络，为割裂的数字时代现状提供了替代方案。</p><ul><li>割裂的数字时代现状：<strong>中心化的网络企业拥有单方面的权力</strong>，网络使用权、收入分配、功能支持、用户数据安全等。创业企业、创作者很难发展自己的业务，因为中心平台可能会随时夺走用户和利润。</li><li>传统意义上的去中心化网络挑战在于，公共物品的提供，没有中心化经济体去承担并且能从中获利，很难由用户自发持续维护，但是Crypto可以通过去中心化的协调，把权力和激励下放到社区。</li><li>去中心化系统可以避免单点故障，中和中心化平台所施加的单边控制。</li></ul><h3 id="去中心化自治组织dao"><a class="markdownIt-Anchor" href="#去中心化自治组织dao"></a> 去中心化自治组织DAO</h3><p><img src="https://static.v2grad.com/img/202204160645989.png" alt="DAO" /></p><p><strong>DAO是什么？</strong><br />在线成员共有的社区，由成员共识来管理（非集中领导）</p><ul><li><strong>去中心化</strong>：规则不能被单个人物或中心化的一方所改变；</li><li><strong>自治</strong>：投票的统计和决定执行，都遵循写入智能合约的逻辑来计算投票和执行决定，不需要人为干预；</li><li><strong>组织特性</strong>：DAO的组织可以协调分布在各地的分布式社区利益相关者间的活动；</li></ul><p><strong>DAO代表了 &quot;链上治理&quot;的运用</strong>。例如，在传统的公司治理中，公司会规定某些政策的章程，如何选举董事会。DAO可以将类似的政策和章程用代码写成智能合约，将这一概念继续延伸到数字世界。<strong>智能合约</strong>是一个稳定的计算机程序，在区块链网络上运行，它就像法律上的合同一样，智能合同是一种承诺，只是它们被写入计算机代码，可以自动和自主执行。</p><p><img src="https://static.v2grad.com/img/202204180934194.png" alt="主要的DAO类别" /></p><p><strong>DAO为何重要？</strong><br />DAO是一种新兴的组织治理模式：<strong>它是用于围绕透明度和包容性建立的新型组织。这些原则可以适用于各式组织，包括非营利组织、集体、合作社和投资基金等。</strong></p><p>治理结构决定一个组织如何做出符合参与者利益的决策，当前组织形式的挑战是：决策不透明+普通参与者参与治理门槛高。</p><h3 id="去中心化金融defi"><a class="markdownIt-Anchor" href="#去中心化金融defi"></a> 去中心化金融DeFi</h3><p><img src="https://static.v2grad.com/img/202204160650387.png" alt="去中心化金融DeFi" /><br /><strong>DeFi是什么？</strong><br />金融领域（储蓄、贷款和外汇兑换）的去中心化应用</p><ul><li>去中心化应用（dApps）是指代码编写建立在相关领域的智能合约，只要托管相关协议的区块链存在，dApp就会存在，无法被恶意改变or操纵。dApps是开放的，任何计算机都可以参与</li><li>区块链支付实现了点对点数字交易，之前数字支付必须依赖集中式记录管理方。</li><li>加密货币就是系统中的计价单位、交换媒介、价值储藏手段，无中心化第三方，也能以数字方式进行实际价值转移。</li></ul><p><img src="https://static.v2grad.com/img/202204180934254.png" alt="DeFi和传统金融差异" /></p><p><strong>DeFi为什么重要？</strong><br />加密货币<strong>低成本、实时、无边界、点对点价值转移，不受主流金融机构营业时间的限制。</strong> 准入门槛低，为世界金融服务不足的地区，提供了机会。</p><ul><li>全球20亿无银行账户的人可以获取金融服务，跨国劳工可以低成本便捷将收入寄回祖国家人。</li><li>为经历恶性通货膨胀的国家提供更安全的价值储存手段。</li><li>当前的移动支付改变了消费金融的前端，DeFi改变了后端：铺设了新管道、轨迹，参与金融系统成本变低、变简单</li><li>给消费者以权力，控制自己使用的消费金融产品</li><li>拥抱互联网核心价值：开放给任何人、承诺开源、第三方开发者无需许可即可改编、费用低、加密技术的安全隐私保护、透明管理</li></ul><h3 id="稳定币和中央银行数字货币cbdcs"><a class="markdownIt-Anchor" href="#稳定币和中央银行数字货币cbdcs"></a> 稳定币和中央银行数字货币（CBDCs）</h3><p><img src="https://static.v2grad.com/img/202204160652005.png" alt="稳定币和中央银行数字货币" /><br /><strong>稳定币&amp;CBDCs是什么？</strong><br />稳定币是私人发行的加密货币，一段时间内保持稳定价值；中央银行数字货币是由政府发行的数字货币，象征国家主权和义务。</p><p><strong>稳定币&amp;CBDCs为什么重要？</strong><br />稳定币有加密货币的优势，且没有波动性。比特币可能有巨大价值波动，但是稳定币设计保持恒定价格，有助于其作为有效的交易媒介。</p><ul><li>作为低波动性资产有助于实现链上交易：现代化全球支付系统、更广泛金融服务</li><li>CBDCs有稳定币优点，两者共存，竞争创新</li></ul><h3 id="隐私和数字基础设施"><a class="markdownIt-Anchor" href="#隐私和数字基础设施"></a> 隐私和数字基础设施</h3><p><img src="https://static.v2grad.com/img/202204160656539.png" alt="Nym隐私保护流程" /><br /><strong>隐私和数字基础设施是什么？</strong><br />区块链网络局限性是设计透明，现在可以从数学上证明信息有效性而无需提供信息本身，这样用户证明自己知道自己的密码，但是网站不用存储，兼顾隐私和可扩展性。</p><p><strong>隐私和数字基础设施为什么重要？</strong></p><ul><li>可以保护用户的个人数据，而且，它从根本上扩展了应用程序的设计空间。隐私基础设施的布局将促成一系列更具保护功能的应用程序。</li><li>有助于用户打消隐私顾虑，向特定主体披露信息但是防止信息被公开。</li></ul><h3 id="创作者经济creator-economy"><a class="markdownIt-Anchor" href="#创作者经济creator-economy"></a> 创作者经济（Creator Economy）</h3><p><strong>创作者经济是什么？</strong><br />创作者社区直接与支持者联系，没有中介/中间商，创作者获得独立收入来源。<strong>NFT是不可伪造的数字资产，由独特性存在价值</strong>，可以和数字作品一一联系。</p><p><strong>创造者经济为什么重要？</strong></p><ul><li>NFT为创作者提供新的盈利方式，绕过中介、中间商；粉丝可以直接参与创作者事业，同时通过持有NFT获得份额</li><li>NFT可以利用区块链技术来跟踪，创作者可以从二次销售中获益。</li></ul><h3 id="链游gamefi"><a class="markdownIt-Anchor" href="#链游gamefi"></a> 链游GameFi</h3><p><img src="https://static.v2grad.com/img/202204160657880.png" alt="链游（Gamefi）" /><br /><strong>链游是什么？</strong><br />基于区块链的游戏，是指构建在区块链技术上的游戏链游与堡垒之夜、Roblox或Minecraft等流行游戏的一个关键区别是：<strong>游戏里的东西可以全部交易成通货然后去兑换其他游戏里的资源</strong>。</p><p><img src="https://static.v2grad.com/img/202204180935976.png" alt="去中心化治理将游戏规则交予玩家" /></p><p><strong>链游为什么重要？</strong></p><ul><li>游戏中的物品，就是玩家拥有的NFT，可以和现实的金钱交易，在游戏间传递。</li><li>促进了边玩边赚，通过axie infinity这样的游戏，人们的可以赚取真实世界的货币。</li></ul><h2 id="展望"><a class="markdownIt-Anchor" href="#展望"></a> 展望</h2><p><img src="https://static.v2grad.com/img/202204162106519.png" alt="Web3展望" /></p><p>Web3这个词实际上指代了基于去中心化技术的新型互联网体验。而Web3已经开始颠覆我们在投资、交易、游戏和艺术等各个领域的交互方式。全球各地有越来越多的用户和机构已经开始意识到无须信任的交互和基于加密技术保障的协议是多么重要。虽然Web3仍处于发展初期，但它有潜力将互联网恢复成当初设计者所希望的那样：完全透明、可靠且易于使用。</p><p><strong>目前所有的Web2.0的Apps都值得在Web 3.0中重做一遍，升级为DApps</strong><br /><img src="https://static.v2grad.com/img/202204160719974.png" alt="web2到Web3" /></p><p>Sergey在演讲中说道：“Web3在速度、效率和成本上将逐渐赶上Web 2.0系统，并且它还具有Web 2.0没有的优势，那就是信任最小化的加密保障。”</p><p>但是目前依然是萌芽期，我们还是要理性看待，<strong>起得最早是理想主义者，跑得最快的是骗子，胆子最大的是冒险家，害怕错过的是韭菜</strong>。</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><p><a href="https://www.investopedia.com/web-20-web-30-5208698">Web 2.0 and Web 3.0 / investopedia</a><br /><a href="https://mp.weixin.qq.com/s/dtAGRDWGpN9r1p2Pr1WZaA">怎么理解Web 3.0？ /  分布式实验室</a><br /><a href="https://Web3.foundation/about/">Web3 foundation / Dr. Gavin Wood</a><br /><a href="https://Web3-technology-stack.readthedocs.io/en/latest/">Welcome to the Web3 Technology Stack</a><br /><a href="https://mirror.xyz/0x5Eba828AB4999825D8416D7EAd9563b64FD90276/zjuD39dwYf2y7dEGTFcCDi_BuFRt1KUT0m5VUMzdI2o">拥抱Web 3.0：技术堆栈下的范式转变与投资展望 / IOSG VC</a><br /><a href="https://a16z.com/wp-content/uploads/2021/10/The-web3-Readlng-List.pdf">The Web3 Landscape / a16z</a><br /><a href="https://blog.chain.link/Web3-zh/">一文读懂Web3 / Chainlink</a><br /><a href="http://www.199it.com/archives/1420537.html">Web3.0概念下的场景生态简析/ 甲子光年</a></p>]]>
    </content>
    <id>https://v2grad.com/2022/04/16/web3/</id>
    <link href="https://v2grad.com/2022/04/16/web3/"/>
    <published>2022-04-16T02:00:00.000Z</published>
    <summary>Web 3.0代表互联网的下一个时代，目前并没有明确定义，我们将它描述为基于区块链技术的去中心化的互联网技术的合集，有新的技术、新的范式、新的组织形式以及对应的价值观世界观。</summary>
    <title>Web 3.0的范式、技术和生态</title>
    <updated>2022-04-15T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="技术洞察" scheme="https://v2grad.com/categories/technical-insight/"/>
    <category term="元宇宙" scheme="https://v2grad.com/tags/%E5%85%83%E5%AE%87%E5%AE%99/"/>
    <content>
      <![CDATA[<blockquote><p>一千个人心中，有一千个元宇宙。</p></blockquote><h2 id="什么是元宇宙"><a class="markdownIt-Anchor" href="#什么是元宇宙"></a> 什么是元宇宙</h2><p>元宇宙（Metaverse）出自1992年出版的科幻小说作家尼尔·斯蒂芬森（Neal Stephenson）的第三部著作《雪崩》（Snow Crash）。</p><p>斯蒂芬森创造了一个并非以往想象中的互联网，而是和社会紧密联系的三维数字空间——虚拟实境（Metaverse），与现实世界平行，在现实世界中地理位置彼此隔绝的人们可以通过各自的“化身”进行交流娱乐；</p><p>在这个虚拟现实中，人们表现为自己设计的“化身”，从事世俗的（谈话、调情）和非凡的（斗剑、雇佣军间谍活动）活动。像互联网一样，元宇宙是一种集体的、互动的努力，总是在进行，并且不受任何一个人的控制。就像在游戏中一样，人们居住并控制着在空间中移动的角色</p><p><img src="https://static.v2grad.com/img/202203260629357.png" alt="元宇宙" /></p><h3 id="定义"><a class="markdownIt-Anchor" href="#定义"></a> 定义</h3><p><strong>元宇宙(Metaverse)</strong> 是利用科技手段进行链接与创造，与现实世界映射与交互的虚拟世界，以及具备新型社会体系的数字生态空间。“Metaverse”这个词由meta和verse组成，meta表示超越，verse取自universe，合起来就是“超越宇宙”，被翻译成“元宇宙”。</p><p>关于元宇宙的概念，目前并没有一个明确的定义，可以参考一下专家对它的定义。</p><p>清华大学新闻学院<strong>沈阳教授</strong>这样定义元宇宙：</p><blockquote><p>“元宇宙是整合多种新技术而产生的新型虚实相融的互联网应用和社会形态，它基于扩展现实技术提供沉浸式体验，以及数字孪生技术生成现实世界的镜像，通过区块链技术搭建经济体系，将虚拟世界与现实世界在经济系统、社交系统、身份系统上密切融合，并且允许每个用户进行内容生产和编辑。”</p></blockquote><p>北京大学<strong>陈刚教授、董浩宇博士</strong>这样定义元宇宙：</p><blockquote><p>“元宇宙是利用科技手段进行链接与创造的，与现实世界映射与交互的虚拟世界，具备新型社会体系的数字生活空间。”</p></blockquote><h3 id="理解"><a class="markdownIt-Anchor" href="#理解"></a> 理解</h3><ul><li><strong>基础理解</strong>：元宇宙是<strong>下一代互联网</strong>：物联网+区块链+人工智能+高速移动互联网+AR/VR</li><li><strong>进阶理解</strong>：元宇宙是人类社会形态进步，是<strong>人类数字生存新形态</strong>，是物理生存的实时混合生存状态。国界、组织边界、公司边界在一些意义、一些功能上，会趋于消失，跨境跨界合作更普遍、高效、低成本。</li><li><strong>高阶理解</strong>：让地球的<strong>价值+信息</strong>高度自由流动，让没有信任和社交关系的人和物，低成本、远程、实时互联协作，是人类进化的新阶段～</li></ul><p>目前关于元宇宙的畅想有一些影视作品可以参考，我们可以观看一下影片，辅助我们理解元宇宙：<strong>《阿凡达》</strong> 帮助我们理解数字孪生的真实人格人生; <strong>《头号玩家》</strong> 帮助我们理解元宇宙现实经济、线上经济和价值的融合互通;<strong>《失控玩家》</strong> 帮助我们理解元宇宙纯AI人格; <strong>《黑客帝国》</strong> 帮助我们理解元宇宙人脑创造和计算能力被AI控制和利用的假想。</p><h3 id="关键特征"><a class="markdownIt-Anchor" href="#关键特征"></a> 关键特征</h3><p><strong>Roblox</strong> 提出了通向元宇宙的7个关键特征:<strong>Identity(身份)、Friends(朋友)、Immersiveness(沉浸感)、 Low Friction(低延迟)、Variety(多样性)、Anywhere(随地)、Economy(经济)、Civility(文明)。</strong></p><p><img src="https://static.v2grad.com/img/202203231606322.png" alt="元宇宙的关键特征" /></p><ul><li><strong>身份</strong>：拥有一个虚拟身份，无论与现实身份有没有相关性，可以自由创造，采用虚拟形象。</li><li><strong>朋友/社交</strong>：在元宇宙当中拥有朋友，可以社交，无论在现实中是否认识。</li><li><strong>沉浸感</strong>：能够沉浸在元宇宙的体验当中，忽略其他的一切。</li><li><strong>低延迟</strong>：元宇宙中的一切都是同步发生的，没有异步性或延迟性。</li><li><strong>多元化</strong>：元宇宙提供多种丰富内容，包括玩法、道具、美术素材等，具有超越现实世界的自由与多元。</li><li><strong>(随时)随地</strong>：可以使用任何设备登录元宇宙，随时随地沉浸其中。</li><li><strong>经济系统</strong>：与任何复杂的大型游戏一样，元宇宙应该有自己的经济系统。</li><li><strong>文明</strong>：元宇宙应该是一种虚拟的文明，具备虚拟世界的社会、法度、文明、虚拟“国家”等。</li></ul><blockquote><p>这里面最重要的是“<strong>经济体系</strong>”和“<strong>文明</strong>”这两个特征。</p></blockquote><h3 id="八大要素"><a class="markdownIt-Anchor" href="#八大要素"></a> 八大要素</h3><p><strong>扎克伯格</strong> 提出元宇宙的八大要素： <strong>1）身临其境感（Feeling of Presence）；2）虚拟形象（Avatar）；3）家庭空间（Home Space）；4）远距离传输（Teleporting）；5）互操作性（Interoperability）；6）隐私安全（Privacy and Safety）；7）虚拟物品（Virtual Goods）；8）自然界面（Natural interfaces）</strong><br /><img src="https://static.v2grad.com/img/202203260621731.png" alt="元宇宙的8大要素" /></p><h3 id="四大特性"><a class="markdownIt-Anchor" href="#四大特性"></a> 四大特性</h3><p><strong>社交第一性</strong><br />元宇宙作为人类社会形态发展新的阶段，基于硬件技术、内容生态的高度发达，开始追求超脱于物理世界层面，实现在虚拟空间之中寻求社交与场景的延展。</p><ul><li>元宇宙是人类社会形态发展新的阶段</li><li>每个个体都拥有独立的“数字化身”</li><li>社交将成为元宇宙的“刚需”</li></ul><p><strong>感官沉浸性</strong><br />沉浸感是元宇宙与现实世界融合的基础，用户在元宇宙的虚拟空间中将拥有“具身的临场感”，并借助硬件、交互技术的进步，在视觉、听觉、触觉、嗅觉等方面实现感官体验的拓展。</p><ul><li>沉浸式是元宇宙与现实融合的基础</li><li>虚拟空间需要拥有“具身的临场感”</li><li>人类认知边界即是元宇宙发展的边界</li></ul><p><strong>交互开放性</strong><br />元宇宙实现了虚拟空间与现实世界的叠加，因此，用户将同时拥有虚拟空间的超现实能力、以及与现实世界的作用力，在元宇宙交互过程中将能够同时作用于虚拟和现实两个空间之内。</p><ul><li>元宇宙将实现虚拟与现实世界的叠加</li><li>元宇宙将实现人类感知与交互的升维</li><li>元宇宙将实现人机共生的交互模式</li></ul><p><strong>能力可扩展性</strong><br />元宇宙在基础设施、标准及协议的不断迭代演进的支撑下，推进多平台融合，并呈现出工具化的发展方向。</p><ul><li>元宇宙将呈现出工具化的发展方向</li><li>元宇宙技术为内容创作提供了全新载体</li><li>每个用户可以元宇宙内实现世界编辑</li></ul><h3 id="四大支柱"><a class="markdownIt-Anchor" href="#四大支柱"></a> 四大支柱</h3><p>现阶段构建元宇宙的四大支柱：“<strong>BAND</strong>”<br /><img src="https://static.v2grad.com/img/202203231142877.png" alt="元宇宙的四大支柱BAND" /></p><ul><li><strong>BLOCKCHAIN</strong>：区块链技术提供了去中心化的清结算平台和价值传递机制，能够保障元宇宙的价值归属与流转，从而保障经济系统的稳定、高效，保障规则的透明和确定性执行。去中心化的虚拟资产能够跨平台、脱离内容本身进行流通，变得更加“真实”。</li><li><strong>GAME</strong>：电子游戏为元宇宙提供交互内容，是元宇宙发展的关键赛道,用户创作成为元宇宙游戏发展的趋势，为游戏提供了丰富的内容，玩家并非像传统游戏一样成为游戏主策划中的提线木偶，游戏UGC模式广受市场认可也改变着人们对虚拟资产的观念。</li><li><strong>NETWORK</strong>：网络与算力技术的升级保障了信息的传输与计算能力，5G、AIoT、算力为次时代应用创新打下了坚实基础。云计算是近年来发展最快的科技领域之一，伴随通信速率和云算力的持续升级，云端游戏已经成为现实。</li><li><strong>DISPLAY</strong>：超高清及AR/VR设备也实现了持续迭代升级，用户已经可以获得较好的沉浸式体验。</li></ul><h2 id="为什么需要元宇宙"><a class="markdownIt-Anchor" href="#为什么需要元宇宙"></a> 为什么需要元宇宙</h2><h3 id="互联网"><a class="markdownIt-Anchor" href="#互联网"></a> 互联网</h3><blockquote><p>互联网的发展遇到了天花板</p></blockquote><p>截至2021年6月，我国网民规模达10.11亿，互联网普及率达71.6%，然而中国移动互联网人数增长和人均上网时长增长，都在接近停滞。互联网企业迫切需要一个新的叙事逻辑，突破增长的极限。用户在线时长的增长动力，来自两个方面，一是VR等新设备创造更具沉浸感的线上体验，带来新的增量时长，二是更深度的挖掘时间分配，把人们传统意义上仍然花费在线下的时长，转化到线上。</p><p>互联网给我们带来了一个平面的、二维的虚拟世界，而元宇宙将会给我们带来一个三维的、立体的虚拟世界，其中的时间和空间都可以被重组。新技术带来了虚拟人物、数字化身等数字化、虚拟化的人类。现在全球有70亿人口，而这些虚拟的偶像和数字化身，数量可能达到700亿。</p><p><img src="https://static.v2grad.com/img/202203220959707.png" alt="PC互联网-&gt;移动互联网-&gt;元宇宙" /></p><h3 id="工业"><a class="markdownIt-Anchor" href="#工业"></a> 工业</h3><blockquote><p>工业领域的发展也需要突破瓶颈</p></blockquote><p>截至2021年9月，全国机动车保有量达3.90亿辆，全国机动车驾驶人4.76亿名。2021年中国人均汽车保有量，已经超过了我国在1980年的人均自行车拥有量。机器的生产效率不再制约生产力的提升，人的知识、经验、创新力和服务能力成为瓶颈。</p><p>技术即将打败人的经验，机器的知识终将超越人的知识，元宇宙可以作为一个宏大愿景，解决知识的产生、利用和规模化复制的瓶颈，实现工业企业价值创造的新突破。在虚拟的数字空间，各种技术不断积累动态数据，重构生产过程。数字孪生在物理世界与数字环境之间建构起关系，对生产过程进行回溯和预测。元宇宙的实现重点在于仿真和自主控制。</p><h3 id="金融"><a class="markdownIt-Anchor" href="#金融"></a> 金融</h3><blockquote><p>金融领域需要一次新的金融浪潮</p></blockquote><ul><li>第一次金融浪潮，形成企业债券市场。瓦特虽然改良了蒸汽机，但是普及并没那么容易。英国依靠中央银行和商业银行体系，最早推出了企业债券，为蒸汽机的发展提供了大规模、可持续、低成本的资金。</li><li>第二次金融浪潮，形成了证券交易所。爱迪生发明电灯，福特创造了T型车，洛克菲勒创办标准石油公司，背后都离不开纽约证券交易所，用股权融资代替债券融资，投资银行完成了对实业的布局。</li><li>第三次金融浪潮，风险投资模式兴起。风险投资体系在支撑技术创新和产业升级方面，起到了突出的作用，助推了信息时代的崛起。</li></ul><p>随着金融与实体产业的关系越来越难以分开，无数个普通人的经济金融活动，推动了新一轮金融浪潮的涌动。</p><p>比如用户创作的UGC内容，为互联网提供了价值；用户愿意用自家的服务器为邻居提供存储空间，也对互联网提供了价值。用户做了贡献，创造了价值，收益应该属于用户。用户有什么办法来确认这个收益呢？这时就离不开区块链。</p><p>通过过去12年的实践，区块链已经为元宇宙建立了一个非常完整的运行良好的去中心化的金融市场体系，元宇宙正是建立在这样一个金融市场体系上。</p><h2 id="关键技术"><a class="markdownIt-Anchor" href="#关键技术"></a> 关键技术</h2><p><img src="https://static.v2grad.com/img/202203260757305.png" alt="元宇宙六大支撑技术BIGANT" /></p><p>我们把这六大技术支柱的英文组合成一个比较有意思的缩写<strong>BIGANT</strong>，趣称为“大蚂蚁”。</p><ul><li><strong>区块链技术（Blockchain）</strong> 是建立信任、达成共识的重要技术，也是构建元宇宙虚拟资产体系的基础。</li><li><strong>交互技术（Interactivity）</strong> 是为元宇宙用户提供沉浸式虚拟现实体验的阶梯。</li><li><strong>游戏技术（Game）</strong> 是元宇宙初期形态的最成熟的呈现方式，同时也是元宇宙初期最重要的变现途径。</li><li><strong>人工智能技术（AI）</strong> 是元宇宙中生产力与自主运行最重要的技术支撑。</li><li><strong>网络与运算技术（Network）</strong> 是元宇宙在物理世界中的承载者，也是六大关键技术中，与现实世界关联最为紧密的技术。</li><li><strong>物联网技术（IoT）</strong> 是元宇宙与现实空间融合的媒介，为虚拟共生提供保障，意识元宇宙走向产业化的桥梁。</li></ul><h3 id="区块链技术b"><a class="markdownIt-Anchor" href="#区块链技术b"></a> 区块链技术(B)</h3><p>区块链（Blockchain）是去中心化、去信任化、不可篡改和抵赖的分布式账本技术。<strong>NFT(Non-Fungible Token,非同质化货币)</strong> 作为目前区块链相关技术中较为成熟的技术，在区块链框架下能够作为代表数字资产的唯一加密货币令牌，将是支撑元宇宙<strong>经济体系</strong>最重要的基础，元宇宙一定是<strong>去中心化</strong>的，用户的虚拟资产必须能跨越各个子元宇宙进行流转和交易，才能形成庞大的经济体系。<br /><img src="https://static.v2grad.com/img/202203262158528.png" alt="区块链技术" /></p><h3 id="交互技术i"><a class="markdownIt-Anchor" href="#交互技术i"></a> 交互技术(I)</h3><p>交互技术(Interactivity)是利用传感器、音视频、图形界面等方式，大幅强化人、机感知能力的技术，亦是为元宇宙用户提供沉淀式虚拟现实体验的阶梯。</p><p>通过<strong>AR、VR</strong>等交互技术提升游戏的沉浸感。人体交互技术是制约当前元宇宙沉浸感的最大瓶颈所在，交互技术分为输出技术和输入技术。输出技术包括头戴式显示器、触觉、痛觉、嗅觉甚至直接神经信息传输等各种电信号转换于人体感官的技术；输入技术包括微型摄像头、位置传感器、力量传感器、速度传感器等。复合的交互技术还包括各类脑机接口,这也是交互技术的终极发展方向。</p><p>VR/AR产业近几年逐渐克服硬件和内容生态的核心短板，产业将打破“爆款内容匮乏，硬件销售萎靡“的恶性循环，进入复苏期。</p><p><img src="https://static.v2grad.com/img/202203262200458.png" alt="VR/AR产业跨越低谷迎来产业复苏" /></p><h3 id="电子游戏技术g"><a class="markdownIt-Anchor" href="#电子游戏技术g"></a> 电子游戏技术(G)</h3><p>游戏(Game)是依托于电子设备平台而运行的交互形态，是元宇宙初期形态的最成熟的呈现方式。游戏是元宇宙初期最重要的内容创作平台、社交流量入口，亦是元宇宙3D场景交互的原点，同时也是元宇宙初期的重要变现手段。</p><p>电子游戏技术既包括<strong>游戏引擎</strong>相关的3D建模和实时渲染,也包括数字孪生相关的<strong>3D引擎和仿真技术</strong>，前者是虚拟世界大开发解放大众生产力的关键性技术，后者是物理世界虚拟化数字化的关键性工具,同样需要大幅把门槛拉低到普通民众都能操作的程度,才能极大加速真实世界数字化的进程。</p><h3 id="人工智能技术a"><a class="markdownIt-Anchor" href="#人工智能技术a"></a> 人工智能技术(A)</h3><p>人工智能技术(AI)是通过算法模型、硬件算力、大数据训练共同构造的，以人类智能相似的方式作出反应的智能机器，是元宇宙中生产力与自主运行最重要的技术支撑，他将是未来承载元宇宙运行的底座。</p><p>人工智能可以<strong>降低内容创作门槛</strong>，提升游戏的可延展性。人工智能技术在元宇宙的各个层面、各种应用、各个场景下无处不在。包括区块链里的智能合约、交互里的 AI 识别、游戏里的代码人物、物品乃至情节的自动生成、智能网络里的 AI 能力、物联网里的数据 AI 等,还包括元宇宙里虚拟人物的语音语义识别与沟通、社交关系的AI推荐、各种 DAO 的 AI 运行、各种虚拟场景的 AI 建设、各种分析预测推理等。</p><h3 id="网络及运算技术n"><a class="markdownIt-Anchor" href="#网络及运算技术n"></a> 网络及运算技术(N)</h3><p>网络及运算技术(Network)为了满足元宇宙对网络<strong>高同步低延时</strong>的要求，从而用户可以获得<strong>实时、流畅的完美体验</strong>。根据独立第三方网络测试机构Open Signal的测试数据，4G LTE的端到端时延可达98毫秒，满足视频会议、线上课堂等场景的互动需求，但远不能满足元宇宙对于低时延的严苛要求。VR设备一大难题是传输时延造成的眩晕感，其指标为转动头部到转动画面的延迟，5G带宽与传输速率的提升能有效改善时延并降低眩晕感。</p><h3 id="物联网技术t"><a class="markdownIt-Anchor" href="#物联网技术t"></a> 物联网技术(T)</h3><p>物联网技术(Internet of Things)既承担了物理世界数字化的前端<strong>采集</strong>与处理职能,同时也承担了元宇宙虚实共生的虚拟世界去<strong>渗透</strong>乃至管理物理世界的职能。只有真正实现了万物互联,元宇宙实现虚实共生才真正有了可能!物联网技术的发展,为数字孪生后的虚拟世界提供了实时精准持续的鲜活数据供给,使元宇宙虚拟世界里的人们足不出网就可以明察物理世界的秋毫。</p><p>也有更细化的版本：We aimed to begin<br /><img src="https://static.v2grad.com/img/202203251751787.png" alt="元宇宙技术We aimed to begin" /></p><h2 id="实现路径"><a class="markdownIt-Anchor" href="#实现路径"></a> 实现路径</h2><p>元宇宙是一个循序渐进的过程</p><h3 id="阶段一arvr应用扩展"><a class="markdownIt-Anchor" href="#阶段一arvr应用扩展"></a> 阶段一：AR/VR应用扩展</h3><p>随着硬件的更新和底层技术的迭代，一些简单的应用场景会开始出现，比如<strong>游戏、建模、网上购物</strong>等，在这段时间里，元宇宙的概念仅仅是<strong>提升一些现有服务的体验</strong>，它只会<strong>是我们生活中的一小部分</strong>而已。</p><h3 id="阶段二提升社交和娱乐"><a class="markdownIt-Anchor" href="#阶段二提升社交和娱乐"></a> 阶段二：提升社交和娱乐</h3><p>随着技术的发展，越来越多的服务可以应用到元宇宙这个概念。</p><p>这时，它主要会<strong>给社交和娱乐这两大服务提供更好的体验</strong>，比如，你可以通过虚拟影像的方式跟远在异国他乡的亲人聊天，虚拟影像会投影对方的表情，肢体语言，就跟坐在你对面一摸一样。另外<strong>沉浸式娱乐</strong>将会成为主流，除了我们能够想象到3D场景游戏外，还比如，看球赛时，你再也不用对着一个大屏幕了，看你戴上VR头盔时，就可以实时看到NBA球星在你面前投篮，就像坐在场地的第一排看球一样。</p><h3 id="阶段三虚拟社会自成经济体"><a class="markdownIt-Anchor" href="#阶段三虚拟社会自成经济体"></a> 阶段三：虚拟社会，自成经济体</h3><p>当元宇宙技术趋于成熟，使用的人和参与的企业都越来越多后，元宇宙就很有可能进化成一个<strong>虚拟的社会</strong>，并<strong>自成一个经济体</strong>。</p><p>这时，元宇宙就不会再局限于社交和娱乐等基本活动，它<strong>几乎可以取代真实世界中的一切事情</strong>，在虚拟世界中，将会有真正的工作、商业买卖、虚拟的资产和货币、甚至可以会出现独立的政府，而这一切，又可以与真实世界互通，届时将会出现新的基于元宇宙社会的应用，也会有基于元宇宙的职业。</p><h3 id="阶段四虚拟和现实融为一体"><a class="markdownIt-Anchor" href="#阶段四虚拟和现实融为一体"></a> 阶段四：虚拟和现实融为一体</h3><p>到了元宇宙的终极形态，<strong>虚拟和现实可能就已经完全融为一体</strong>了。</p><p>这时，人类能在是虚拟世界中，体验现实世界所有能够尝试的体验，甚至可以<strong>做到在真实世界中所做不到的事情</strong>，人类是都充满想象力的，之前我们的幻想只能停留在视觉和听觉这两个维度上，比如我们可以把幻想拍成电影供大家欣赏，但是在元宇宙的终极形态中，<strong>虚拟技术也许可以控制人类的大脑皮层，实现味觉、嗅觉、触觉等感官的模拟</strong>，让你坐在自家沙发，就可以感受到吃到虚拟美食的快感、身处花圃中的芬芳或者遨游太空的失重感等等。</p><p>如果元宇宙的终极形态可以实现，那么很显然，现在现实社会中的所有活动都可以在元宇宙中实现，反过来，元宇宙中的活动现实社会中却不一定能够做到，从这个角度来看，元宇宙的经济规模必然会大于现实世界。</p><h2 id="产业生态"><a class="markdownIt-Anchor" href="#产业生态"></a> 产业生态</h2><p>随着芯片技术的提升，5G技术的普及，云计算、区块链技术的成熟，元宇宙的发展也有了足够的土壤，另外资本也在加速进军这一领域，近几年包括Facebook，微软，苹果等科技巨头都相继入场，尤其是Facebook以及All in元宇宙，这必将会推动元宇宙的发展，并吸引更多的资金来进场，毕竟元宇宙看上去还是一个数十万亿的产业，嗅觉敏感的资本必然不会放过这样的机会。</p><h3 id="国外产业生态"><a class="markdownIt-Anchor" href="#国外产业生态"></a> 国外产业生态</h3><p><img src="https://static.v2grad.com/img/202203251751892.png" alt="国外元宇宙产业生态" /></p><h3 id="国内产业生态"><a class="markdownIt-Anchor" href="#国内产业生态"></a> 国内产业生态</h3><p><img src="https://static.v2grad.com/img/202203251752730.png" alt="国内元宇宙产业生态" /></p><h2 id="写在最后"><a class="markdownIt-Anchor" href="#写在最后"></a> 写在最后</h2><h3 id="末路-or-天堂"><a class="markdownIt-Anchor" href="#末路-or-天堂"></a> 末路 or 天堂？</h3><blockquote><p>元宇宙带领人类走向穷途末路？或者走向天堂？</p></blockquote><p><strong>刘慈欣</strong></p><ul><li>高度致幻的“精神鸦片”</li><li>如果元宇宙走在星际文明之前，现实将崩塌</li><li>引导人类走向死路</li></ul><p><strong>凯文凯利</strong></p><ul><li>未来科技发展方向，就是“镜像世界”，元宇宙</li><li>元宇宙是人类的归宿，无论走不走星际文明</li></ul><p><strong>罗森博格</strong></p><ul><li>标签化：根据权力者好恶，标签化国家或个人</li><li>过滤层：元宇宙掌控者付费过滤信息，失去公平</li></ul><h3 id="割韭菜-or-新赛道"><a class="markdownIt-Anchor" href="#割韭菜-or-新赛道"></a> 割韭菜 or 新赛道？</h3><p>元宇宙走红后，各种套路、骗局乱象滋生，一些知识付费项目打着元宇宙的口号牟利，并声称“未来只有元宇宙这一条路”；一些企业忙于抢注各种相关商标，企图从中分得“一杯羹”。</p><p>元宇宙虽然宏大，但仍处于“<strong>讲故事</strong>”的阶段。我们要理性看待对元宇宙的设想，因为每一次技术变革都不是一蹴而就的，这个过程一定会经历<strong>疯狂，失望，再疯狂</strong>的过程，就像00年的互联网泡沫，18年的区块链泡沫一样，我相信元宇宙概念，不久后也会经历同样的过程，也会出现大量蹭热度的公司，也会出现大量不理性的投资者，我们要做的，就是要时刻保持清醒的头脑，坚持独立思考，不要在市场疯狂的时候随大流。</p><p>人民日报称元宇宙“是镜花水月还是触摸得到的未来，是资本炒作还是新的赛道，是新瓶装旧酒还是科技新突破，下结论前不妨‘<strong>让子弹飞一会儿</strong>’”</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><p>[1]<a href="https://www.sohu.com/a/511854190_219833">元宇宙到底解决什么问题？我们为什么需要元宇宙？元宇宙会经历寒冬吗？ </a><br />[2]<a href="https://www.youtube.com/watch?v=116IIA_TGJc">元宇宙来了！哪些是骗局？哪些是机会？未来10年的投资布局，在此一举！</a><br />[3]<a href="https://crypto001.com/metaverse/10790.html">一文读懂元宇宙六大技术全景图</a><br />[4]<a href="http://www.199it.com/archives/1384572.html">清华大学：元宇宙发展研究报告2.0版</a><br />[5]<a href="https://www.shangyexinzhi.com/article/4664830.html">2022元宇宙产业发展趋势报告-速途元宇宙研究院</a></p>]]>
    </content>
    <id>https://v2grad.com/2022/03/26/metaverse/</id>
    <link href="https://v2grad.com/2022/03/26/metaverse/"/>
    <published>2022-03-26T02:00:00.000Z</published>
    <summary>元宇宙是目前非常火的概念，它到底是“割韭菜”还是“新赛道”？下结论前不妨让子弹飞一会儿。阅读了一些研报以后，解开了我关于“什么是元宇宙？”、“为什么需要元宇宙？”的疑问，重点调研了实现元宇宙的关键技术和产业生态，梳理成本文。</summary>
    <title>元宇宙的关键技术和实现路径</title>
    <updated>2022-03-25T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="计算广告" scheme="https://v2grad.com/categories/%E8%AE%A1%E7%AE%97%E5%B9%BF%E5%91%8A/"/>
    <category term="黑灰产" scheme="https://v2grad.com/tags/%E9%BB%91%E7%81%B0%E4%BA%A7/"/>
    <category term="反作弊" scheme="https://v2grad.com/tags/%E5%8F%8D%E4%BD%9C%E5%BC%8A/"/>
    <content>
      <![CDATA[<p>黑灰产的英文翻译是<strong>Black Market</strong>，被定义为通过人工方式或者技术手段实施的操纵网络信息内容，获取违法利益、破坏网络生态秩序的行为。</p><p>当今黑产以恶意账号为代表的各类攻击资源已经高度的模块化和市场化，产业链不同层级的团伙专注于不同的任务而又配合严密，而究其根本，是强自动化使得攻击变得可复制，进而形成套路化的盈利模式，对企业资产造成威胁。</p><h2 id="行业现状"><a class="markdownIt-Anchor" href="#行业现状"></a> 行业现状</h2><h3 id="商业模式"><a class="markdownIt-Anchor" href="#商业模式"></a> 商业模式</h3><p>商业模式：电商平台薅羊毛、直播平台刷量、社交平台刷粉、网络诈骗</p><ul><li>在<strong>社交</strong>行业，黑灰产会利用大量虚假账号批量向平台用户发送信息，引流到微信或 QQ 上，然后进行诈骗。</li><li>在<strong>电商</strong>行业，黑灰产的表现是刷单，制造虚假的交易量。</li><li>在<strong>直播、短视频</strong>等平台，最典型的是刷量，黑灰产通过刷播放、关注、点赞、评论等方式进行广告引流，甚至实施网络诈骗。</li><li>在<strong>出行</strong>平台，黑灰产的典型活动是抢单和代打。</li></ul><p>以直播平台刷量为例，通过刷量可以帮助主播上各种排行榜；给主播购买僵尸粉，可以增加主播的粉丝数；在主播的直播间购买水军，可以增加直播间人气等等。一方面，这些数据可以直接在平台折现成现金奖励，由此获利；另一方面，伪造人气可以吸引更多的粉丝，进而通过粉丝打赏获利。</p><p>黑灰产的最大特点就是<strong>逐利</strong>。“<strong>只要是能产生利益的地方几乎逃不开黑灰产的觊觎。即使表面看上去获利很低，但黑灰产依然会想办法通过批量操作来规模获利</strong>”。以新人红包为例，邀请一个小号可能只有几毛钱的红包，去掉成本后，单个账号的收益可能不到1毛钱，但是如果不做限制，黑灰产可以在极短时间内注册几十万甚至上百万的账号，最后还是能赚得盆满钵满。</p><h3 id="发展趋势"><a class="markdownIt-Anchor" href="#发展趋势"></a> 发展趋势</h3><p>与以前相比，黑灰产的攻击方式或手段有了很大变化，主要体现在以下三方面：</p><ul><li>从早期单一的兼职刷单，到如今的多行业、多场景、多任务的广泛渗透；</li><li>从早期的只在 PC 端进行单一手法的兼职，到如今以移动端为主；</li><li>从早期的线上群组媒介（QQ 群、YY 语音等），到如今的平台化和裂变化。</li></ul><p>从成本和收益来看，黑灰产的攻击成本主要来源于其发起攻击时所需要的各种资源，主要有：</p><ul><li><strong>账号资源</strong>：在目标业务上注册的虚假账号</li><li><strong>IP资源</strong>：为绕过目标的 IP 风控，购买代理或秒拨 IP</li><li><strong>设备</strong>：在设备上安装目标应用</li><li><strong>自动化工具</strong>：批量操控多台设备的群控工具，修改设备信息，从而伪造新设备的改机工具等</li></ul><p>黑灰产的收益则是甲方业务营销费用的损失。有一些收益比较直接，比如现金红包，可以直接提现；还有一些收益需要变现，例如优惠券。不过，黑灰产有发卡平台、回收平台等成熟的变现渠道，所以变现也不成问题。</p><p>近年来，以<strong>云计算、大数据和人工智能</strong>等代表的新技术的出现或应用，在某种程度上也加速了黑灰产的发展。</p><p>我们来看一个典型的例子。<strong>云计算</strong>的发展让个人搭建和维护一个网络平台的成本大大降低，其中包括黑灰产产业链中的一些平台，像提供虚假注册手机号的接码平台、提供海量IP地址的代理和秒拨平台、提供图像和滑动等验证码绕过服务的打码平台、提供交易和变现渠道的发卡平台等，很多搭建在国内或海外的云服务器上。</p><p>这些平台的大量出现，打通了黑灰产的上下游供给，不仅降低了攻击成本，而且还提供了 API 接口等方式便于自动化，进一步提升了攻击效率，让黑灰产可以更容易地实施大规模的批量攻击，收益也更大。</p><h3 id="攻击方式"><a class="markdownIt-Anchor" href="#攻击方式"></a> 攻击方式</h3><p><strong>机器作弊</strong><br />通过自动化的机器程序来伪造真实的用户行为，它又分为协议攻击和脚本攻击两种。</p><ul><li><strong>协议攻击</strong>指的是通过破解业务前端和服务器的通信协议，直接伪造并发起注册登录等业务请求；</li><li><strong>脚本攻击</strong>指的是通过编写按键精灵、autojs 等脚本，操控前端应用或网页的界面元素，比如输入框自动填入账号密码、自动点击登录按钮。</li></ul><p>值得注意的是，前者不需要有设备安装业务应用，攻击成本更低，更容易规模化，危害也更大。</p><p><strong>真人作弊</strong><br />与机器作弊不同，真人作弊背后是一个个真实的人，黑灰产往往通过发布赏金任务，吸引真人协助其完成作恶。</p><p>不过，随着近年来甲方业务风控的不断加强，机器作弊很多时候会被识别出来，而<strong>真人作弊识别难度非常大</strong>，因此真人作弊越来越多，模式和形态越发多元和丰富。</p><h3 id="产业链条"><a class="markdownIt-Anchor" href="#产业链条"></a> 产业链条</h3><p>黑灰产之所以能有现在的发展，关键是其形成了一个分工明确、协助紧密的成熟产业链。据了解，整个黑灰产的产业链大致可以分为上游、中游和下游三个环节，其中，<strong>上游提供资源和技术，下游进行作恶和变现，而中游则连接上游和下游</strong>。</p><p><img src="https://static.v2grad.com/img/202203070903606.jpeg" alt="黑灰产行业产业链结构" /></p><p>整个产业链中，比较关键的部分包括上游是否能持续稳定的提供可靠的资源和技术，下游是否能有稳定的变现途径或渠道，中游是否能高效的连接上游和下游，保持稳定的供需关系。如果这几点不出问题，整个产业链的运作就会很顺畅。</p><h2 id="上游环节"><a class="markdownIt-Anchor" href="#上游环节"></a> 上游环节</h2><blockquote><p>软件开发与技术支持</p></blockquote><h3 id="接码平台"><a class="markdownIt-Anchor" href="#接码平台"></a> 接码平台</h3><p><strong>黑卡运营商</strong><br />手机黑卡是指没有在运营商进行实名认证，被不法分子利用进行薅羊毛攻击、传播淫秽色情信息、实施通讯信息诈骗、组织实施恐怖活动等违法犯罪活动的移动电话卡。<br />黑卡运营商通常与三大运营商代理勾结，或者黑卡运营商本身就是三大运营商代理。他们在获得大量手机卡后通过加价转卖给下游手机卡商赚取利润。其黑卡主要来源有：实名卡、物联网卡、海外卡以及虚拟卡。</p><ul><li><strong>实名卡</strong>：实名卡主要是通过拖库撞库、木马、钓鱼等方式从网上收集大量身份证信息，并通过黑卡运营商批量验证得到的。</li><li><strong>物联网卡</strong>：物联网卡是由三大运营商提供的 4G/3G/2G 卡，硬件和外观与普通 SIM 卡相似，但采用专用号段，并加载针对智能硬件和物联网设备的专业化功能，满足智能硬件和物联网行业对设备联网的管理需求以及集团公司连锁企业的移动信息化应用需求。主要有基础通信、财务信息查询、终端状态查询、业务统计分析四大功能。物联网卡无需进行实名验证，由企业申请办理，一般仅需提供营业执照，实际操作中，营业执照通过财务公司操作，大概需要花费 1000 元左右即可成功注册，部分运营商对营业执照审核不够严谨，甚至会为灰产定制专用的物联网卡套餐。这种物联网卡多为免月租或者 1 元月租，根据能否接听电话，分为短信卡（也称“注册卡”）和语音卡。</li><li><strong>海外卡</strong>：在国家实行实名制后，黑卡运营商直接从海外购入手机卡，这些卡无需实名认证，花费很少，非常切合黑产利益。</li><li><strong>虚拟卡</strong>：由虚拟运营商提供的电话卡。虚拟运营商是指拥有技术、设备供应、市场营销等能力，与传统三大运营商在某项或者某几项业务上形成合作关系的合作伙伴。虚拟运营商就像是代理商，他们从移动、联通、电信三大基础运营商那里承包一部分通讯网络的使用权，然后通过自己的计费系统、客服号、营销和管理体系把通信服务卖给消费者。</li></ul><p><strong>猫池厂商</strong><br />猫池厂商负责生产猫池设备，并将设备卖给卡商使用。猫池是一种插上手机卡就可以模拟手机进行收发短信、接打电话、上网等功能的设备，在正常行业有广泛的应用，如邮局、银行、证劵商、各类交易所、各类信息呼叫中心等，猫池设备可以实现对多张卡的管理。<br /><img src="https://static.v2grad.com/img/202202261208728.png" alt="猫池厂商" /></p><p><strong>手机卡商</strong><br />手机卡商从黑卡运营商那里大量购买手机黑卡，将手机黑卡插入猫池设备并接入收码平台，然后通过收码<br />平台接收各种验证码业务，根据业务类型的不同，每条验证码可以获得 0.1 元 -0.3 元不等的收入。</p><p><strong>接码平台</strong><br />负责连接卡商和有手机验证码需求的群体，提供软件支持、业务结算等平台服务，通过业务分成获利，一般为30%左右。<br /><img src="https://static.v2grad.com/img/202202261229437.png" alt="接码平台" /></p><h3 id="打码平台"><a class="markdownIt-Anchor" href="#打码平台"></a> 打码平台</h3><p>很多网站都会通过图片验证码来识别机器行为，对非正常请求进行拦截。因此打码平台已成为大多数黑产软件必备的模块之一，为黑产软件提供接口，<strong>突破网站为辨别机器还是人类行为而设置的图片验证码</strong>。</p><p>文字、图像、声音等验证码的技术难度较高，打码平台通常难以完全依赖技术手段实现自动操作。国内的打码平台，以往主要依靠低廉的劳动力。他们对无法技术解决的验证码使用人工打码进行破解。这种方式广泛传播到了大量第三世界国家，导致全球有近百万人以此为生。<strong>打码工人</strong> 平均每码收入1-2分钱，熟练工每分钟可以打码20个左右，每小时收入10-15 元。</p><p>随着技术的发展，打码平台也与时俱进，逐渐产生了使用<strong>人工智能</strong>打码的平台，使用了伯克利大学的数据模型，引入大量验证码数据对识别系统进行训练，将机器识别验证 码的能力提高了2000倍，价格降低到了每千次15-20元，为撞库等需要验证的业务提供了极大的便利。</p><p><img src="https://static.v2grad.com/img/202202261230487.png" alt="打码平台" /></p><h3 id="黑产软件"><a class="markdownIt-Anchor" href="#黑产软件"></a> 黑产软件</h3><p><strong>IP代理</strong><br />IP作为互联网空间中最基础的身份标识，一直以来都是黑产与甲方争夺对抗最激烈的攻防点。<br />这是一个高度成熟产业，国内代理、国外代理、国内秒拨软件等。<br /><img src="https://static.v2grad.com/img/202202262207579.png" alt="IP代理" /></p><p>因为目前机房的服务器IP基本已经被标识，所以这部分代理IP基本无法使用，所以需要有大量的家庭住宅IP。<br /><strong>国外</strong>可以走代理，有专门的服务商在提供动态住宅IP，比如luminati代理、911代理以及oxylabs代理，单价很高。<br /><strong>国内</strong>基本都是秒拨软件实现的，秒拨的底层思路就是利用国内家用宽带拨号上网（PPPoE）的原理，每一次断线重连就会获取一个新的IP，秒拨有两个天然的优势：</p><ul><li><strong>IP池巨大</strong>：假设某秒拨机上的宽带资源属于XX地区电信运营商，那么该秒拨机可拨到整个XX地区电信IP池中的IP，少则十万量级，多则百万量级；</li><li><strong>难以识别</strong>：因为秒拨IP和正常用户IP取自同一个IP池，秒拨IP的使用周期（通常在秒级或分钟级）结束后，大概率会流转到正常用户手中，所以区分秒拨IP和正常用户IP难度很大。</li></ul><p><strong>改机工具</strong><br />刷新设备指纹，解决单台设备注册的上限。<br />Android和iOS都有很多相应的改机工具。Android改机大部分都基于Xposed框架，需要root；iOS大多基于Cydia框架，需要越狱。</p><ul><li><p><strong>Xposed</strong>号称Android上最强大的神器，它是一个框架，上面有很多模块，这些模块都依赖于xposed这个框架，之所以称xposed是第一神器，就是因为这些模块可以完成许多匪夷所思的功能，例如：修改微信的界面，自动抢红包模块，自定义程序的文本，防止微信消息撤回，防止BAT三大流氓的全家桶相互唤醒、连锁启动，锁屏后自动干掉APP防止后台运行耗电，还有很多修改App或手机数据的装B模块等等。<br /><img src="https://static.v2grad.com/img/202203030925367.png" alt="Android Xposed改机工具" /></p></li><li><p><strong>AWZ</strong>国内最新支持iOS全系统的一键新机、全息备份、位置伪装、ASO辅助工具，手机一键新机，轻松修改设备参数，功能定时更新，多重保障软件稳定运行，为用户提供更好体验。为iPhone/iPad提供反越狱检测，修改系统序列号、型号、系统版本、运营商、地理位置、MAC、UUID、IMEI、IDFA、SSID应用全息备等一系列强大功能。<br /><img src="https://static.v2grad.com/img/202203030930716.png" alt="iOS AWZ改机工具" /></p></li></ul><p><strong>群控平台</strong><br />群控是指通过一台电脑或者手机设备控制批量手机的行为，可以分为<strong>线控</strong>和<strong>云控</strong>两种形式。 <strong>线控</strong>是指信号 发生器与被控制的手机设备通过线缆进行连接的; <strong>云控</strong>指手机搭载了云技术可以实现远程控制，可以用任意一台PC通过云端控制手机终端上的任何资料，随意调取自己所需的信息，或者使用另一部手机用ID登录云服务器。通过群控工具，可以实现一台终端对多台手机的控制，与改机工具进行搭配，可以在短时间内制造成千 上万不同设备的信息，适用于羊毛党的批量攻击。</p><ul><li><p><strong>群控</strong>：指通过系统自动化控制集成技术，把多个手机操作界面直接映射到电脑显示器，实现由一台电脑来控制几十台甚至上百台手机的效果。以某社交平台群控为例，它是在群控体系基础上，针对其定制化、批量模仿正常个人用户操作的软硬件集成体系。它以群控体系+各种批量模仿脚本的方法，完成批量操作，其所有任务执行都是同时进行的。</p></li><li><p><strong>箱控</strong>：是群控的进化变种，把手机核心组件都做到一个箱子，去掉一些用不上的硬件，做成的专门的群控设备，一个箱子可操控多台手机的多个APP，具体方法是使用了一款名为appium的安卓自动化测试工具，通过文字、控件id、控件名称等直接定位到APP的控件进行操作。</p></li><li><p><strong>传统云控</strong>：通过无线连接。电脑通过后台发送指令到云端，云端的指令再发到手机群，继而执行任务。理论上，一台电脑可以控制上千台手机</p></li><li><p><strong>新型云控</strong>：主要指的是通过云端协议外挂的形式，发送数据包与服务器进行交互，自定义进行登录互联网帐号、绑定邮箱、更改密码等操作。一台电脑一个账号就可以操控上万个帐号。</p></li></ul><h2 id="中游环节"><a class="markdownIt-Anchor" href="#中游环节"></a> 中游环节</h2><blockquote><p>账号注册与分销</p></blockquote><h3 id="盗号扫号养号"><a class="markdownIt-Anchor" href="#盗号扫号养号"></a> 盗号扫号养号</h3><p><strong>盗号</strong>：<br />盗号，就是通过一定手段，盗取他人账号和密码，</p><ul><li>初级盗号以<strong>钓鱼</strong>为主，钓鱼就是以假乱真，欺骗你自己输入帐号密码。</li><li>中级盗号以<strong>木马/键盘钩子记录</strong>为主，讲究驱动级钩子，过杀毒软件。<br /><img src="https://static.v2grad.com/img/202203061219344.png" alt="木马盗号" /></li><li>高级盗号以<strong>入侵网站</strong>为主，讲究渗透，注入，提权，后门。</li></ul><p><strong>扫号</strong><br />扫号就是利用了网络上公开的数据不停的对网站提交身份验证的数据包（比如常见的登录验证），来验证是否是本站会员，也就是<strong>撞库</strong>。<br /><img src="https://static.v2grad.com/img/202203061527969.png" alt="扫号" /></p><p><strong>养号</strong><br />批量注册小号，不断发作品、关注用户，修改头像，主要目的是为了降低账号被封的概率。</p><p>账号恶意注册是恶意行为的源头，整个流程已趋于专业化、从业人员十万级，形成了手机验证码服务平台、打码平台、注册软件开发团伙、垃圾账号分销平台等一条龙服务。 批量性恶意注册主要是通过软件实现的，具体流程如下图：<br /><img src="https://static.v2grad.com/img/202203070908068.png" alt="养号" /></p><h3 id="跳转号"><a class="markdownIt-Anchor" href="#跳转号"></a> 跳转号</h3><p>指使用QQ号或者微博快捷登录的账号，激活绑定转换而成的号码。</p><p>恶意注册商也就是号商，注册海量的社交帐号，并通过脚本工具获取62数据或A16数据。</p><p>这两个数据是某社交平台用户登录新设备后生成的加密文件，这个文件储存在其安装目录中，下次运行时检测到该文件就可以自动登录。如果把这个文件中的数据导入到另一部设备中，那么这部设备也可以跳过登录验证的步骤直接登录账号。</p><p>恶意注册商就是通过这种手法，搭配注册的社交账号、密码进行售卖，黑产团伙购买后在云控平台上登录使用。<br /><img src="https://static.v2grad.com/img/202203051605329.png" alt="恶意注册" /></p><h3 id="发卡平台"><a class="markdownIt-Anchor" href="#发卡平台"></a> 发卡平台</h3><p>把数字商品做<strong>自动化交易的平台</strong>，在号商完成大量账号的注册后，他们会把恶意账号整理后集中在发卡平台中列出，供处在产业链下游的用号方直接线上批量采购。</p><p><img src="https://static.v2grad.com/img/202203062140015.png" alt="发卡平台" /></p><h2 id="下游环节"><a class="markdownIt-Anchor" href="#下游环节"></a> 下游环节</h2><blockquote><p>盈利变现</p></blockquote><p>用号方会根据自身作恶场景，通过发卡平台买入对应的虚假账号，用以薅羊毛，平台刷量，账号诈骗等场景。</p><h3 id="引流"><a class="markdownIt-Anchor" href="#引流"></a> 引流</h3><p>引流黑产下游主要包括黑五类产品销售、色情诈骗和杀猪盘等。<br /><img src="https://static.v2grad.com/img/202203062155324.png" alt="引流黑产产业链示意图" /></p><h3 id="刷量"><a class="markdownIt-Anchor" href="#刷量"></a> 刷量</h3><p>刷直播平台的播放量、点赞评论、收藏<br /><img src="https://static.v2grad.com/img/202203062201833.png" alt="机器进行自动刷量" /></p><p><img src="https://static.v2grad.com/img/202203062201917.png" alt="人工刷量" /></p><h3 id="薅羊毛"><a class="markdownIt-Anchor" href="#薅羊毛"></a> 薅羊毛</h3><p>平台补贴<br /><img src="https://static.v2grad.com/img/202203062204196.png" alt="薅羊毛" /></p><h2 id="风控手段"><a class="markdownIt-Anchor" href="#风控手段"></a> 风控手段</h2><p>企业而言，<strong>首先，需要重视黑灰产</strong>，在业务发展的每个阶段都要投入相匹配的人力进行业务安全建设，从而保障业务健康增长；<strong>其次，对黑灰产要有足够的认识</strong>，了解黑灰产对自身业务会产生哪些危害，这样才能“对症下药”。</p><h3 id="识别黑灰产资源"><a class="markdownIt-Anchor" href="#识别黑灰产资源"></a> 识别黑灰产资源</h3><p>黑灰产在作恶和变现时都重度依赖于其手中持有的基础资源，包括但不限于手机号、IP、设备等。而这些黑灰产资源对于企业方来说，是全黑的数据，如果能将这些数据与自身业务数据进行匹配，就可以直接识别出恶意帐号或黑灰产恶意行为，针对性的进行相应的风险控制。</p><h3 id="分析黑产工具"><a class="markdownIt-Anchor" href="#分析黑产工具"></a> 分析黑产工具</h3><p>黑灰产的攻击工具承载着黑灰产的攻击逻辑和利用的企业业务漏洞，通过对工具的监控和逆向，企业可以了解到自身存在哪些业务逻辑漏洞或者是哪些风控策略已经失效，从而提升整个攻防对抗的效率。</p><h3 id="监控黑灰产交易变化"><a class="markdownIt-Anchor" href="#监控黑灰产交易变化"></a> 监控黑灰产交易变化</h3><p>黑灰产交易品类和价格的变动，能够反映出企业一定周期内风控策略的有效性。例如，即使企业上线了风控策略，但是黑灰产仍然能够以很低的成本完成恶意帐号的注册，则表示企业的风控策略失效了；另一方面，如果发现黑灰产交易价格变高，反映出黑灰产攻击成本的上升，则可以看出企业的风控策略有了一定的效果。有效的风险评估，能更好地推动业务安全的落地和迭代。</p><blockquote><p>“<strong>黑灰产是互联网发展到一定阶段的必然产物，我们不太可能完全消灭黑灰产。</strong><br />一方面，要有效的控制黑灰产，不让其泛滥成为“洪水猛兽”；<br />另一方面，也不能用力过猛，影响用户体验，甚至对业务造成伤害。”<br />– 邓欣。</p></blockquote><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><p><a href="https://cloud.tencent.com/developer/news/681248">专访全球黑客大赛冠军邓欣</a><br /><a href="https://bbs.pediy.com/thread-251609.htm">黑灰产欺诈场景剖析：虚假账号的产生和流转 / 永安在线</a><br /><a href="https://zhuanlan.zhihu.com/p/259907585">“群控”终极篇：五代流量黑产全解构 / 腾讯安全战略研究</a><br /><a href="http://www.brgroup.com/media/report/%E5%8F%8D%E6%AC%BA%E8%AF%88%E8%A1%8C%E4%B8%9A%E8%B0%83%E7%A0%94%E7%99%BD%E7%9A%AE%E4%B9%A6.pdf">反欺诈行业调研白皮书 / 百融云创</a></p>]]>
    </content>
    <id>https://v2grad.com/2022/03/07/black-market/</id>
    <link href="https://v2grad.com/2022/03/07/black-market/"/>
    <published>2022-03-07T02:00:00.000Z</published>
    <summary>要真正做好反作弊，就必须要先了解黑灰产行业的现状，掌握作弊手段和作弊成本。这里梳理了网络黑灰产的行业现状以及产业链中上游、中游和下游的分工：上游提供资源和技术，下游进行作恶和变现，而中游则连接上游和下游。</summary>
    <title>网络黑灰产的行业现状和产业链条</title>
    <updated>2022-03-06T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="读书笔记" scheme="https://v2grad.com/categories/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="读书笔记" scheme="https://v2grad.com/tags/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="OKR" scheme="https://v2grad.com/tags/OKR/"/>
    <content>
      <![CDATA[<p><img src="https://static.v2grad.com/img/202202170903465.jpeg" alt="这就是OKR &amp; ORK工作法" /></p><p>今年准备用OKR帮助自己更好的完成工作和生活的年度目标，OKR是一套高效能定制目标的方法，为了系统的学习，我找来 <strong>约翰·杜尔（John Doerr）</strong> 的 <strong>《Measure What Matters》</strong> 进行阅读，这本书中文有两个翻译版本，一个是由曹仰锋/王永贵翻译、中信出版社出版的 <strong>《这就是OKR｜让谷歌、亚马逊实现爆炸性增长的工作法》</strong>，一个是由許瑞宋翻译、天下文化出版的 <strong>《OKR：做最重要的事》</strong>。</p><p>作者<strong>约翰·杜尔</strong>是美国最有影响力、最具创意、最不拘传统的冒险资本投资家之一，被誉为“<strong>风险投资之王</strong>”。2021年4月，他以124亿美元位列《2021福布斯全球富豪榜》第177名。他是OKR目标管理法的早期实践者，更是OKR的布道者。</p><p>后来又去读了一下 <strong>克里斯蒂娜·沃特克</strong> 的 <strong>《OKR工作法｜谷歌、领英等顶级公司的高绩效秘籍》</strong> ，当然这本书跟谷歌、领英没什么关系，它用了一个非常特别的体裁，以2/3的篇幅构筑了一个虚构商业故事，围绕一家创业公司的试错、困惑、决断和成长的全过程，说明了OKR工作法的基本原理和实施原则。</p><p>作者<strong>克里斯蒂娜·沃特克</strong>是硅谷著名的产品专家，她曾经在Myspace（一家社区交友网站）、领英和Zynga（一家社交游戏公司）负责过重要的产品设计和管理工作。</p><h2 id="okr"><a class="markdownIt-Anchor" href="#okr"></a> OKR</h2><h3 id="okr是什么"><a class="markdownIt-Anchor" href="#okr是什么"></a> OKR是什么</h3><p><strong>OKR（Objectives and Key Results）</strong> 即目标与关键成果法，是一套明确和跟踪目标及其完成情况的管理工具和方法，能够将目标管理自上而下贯穿到基层。</p><p><img src="https://static.v2grad.com/img/202202171330073.png" alt="什么是OKR" /></p><p>OKR包含2个组成部分，即目标（Objectives）和关键结果（Key Results）两部分。目标（O）是定性陈述，关键结果（KR）是定量的。设计KR最具挑战的部分是如何把目标中定性的部分翻译为定量的数字化的表示。</p><p><strong>目标(Objectives)</strong>：目标就是你想要实现的东西，不要将其夸大或缩小。根据定义，目标应该是重要的、具体的、具有行动导向并且能鼓舞人心的。</p><blockquote><p>“我们要在中距微型计算机组件业务上占据主导地位。” 这是我们努力要实现的。</p></blockquote><p><strong>关键结果(Key Results)</strong>：关键结果是检查和监控我们如何达到目标的标准。有效的关键结果应该是具体的、有时限的且具有挑战性的，但又必须是能够实现的。最重要的是，它们必须是可衡量、可验证的。</p><blockquote><p>“为8085型号处理器做出10个新型设计”是关键结果之一，也是一个里程碑。</p></blockquote><p><img src="https://static.v2grad.com/img/202202122158571.png" alt="OKR" /><br />OKR在将企业的使命愿景战略具象化并落地，帮助企业聚焦目标（方向一致），激发自驱力（激活个体），处于一个<strong>承上启下</strong>的位置。</p><p>也有一种论调在说：<strong>“OKR其实不是管理工具，而是沟通工具”</strong>，因为OKR并不是万能的，它不能代替正确的判断、强有力的领导和创造性的企业文化，但是，如果这些基本要素能够到位的话，OKR就能引导个人和团队走向顶峰。</p><h3 id="okr的发展历史"><a class="markdownIt-Anchor" href="#okr的发展历史"></a> OKR的发展历史</h3><p><img src="https://static.v2grad.com/img/202202120909702.png" alt="ORK工作法" /></p><ul><li>1968年，安迪·格罗夫在英特尔发明了OKR这套目标管理办法；</li><li>1974年，约翰·杜尔加入了英特尔，跟安迪·格罗夫学习了OKR并身体力行的践行着OKR的实施原则；</li><li>1999年，在Google成立不到一年的时候，约翰·杜尔投资了他们，并向他们的领导层提出OKR的概念。虽然它的创始人谢尔盖·布林和拉里·佩奇拥有强大的创业能量和雄心勃勃的愿景，但他们没有实现这一目标的管理技术，正是OKR让Google实现了100亿美元收入的雄心勃勃的目标；</li><li>2017年，约翰·杜尔发表了他的《Measure What Matters》，并将这一管理智慧，分享给50多家公司和机构。</li></ul><h3 id="okr-vs-kpi-vs-mbo"><a class="markdownIt-Anchor" href="#okr-vs-kpi-vs-mbo"></a> OKR VS KPI VS MBO</h3><p><img src="https://static.v2grad.com/img/202202122118890.png" alt="MBO-&gt;KPI-&gt;OKR的进化历程" /><br />彼得·德鲁克在上世纪60年代提出了 <strong>目标管理法(Management by Objectives，MBO)</strong> 的思想，MBO的原理很简单，它基于<strong>两个基本原则</strong>：第一个原则可以用乔治·巴顿的名言概括，<strong>“不要告诉下属具体怎么做，只要告诉他们你要什么，他们就会给你满意的结果”</strong>；第二个原则可以用那个时代一句惠普内部的宣传语概括，<strong>“用关键结果衡量工作绩效”</strong>，即如果基础的商业问题没有解决，不论实现多少产品功能，团队整体的绩效一定会大打折扣。第一个原则是在说如何调动团队的积极性，第二个原则是在讲怎样评估工作绩效。</p><p>此后80年代 <strong>SMART原则(Specific、Measurable、Achievable、Relevant、Time-bound)</strong> 和 <strong>关键绩效指标（Key Performance Indicators，KPI）</strong> 开始流行起来。KPI把对绩效的评估简化为对几个关键指标的考核，将关键指标当作评估标准，把员工的绩效与关键指标作出比较的评估方法，在一定程度上可以说是目标管理法与帕累托定律的有效结合。关键指标必须符合SMART原则：具体性（Specific）、衡量性(Measurable)、可达性(Attainable)、现实性(Realistic)、时限性(Time-based)。</p><p>后来英特尔公司结合了前面的多种理论，发展成为OKR，OKR能适度弥补过度强调目标管理和KPI，导致悖离公司愿景的缺陷。1999年John Doerr把OKR引入Google。</p><p>一句话概括三者之间的差别：MBO目标管理是「<strong>主管和员工都想做的事</strong>」，KPI是「<strong>主管要员工做的事</strong>」，OKR则是「<strong>我自己想做的事</strong>」</p><p><img src="https://static.v2grad.com/img/202202150934879.png" alt="MBO vs OKR vs KPI" /></p><h2 id="okr的实施步骤"><a class="markdownIt-Anchor" href="#okr的实施步骤"></a> OKR的实施步骤</h2><h3 id="确定目标"><a class="markdownIt-Anchor" href="#确定目标"></a> 确定目标</h3><p>目标来源于对业务战略或工作计划的分解，同时，也是确定关键成果的唯一依据。知道要去哪里的人，往往会更加清楚如何到达目的地。</p><p>确定目标时需要满足如下要求:</p><ul><li><strong>目标明确且具有挑战性</strong>：目标要有野心，并非百分之百能够完成目标，让员工走出能力“舒适区”，最好达到能力挑战区。</li><li><strong>兼顾自上而下与自下而上</strong> ： 设定的方式总体而言是自上而下，同时鼓励员工自主发起目标，并与直接上级进行讨论。</li><li><strong>简洁、聚焦</strong>： 每人每个季度目标不超过5个，强调对目标的筛选和重要性的把握，将有限的资源聚焦在最重要的事情上。</li><li><strong>公开透明</strong>： 任何层级的OKR在全公司内公开透明，保证从组织到个人目标的一致性且互不重叠。</li></ul><table><thead><tr><th>好的目标</th><th>不好的目标</th></tr></thead><tbody><tr><td>拿下南湾地区的咖啡直销零售市场</td><td>销售额提升30%。</td></tr><tr><td>推出一个很棒的最小化可行产品（MVP）</td><td>用户增加一倍。</td></tr><tr><td>改变帕洛阿尔托地区的优惠券使用习惯！</td><td>B系列产品收入增加到500万美元</td></tr><tr><td>完成一轮融资。</td><td>…</td></tr></tbody></table><blockquote><p>为什么这些是不太好的目标？因为它们实质上是关键结果。</p></blockquote><h3 id="制定关键结果"><a class="markdownIt-Anchor" href="#制定关键结果"></a> 制定关键结果</h3><p>关键结果应该是明确的、具体的、可衡量的，产出和投入的组合（匹配）对其有所帮助。每个目标的关键结果都不要超过5个，完成所有关键结果的关键和前提是实现目标，如果目标没有实现，那就不是OKR了。</p><p>确定关键结果需要满足的条件：</p><ul><li><strong>必须可量化</strong>：设定可量化的关键结果能够准确衡量其完成情况，避免人浮于事。</li><li><strong>直接性</strong>： 每个KR必须是能够直接完成的，不能是间接完成，更不能通过其他协助来完成。</li><li><strong>数量精简</strong>： 每一个O分解出的KRs不超过5个，避免分散精力。</li><li><strong>周期内灵活调整</strong>： O一旦确定一般不可改变，但KRs在一个周期内可以酌情及时调整。</li></ul><p><img src="https://static.v2grad.com/img/202202170601634.png" alt="差VS好关键结果" /></p><h3 id="追踪成果"><a class="markdownIt-Anchor" href="#追踪成果"></a> 追踪成果</h3><p>不是年末或者整个OKR结束以后才进行结果评估，而是在整个过程中随时的追踪，在这期间，如果发现环境有变化或者某些关键结果亮起了红灯，就需要及时调整方向和资源投入。</p><p><strong>CFR</strong><br />我们需要一个新的人力资源模式来适应新的工作环境。这一模式就是<strong>持续性绩效管理体系</strong>，用于取代当前的年度评估体系。持续性绩效管理是通过一种叫作 <strong>CFR（Conversation，Feedback，Recognition）</strong> 的管理工具来实现的：</p><ul><li><strong>对话（Conversation）</strong>：经理与员工之间真实的、高质量的交流，旨在对绩效提升起到驱动作用。</li><li><strong>反馈（Feedback）</strong>：同事之间面对面进行双向沟通或通过网络进行交流，以评估工作进展情况并探讨未来的改进方向。</li><li><strong>认可（Recognition）</strong>：根据个体所做贡献的大小施以对等的表彰。<br /><img src="https://static.v2grad.com/img/202202170833518.png" alt="CFR" /></li></ul><p>和OKR一样，CFR在组织的各层级都强调透明、问责、授权和团队合作。CFR是有效沟通的“刺激物”，它能激发OKR，并将其送入正确的轨道。CFR是一个完整的交付系统，用于衡量什么才是最重要的事情，让绩效管理“直击要害”。CFR完全体现了安迪·格鲁夫创新方法的精髓和力量，也使得OKR更加人性化。</p><p><strong>四象限看板</strong><br />《OKR工作法》介绍了利用四象限图进行OKR跟踪，以周级别进行本周的回顾，掌握 <strong>“承担责任-庆祝成果”</strong> 的节奏</p><ul><li>每周一，团队一起开会盘点 OKR，来明确本周具体负责完成哪些任务。</li><li>每周五，召开“胜利会议”，让每个团队都可以展示本周的工作成果，并准备一些酒水饮料和点心等庆祝这些成果。</li></ul><p><img src="https://static.v2grad.com/img/202202170627210.png" alt="四象限看板" /></p><ul><li><strong>第一象限-OKR当前状态</strong>：展示目标总进度和关键成果总进度。第一象限的作用是辅助团队重新明确OKR，以及盘点当前关键结果，调整关键结果信心指数。</li><li><strong>第二象限-本周关注的任务</strong>：列出本周3~4件最重要、只有完成才能推进目标的任务，确定这几件任务的优先级。</li><li><strong>第三象限-未来四周的计划</strong>：规划近期需要准备或支持的事项。当第二象限的事项发生变化时，第三象限的工作任务也要及时调整。</li><li><strong>第四象限-其他状态目标</strong>：关键成果当前进展, 直观反应KR上出现的一系列问题，方便及时跟进排除。</li></ul><blockquote><p>关键结果后面的百分数是OKR的信心指数，它是一种自我预估的自信心度量，描述实现KR的信心。在项目推进过程中，根据进展情况，需要不断的调整这个信心指数。</p></blockquote><p><strong>总结评分</strong><br />给一个目标结果打分最简单、最明确的方法是通过计算其相关关键结果的百分比完成率。<br />谷歌使用0~1.0分作为计量标准，也就是说的<strong>交通灯打分法</strong>：</p><ul><li><strong>0.7~1.0分=绿色</strong>（0.7以上则代表完成目标，但是如果是1分，那么需要注意是否目标不够挑战，在下个周期需要加大挑战性；）</li><li><strong>0.4~0.6分=黄色</strong>（取得了进步，但是并未完成目标）</li><li><strong>0.0~0.3分=红色</strong>（并未取得进步，也没有完成目标，或者是目标挑战性太强，需要分析找出原因。）</li></ul><blockquote><p>比如我们完成了5个指标中的4个，基准得分为0.8，在绿色区域。</p></blockquote><p><img src="https://static.v2grad.com/img/202202170625472.png" alt="OKR评分" /></p><blockquote><p>KR的达成要与个人的绩效考核脱钩。</p></blockquote><h2 id="okr的四大利器"><a class="markdownIt-Anchor" href="#okr的四大利器"></a> OKR的四大利器</h2><p>约翰·杜尔在《Measure What Matters》一书中，系统地阐述了<strong>OKR系统的四大利器——聚焦、协同、追踪、挑战</strong>。</p><h3 id="聚焦对优先事项的聚焦和承诺"><a class="markdownIt-Anchor" href="#聚焦对优先事项的聚焦和承诺"></a> 聚焦：对优先事项的聚焦和承诺</h3><p>做正确的事，远比正确做事更重要。每个成员都朝着一个方向使劲，形成合力。</p><ul><li>聚焦重要的工作，同时清楚什么是不重要的。</li><li>OKR是一种精准沟通的工具，能消除困惑，让我们进一步明确目标，聚焦到关键的成功要素上。</li></ul><blockquote><p>OKR系统应该为企业提供最卓越的东西，即“聚焦”。只有当我们将目标的数量保持在很小时，才会真正聚焦于此。<strong>季度OKR的理想数量往往介于3个到5个之间</strong> 。</p></blockquote><h3 id="协同团队工作的协调和联系"><a class="markdownIt-Anchor" href="#协同团队工作的协调和联系"></a> 协同：团队工作的协调和联系</h3><p>OKR对每个成员透明，个人与组织目标一致，相互协作。</p><ul><li>OKR具有透明性，上自首席执行官，下至一般员工，每个人的目标都是公开的。</li><li>每个员工都将个人目标与公司计划紧密联系起来，进而明确两者之间的依赖关系，并与其他团队展开通力协作。</li><li>这种自下而上的协同，将个人贡献与组织成功联系起来，为工作赋予了特定的意义。</li><li>自下而上的OKR，则通过加深员工的主人翁意识，促进了个人的参与和创新。</li></ul><blockquote><p><strong>不要雇用聪明人，然后告诉他们去做什么；而是要让他们告诉我们，应该做什么。</strong>——史蒂夫·乔布斯</p></blockquote><h3 id="追踪责任追踪"><a class="markdownIt-Anchor" href="#追踪责任追踪"></a> 追踪：责任追踪</h3><p>定期检查，阶段复盘，持续改进，自我驱动，这一切都是基于客观、负责的态度。</p><ul><li>OKR是有数据驱动的</li><li>定期检查、目标评分和持续的重新评估可以让OKR充满生机</li><li>所有这一切都是基于客观、负责的精神。</li><li>危险的关键结果会引发某些行动，应使其回到正轨，或者在必要时对其进行修改或替换。</li></ul><blockquote><p>研究表明，<strong>取得可量化的进步相比公众的认可、金钱刺激或实现目标本身，对人更有驱动力。</strong> 《驱动力》一书的作者丹尼尔·平克（Daniel Pink）非常认同这一观点，他说：“对个体来说，最大的激励因素是‘在工作中取得进步’。人们取得进步的时候是他们感到最积极、最投入的时候。”</p></blockquote><h3 id="挑战充分延展进而挑战不可能"><a class="markdownIt-Anchor" href="#挑战充分延展进而挑战不可能"></a> 挑战：充分延展进而挑战不可能</h3><p>允许失败，不作为考核依据，挑战更多“不可能”，释放出无限创造力。</p><ul><li>OKR激励我们不断超越之前设定的各种可能，甚至超出我们想象力。</li><li>通过挑战极限和允许失败，OKR能够促使我们释放出最具创造力的雄心和自我。</li></ul><blockquote><p>埃德温·洛克被誉为结构化目标设定理论之父，他对目标的难易程度与实现程度之间的关系进行了大量实验和实证研究。尽管研究的范围和领域很广泛，但研究结果却出奇一致。洛克写道：“<strong>目标设定越具有挑战性，所产生的结果越佳。虽然高难度的目标与其产出结果之间的差距，通常会大于低难度目标与其产出结果之间的差距，但是前者达到的最终结果仍然比后者要好。</strong> ”研究结果显示，设定具有挑战性目标的员工，不仅会取得更好的绩效，还会提高自我驱动力，以及对工作的投入程度。洛克指出：“<strong>设定明确而有挑战性的目标不仅可以提高工作的趣味性，同时也可以帮助人们体会到工作带来的愉悦感。</strong>  ”</p></blockquote>]]>
    </content>
    <id>https://v2grad.com/2022/02/18/reading-okr/</id>
    <link href="https://v2grad.com/2022/02/18/reading-okr/"/>
    <published>2022-02-18T02:00:00.000Z</published>
    <summary>为了系统的学习OKR理论，研读了《这就是OKR｜让谷歌、亚马逊实现爆炸性增长的工作法》和《OKR工作法｜谷歌、领英等顶级公司的高绩效秘籍》这两本书，总结了OKR的概念、实施步骤以及四大利器。拥抱OKR，拥抱先进生产力工具，做最重要的事情，挑战更多“不可能”。</summary>
    <title>《这就是OKR》和《ORK工作法》读书笔记</title>
    <updated>2022-02-17T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="机器学习" scheme="https://v2grad.com/categories/machinelearning/"/>
    <category term="强化学习" scheme="https://v2grad.com/tags/%E5%BC%BA%E5%8C%96%E5%AD%A6%E4%B9%A0/"/>
    <content>
      <![CDATA[<h2 id="强化学习"><a class="markdownIt-Anchor" href="#强化学习"></a> 强化学习</h2><h3 id="概念定义"><a class="markdownIt-Anchor" href="#概念定义"></a> 概念定义</h3><p>强化学习（Reinforcement learning，RL）讨论的问题是一个<strong>智能体(agent)</strong> 怎么在一个复杂不确定的 <strong>环境(environment)</strong> 里面去极大化它能获得的奖励。通过感知所处环境的 <strong>状态(state)</strong> 对 <strong>动作(action)</strong> 的 <strong>反应(reward)</strong>， 来指导更好的动作，从而获得最大的 <strong>收益(return)</strong>，这被称为在交互中学习，这样的学习方法就被称作强化学习。</p><blockquote><p>Reinforcement learning is learning what to do—how to map situations to actions——so as to maximize a numerical reward signal.<br />----- Richard S. Sutton and Andrew G. Barto 《Reinforcement Learning: An Introduction II》</p></blockquote><p><img src="https://static.v2grad.com/img/202202061348504.png" alt="强化学习" /><br />在强化学习过程中，智能体跟环境一直在交互。智能体在环境里面获取到状态，智能体会利用这个状态输出一个动作，一个决策。然后这个决策会放到环境之中去，环境会根据智能体采取的决策，输出下一个状态以及当前的这个决策得到的奖励。智能体的目的就是为了尽可能多地从环境中获取奖励。</p><p><img src="https://static.v2grad.com/img/202202080608917.png" alt="强化学习，监督学习，非监督学习" /><br />强化学习是除了监督学习和非监督学习之外的第三种基本的机器学习方法。</p><ul><li><strong>监督学习</strong> 是从外部监督者提供的带标注训练集中进行学习。 <strong>(任务驱动型)</strong></li><li><strong>非监督学习</strong> 是一个典型的寻找未标注数据中隐含结构的过程。 <strong>(数据驱动型)</strong></li><li><strong>强化学习</strong> 更偏重于智能体与环境的交互， 这带来了一个独有的挑战 ——“<strong>试错（exploration）</strong>”与“<strong>开发（exploitation）</strong>”之间的折中权衡，智能体必须开发已有的经验来获取收益，同时也要进行试探，使得未来可以获得更好的动作选择空间。 <strong>(从错误中学习)</strong></li></ul><p>强化学习主要有以下几个特点：</p><ul><li><strong>试错学习</strong>：强化学习一般没有直接的指导信息，Agent 要以不断与 Environment 进行交互，通过试错的方式来获得最佳策略(Policy)。</li><li><strong>延迟回报</strong>：强化学习的指导信息很少，而且往往是在事后（最后一个状态(State)）才给出的。比如 围棋中只有到了最后才能知道胜负。</li></ul><h3 id="基本元素"><a class="markdownIt-Anchor" href="#基本元素"></a> 基本元素</h3><p><img src="https://static.v2grad.com/img/202202080614963.png" alt="强化学习的两部分和三要素" /></p><ul><li><strong>环境(Environment)</strong> 是一个外部系统，智能体处于这个系统中，能够感知到这个系统并且能够基于感知到的状态做出一定的行动。</li><li><strong>智能体(Agent)</strong> 是一个嵌入到环境中的系统，能够通过采取行动来改变环境的状态。</li><li><strong>状态(State)/观察值(Observation)</strong>：状态是对世界的完整描述，不会隐藏世界的信息。观测是对状态的部分描述，可能会遗漏一些信息。</li><li><strong>动作(Action)</strong>：不同的环境允许不同种类的动作，在给定的环境中，有效动作的集合经常被称为动作空间(action space)，包括离散动作空间(discrete action spaces)和连续动作空间(continuous action spaces)，例如，走迷宫机器人如果只有东南西北这 4 种移动方式，则其为离散动作空间;如果机器人向 360◦ 中的任意角度都可以移动，则为连续动作空间。</li><li><strong>奖励(Reward)</strong>：是由环境给的一个标量的反馈信号(scalar feedback signal)，这个信号显示了智能体在某一步采 取了某个策略的表现如何。</li></ul><p><img src="https://static.v2grad.com/img/202202071625676.png" alt="强化学习范例" /></p><table><thead><tr><th>名称</th><th>对应上图中的内容</th></tr></thead><tbody><tr><td>agent</td><td>鸟</td></tr><tr><td>environment</td><td>鸟周围的环境，水管、天空（包括小鸟本身）</td></tr><tr><td>state</td><td>拍个照（目前的像素）</td></tr><tr><td>action</td><td>向上向下动作</td></tr><tr><td>reward</td><td>距离（越远奖励越高）</td></tr></tbody></table><h3 id="应用场景"><a class="markdownIt-Anchor" href="#应用场景"></a> 应用场景</h3><p><img src="https://static.v2grad.com/img/202202091739796.png" alt="强化学习应用" /></p><p><strong>游戏</strong><br /><img src="https://static.v2grad.com/img/202202080904190.png" alt="强化学习游戏领域的应用" /><br /><img src="https://static.v2grad.com/img/202202080905180.png" alt="强化学习游戏领域的应用" /></p><p><strong>机器人</strong><br /><img src="https://static.v2grad.com/img/202202080906945.png" alt="强化学习机器人领域的应用" /></p><table><thead><tr><th>名称</th><th>对应上图中的内容</th></tr></thead><tbody><tr><td>agent</td><td>策略-保持机器人平衡并行走</td></tr><tr><td>environment</td><td>机器人、地面、外部干扰</td></tr><tr><td>state</td><td>传感器采集的信号</td></tr><tr><td>action</td><td>作用在机器人各个关节的电机扭矩</td></tr><tr><td>reward</td><td>评估控制性能的数值信号</td></tr></tbody></table><p><strong>推荐广告</strong><br /><img src="https://static.v2grad.com/img/202202080906718.png" alt="强化学习在推荐中的应用" /><br />A Reinforcement Learning Framework for Explainable Recommendation</p><p><img src="https://static.v2grad.com/img/202202080926942.png" alt="强化学习在广告中的应用" /><br />Deep Reinforcement Learning for Online Advertising in Recommender Systems.<br />同时解决三个任务：是否插入广告；如果插入，插入哪一条广告；以及插入广告在推荐列表的哪个位置。</p><h3 id="相关术语"><a class="markdownIt-Anchor" href="#相关术语"></a> 相关术语</h3><p><strong>策略(Policy)</strong><br />策略是智能体用于决定下一步执行什么行动的规则。可以是确定性的，一般表示为：<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>μ</mi></mrow><annotation encoding="application/x-tex">\mu</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord mathdefault">μ</span></span></span></span>:</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>a</mi><mi>t</mi></msub><mo>=</mo><mi>μ</mi><mo stretchy="false">(</mo><msub><mi>s</mi><mi>t</mi></msub><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">a_t = \mu(s_t)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">a</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord mathdefault">μ</span><span class="mopen">(</span><span class="mord"><span class="mord mathdefault">s</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose">)</span></span></span></span></span></p><p>也可以是随机的，一般表示为 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>π</mi></mrow><annotation encoding="application/x-tex">\pi</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.43056em;vertical-align:0em;"></span><span class="mord mathdefault" style="margin-right:0.03588em;">π</span></span></span></span>:</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>a</mi><mi>t</mi></msub><mo>∼</mo><mi>π</mi><mo stretchy="false">(</mo><mo>⋅</mo><mi mathvariant="normal">∣</mi><msub><mi>s</mi><mi>t</mi></msub><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">a_t \sim \pi(\cdot | s_t)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">a</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">∼</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord mathdefault" style="margin-right:0.03588em;">π</span><span class="mopen">(</span><span class="mord">⋅</span><span class="mord">∣</span><span class="mord"><span class="mord mathdefault">s</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose">)</span></span></span></span></span></p><p><strong>状态转移(State Transition)</strong><br />状态转移，可以是确定的也可以是随机的，一般认为是随机的，其随机性来源于环境。可以用状态密度函数来表示：</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>p</mi><mrow><mo fence="true">(</mo><msup><mi>s</mi><mo mathvariant="normal">′</mo></msup><mo>∣</mo><mi>s</mi><mo separator="true">,</mo><mi>a</mi><mo fence="true">)</mo></mrow><mo>=</mo><mi mathvariant="double-struck">P</mi><mrow><mo fence="true">(</mo><msup><mi>S</mi><mo mathvariant="normal">′</mo></msup><mo>=</mo><msup><mi>s</mi><mo mathvariant="normal">′</mo></msup><mo>∣</mo><mi>S</mi><mo>=</mo><mi>s</mi><mo separator="true">,</mo><mi>A</mi><mo>=</mo><mi>a</mi><mo fence="true">)</mo></mrow></mrow><annotation encoding="application/x-tex">p\left(s^{\prime} \mid s, a\right)=\mathbb{P}\left(S^{\prime}=s^{\prime} \mid S=s, A=a\right)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1.051892em;vertical-align:-0.25em;"></span><span class="mord mathdefault">p</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathdefault">s</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.801892em;"><span style="top:-3.113em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">′</span></span></span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">∣</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord mathdefault">s</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord mathdefault">a</span><span class="mclose delimcenter" style="top:0em;">)</span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.051892em;vertical-align:-0.25em;"></span><span class="mord"><span class="mord mathbb">P</span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathdefault" style="margin-right:0.05764em;">S</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.801892em;"><span style="top:-3.113em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">′</span></span></span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord"><span class="mord mathdefault">s</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.801892em;"><span style="top:-3.113em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">′</span></span></span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">∣</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord mathdefault" style="margin-right:0.05764em;">S</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord mathdefault">s</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord mathdefault">A</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mord mathdefault">a</span><span class="mclose delimcenter" style="top:0em;">)</span></span></span></span></span></span></p><p>环境可能会变化，在当前环境和行动下，衡量系统状态向某一个状态转移的概率是多少，注意环境的变化通常是未知的。</p><p><strong>回报(Return)</strong><br />回报又称cumulated future reward，一般表示为<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>U</mi></mrow><annotation encoding="application/x-tex">U</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.68333em;vertical-align:0em;"></span><span class="mord mathdefault" style="margin-right:0.10903em;">U</span></span></span></span>，定义为</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>U</mi><mi>t</mi></msub><mo>=</mo><msub><mi>R</mi><mi>t</mi></msub><mo>+</mo><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>1</mn></mrow></msub><mo>+</mo><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>2</mn></mrow></msub><mo>+</mo><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>3</mn></mrow></msub><mo>+</mo><mo>⋯</mo></mrow><annotation encoding="application/x-tex">U_{t}=R_{t}+R_{t+1}+R_{t+2}+R_{t+3}+\cdots</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.10903em;">U</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:-0.10903em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.891661em;vertical-align:-0.208331em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">1</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.891661em;vertical-align:-0.208331em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.891661em;vertical-align:-0.208331em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">3</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.31em;vertical-align:0em;"></span><span class="minner">⋯</span></span></span></span></span></p><p>其中<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>R</mi><mi>t</mi></msub></mrow><annotation encoding="application/x-tex">R_{t}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>表示第t时刻的奖励，agent的目标就是让Return最大化。</p><p>未来的奖励不如现在等值的奖励那么好（比如一年后给100块不如现在就给），所以<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>1</mn></mrow></msub></mrow><annotation encoding="application/x-tex">R_{t+1}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.891661em;vertical-align:-0.208331em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">1</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span></span></span></span>的权重应该小于<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>R</mi><mi>t</mi></msub></mrow><annotation encoding="application/x-tex">R_t</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>。因此，强化学习通常用discounted return（折扣回报，又称cumulative discounted future reward），取<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>γ</mi></mrow><annotation encoding="application/x-tex">\gamma</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord mathdefault" style="margin-right:0.05556em;">γ</span></span></span></span>为discount rate（折扣率），<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>γ</mi><mo>∈</mo><mo stretchy="false">(</mo><mn>0</mn><mo separator="true">,</mo><mn>1</mn><mo stretchy="false">]</mo></mrow><annotation encoding="application/x-tex">\gamma\in(0, 1]</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.7335400000000001em;vertical-align:-0.19444em;"></span><span class="mord mathdefault" style="margin-right:0.05556em;">γ</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">∈</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mopen">(</span><span class="mord">0</span><span class="mpunct">,</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord">1</span><span class="mclose">]</span></span></span></span>，则有，</p><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>U</mi><mi>t</mi></msub><mo>=</mo><msub><mi>R</mi><mi>t</mi></msub><mo>+</mo><mi>γ</mi><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>1</mn></mrow></msub><mo>+</mo><msup><mi>γ</mi><mn>2</mn></msup><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>2</mn></mrow></msub><mo>+</mo><msup><mi>γ</mi><mn>3</mn></msup><msub><mi>R</mi><mrow><mi>t</mi><mo>+</mo><mn>3</mn></mrow></msub><mo>+</mo><mo>⋯</mo></mrow><annotation encoding="application/x-tex">U_{t}=R_{t}+\gamma R_{t+1}+\gamma^{2} R_{t+2}+\gamma^{3} R_{t+3}+\cdots</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.10903em;">U</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:-0.10903em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.891661em;vertical-align:-0.208331em;"></span><span class="mord mathdefault" style="margin-right:0.05556em;">γ</span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">1</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:1.072439em;vertical-align:-0.208331em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.05556em;">γ</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.8641079999999999em;"><span style="top:-3.113em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span></span></span></span></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">2</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:1.072439em;vertical-align:-0.208331em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.05556em;">γ</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.8641079999999999em;"><span style="top:-3.113em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">3</span></span></span></span></span></span></span></span></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.301108em;"><span style="top:-2.5500000000000003em;margin-left:-0.00773em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">t</span><span class="mbin mtight">+</span><span class="mord mtight">3</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.208331em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.31em;vertical-align:0em;"></span><span class="minner">⋯</span></span></span></span></span></p><p><strong>价值函数(Value Function)</strong><br />举例来说，在象棋游戏中，定义赢得游戏得1分，其他动作得0分，状态是棋盘上棋子的位置。仅从1分和0分这两个数值并不能知道智能体在游戏过程中到底下得怎么样，而通过价值函数则可以获得更多洞察。</p><p>价值函数使用期望对未来的收益进行预测，一方面不必等待未来的收益实际发生就可以获知当前状态的好坏，另一方面通过期望汇总了未来各种可能的收益情况。使用价值函数可以很方便地评价不同策略的好坏。</p><p><img src="https://static.v2grad.com/img/202202071857303.png" alt="价值函数" /></p><ul><li>状态价值函数(State-value Function)：用来度量给定策略<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>π</mi></mrow><annotation encoding="application/x-tex">\pi</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.43056em;vertical-align:0em;"></span><span class="mord mathdefault" style="margin-right:0.03588em;">π</span></span></span></span>的情况下，当前状态<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>s</mi><mi>t</mi></msub></mrow><annotation encoding="application/x-tex">s_t</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">s</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>的好坏程度。</li><li>动作价值函数(Action-value Function)：用来度量给定状态<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>s</mi><mi>t</mi></msub></mrow><annotation encoding="application/x-tex">s_t</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">s</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>和策略<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>π</mi></mrow><annotation encoding="application/x-tex">\pi</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.43056em;vertical-align:0em;"></span><span class="mord mathdefault" style="margin-right:0.03588em;">π</span></span></span></span>的情况下，采用动作<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>a</mi><mi>t</mi></msub></mrow><annotation encoding="application/x-tex">a_t</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.58056em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault">a</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.2805559999999999em;"><span style="top:-2.5500000000000003em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">t</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>的好坏程度。</li></ul><h3 id="算法分类"><a class="markdownIt-Anchor" href="#算法分类"></a> 算法分类</h3><p><img src="https://static.v2grad.com/img/202202071919418.png" alt="强化学习算法的分类" /><br /><strong>按照环境是否已知划分：免模型学习（Model-Free） vs 有模型学习（Model-Based）</strong></p><ul><li><strong>Model-free</strong>就是不去学习和理解环境，环境给出什么信息就是什么信息，常见的方法有policy optimization和Q-learning。</li><li><strong>Model-Based</strong>是去学习和理解环境，学会用一个模型来模拟环境，通过模拟的环境来得到反馈。Model-Based相当于比Model-Free多了模拟环境这个环节，通过模拟环境预判接下来会发生的所有情况，然后选择最佳的情况。</li></ul><blockquote><p>一般情况下，环境都是不可知的，所以这里主要研究无模型问题。</p></blockquote><p><strong>按照学习方式划分：在线策略（On-Policy） vs 离线策略（Off-Policy）</strong></p><ul><li><strong>On-Policy</strong>是指agent必须本人在场， 并且一定是本人边玩边学习。典型的算法为Sarsa。</li><li><strong>Off-Policy</strong>是指agent可以选择自己玩， 也可以选择看着别人玩， 通过看别人玩来学习别人的行为准则， 离线学习同样是从过往的经验中学习， 但是这些过往的经历没必要是自己的经历， 任何人的经历都能被学习，也没有必要是边玩边学习，玩和学习的时间可以不同步。典型的方法是Q-learning，以及Deep-Q-Network。</li></ul><p><strong>按照学习目标划分：基于策略（Policy-Based）和基于价值（Value-Based）。</strong><br /><img src="https://static.v2grad.com/img/202202081103918.png" alt="基于策略VS基于价值" /></p><ul><li><strong>Policy-Based</strong>的方法直接输出下一步动作的概率，根据概率来选取动作。但不一定概率最高就会选择该动作，还是会从整体进行考虑。适用于非连续和连续的动作。常见的方法有Policy gradients。</li><li><strong>Value-Based</strong>的方法输出的是动作的价值，选择价值最高的动作。适用于非连续的动作。常见的方法有Q-learning、Deep Q Network和Sarsa。</li><li>更为厉害的方法是二者的结合：Actor-Critic，Actor根据概率做出动作，Critic根据动作给出价值，从而加速学习过程，常见的有A2C，A3C，DDPG等。</li></ul><h3 id="经典算法"><a class="markdownIt-Anchor" href="#经典算法"></a> 经典算法</h3><p>经典算法：Q-learning，Sarsa，DQN，Policy Gradient，A3C，DDPG，PPO</p><table><thead><tr><th>学习方法</th><th>说明</th><th>经典算法</th></tr></thead><tbody><tr><td>基于价值(Value-Based)</td><td>通过价值选行为</td><td>Q Learning， Sarsa， Deep Q Network</td></tr><tr><td>基于策略(Policy-Based)</td><td>直接选最佳行为</td><td>Policy Gradients</td></tr><tr><td>基于模型(Model-Based)</td><td>想象环境并从中学习</td><td>Model based RL</td></tr></tbody></table><p><img src="https://static.v2grad.com/img/202202081412652.png" alt="Value-Based &amp; Policy-Based &amp; Actor Critic" /></p><p>下面我们挑选一些有代表性的算法进行讲解：</p><ul><li>基于表格、没有神经网络参与的Q-Learning算法</li><li>基于价值(Value-Based)的Deep Q Network（DQN）算法</li><li>基于策略(Policy-Based)的Policy Gradient（PG）算法</li><li>结合了Value-Based和Policy-Based的Actor Critic算法。</li></ul><h2 id="q-learning"><a class="markdownIt-Anchor" href="#q-learning"></a> Q-Learning</h2><p>在Q-learning中，我们维护一张Q值表，表的维数为：状态数S * 动作数A，表中每个数代表在当前状态S下可以采用动作A可以获得的未来收益的折现和。我们不断的迭代我们的Q值表使其最终收敛，然后根据Q值表我们就可以在每个状态下选取一个最优策略。</p><p><img src="https://static.v2grad.com/img/202202081001064.png" alt="Q-Learning场景范例" /><br />假设机器人必须越过迷宫并到达终点。有地雷，机器人一次只能移动一个地砖。如果机器人踏上地雷，机器人就死了。机器人必须在尽可能短的时间内到达终点。<br />得分/奖励系统如下：</p><ul><li>机器人在每一步都失去1点。这样做是为了使机器人采用最短路径并尽可能快地到达目标。</li><li>如果机器人踩到地雷，则点损失为100并且游戏结束。</li><li>如果机器人获得动力⚡️，它会获得1点。</li><li>如果机器人达到最终目标，则机器人获得100分。<br />现在，显而易见的问题是：我们如何训练机器人以最短的路径到达最终目标而不踩矿井？</li></ul><h3 id="q值表"><a class="markdownIt-Anchor" href="#q值表"></a> Q值表</h3><p>Q值表(Q-Table)是一个简单查找表的名称，我们计算每个状态的最大预期未来奖励。基本上，这张表将指导我们在每个状态采取最佳行动。<br /><img src="https://static.v2grad.com/img/202202081003156.png" alt="Q-Table" /></p><h3 id="q函数"><a class="markdownIt-Anchor" href="#q函数"></a> Q函数</h3><p>Q函数(Q-Function)即为上文提到的动作价值函数，他有两个输入：「状态」和「动作」。它将返回在该状态下执行该动作的未来奖励期望。<br /><img src="https://static.v2grad.com/img/202202081018874.png" alt="Q函数" /></p><p>我们可以把Q函数视为一个在Q-Table上滚动的读取器，用于寻找与当前状态关联的行以及与动作关联的列。它会从相匹配的单元格中返回 Q 值。这就是未来奖励的期望。<br /><img src="https://static.v2grad.com/img/202202081020345.png" alt="Q函数" /><br />在我们探索环境（environment）之前，Q-table 会给出相同的任意的设定值（大多数情况下是 0）。随着对环境的持续探索，这个 Q-table 会通过迭代地使用 Bellman 方程（动态规划方程）更新 Q(s，a) 来给出越来越好的近似。</p><h3 id="算法流程"><a class="markdownIt-Anchor" href="#算法流程"></a> 算法流程</h3><p><img src="https://static.v2grad.com/img/202202081004537.png" alt="Q-learning实现" /></p><p><img src="https://static.v2grad.com/img/202202081004219.png" alt="Q-learning的学习过程" /></p><p><strong>第1步：初始化Q值表</strong><br />我们将首先构建一个Q值表。有n列，其中n=操作数。有m行，其中m=状态数。我们将值初始化为0<br /><img src="https://static.v2grad.com/img/202202081005071.png" alt="初始化Q表" /></p><p><strong>步骤2和3：选择并执行操作</strong><br />这些步骤的组合在不确定的时间内完成。这意味着此步骤一直运行，直到我们停止训练，或者训练循环停止。<br /><img src="https://static.v2grad.com/img/202202081006986.png" alt="选择并执行操作" /></p><p>如果每个Q值都等于零，我们就需要权衡探索/利用（exploration/exploitation）的程度了，思路就是，在一开始，我们将使用 epsilon 贪婪策略：</p><ul><li>我们指定一个探索速率「epsilon」，一开始将它设定为 1。这个就是我们将随机采用的步长。在一开始，这个速率应该处于最大值，因为我们不知道 Q-table 中任何的值。这意味着，我们需要通过随机选择动作进行大量的探索。</li><li>生成一个随机数。如果这个数大于 epsilon，那么我们将会进行「利用」（这意味着我们在每一步利用已经知道的信息选择动作）。否则，我们将继续进行探索。</li><li>在刚开始训练 Q 函数时，我们必须有一个大的 epsilon。随着智能体对估算出的 Q 值更有把握，我们将逐渐减小 epsilon。</li></ul><p><img src="https://static.v2grad.com/img/202202081037361.png" alt="权衡探索和利用" /></p><p><strong>步骤4和5：评估</strong><br />现在我们采取了行动并观察了结果和奖励。我们需要更新功能Q（s，a）：<br /><img src="https://static.v2grad.com/img/202202081024769.png" alt="更新Q表" /></p><p>最后生成的Q表：<br /><img src="https://static.v2grad.com/img/202202081011238.png" alt="生成的Q表" /></p><h2 id="deep-q-network"><a class="markdownIt-Anchor" href="#deep-q-network"></a> Deep Q Network</h2><p>在普通的Q-learning中，当状态和动作空间是离散且维数不高时可使用Q-Table储存每个状态动作对的Q值，而当状态和动作空间是高维连续时，使用Q-Table不现实，我们无法构建可以存储超大状态空间的Q_table。不过，在机器学习中， 有一种方法对这种事情很在行，那就是神经网络，可以将状态和动作当成神经网络的输入，然后经过神经网络分析后得到动作的 Q 值，这样就没必要在表格中记录 Q 值，而是直接使用神经网络预测Q值<br /><img src="https://static.v2grad.com/img/202202081012123.png" alt="Deep Q Network" /></p><h3 id="经验回放"><a class="markdownIt-Anchor" href="#经验回放"></a> 经验回放</h3><p>DQN利用Qlearning特点，目标策略与动作策略分离，学习时利用经验池储存的经验取batch更新Q。同时提高了样本的利用率，也打乱了样本状态相关性使其符合神经网络的使用特点。</p><h3 id="固定q目标"><a class="markdownIt-Anchor" href="#固定q目标"></a> 固定Q目标</h3><p>神经网络一般学习的是固定的目标，而Qlearning中Q同样为学习的变化量，变动太大不利于学习。所以DQN使Q在一段时间内保持不变，使神经网络更易于学习。</p><h3 id="算法流程-2"><a class="markdownIt-Anchor" href="#算法流程-2"></a> 算法流程</h3><p><img src="https://static.v2grad.com/img/202202081335646.png" alt="DQN算法流程" /></p><h3 id="主要问题"><a class="markdownIt-Anchor" href="#主要问题"></a> 主要问题</h3><ul><li>在估计值函数的时候一个任意小的变化可能导致对应动作被选择或者不被选择，这种不连续的变化是致使基于值函数的方法无法得到收敛保证的重要因素。</li><li>选择最大的Q值这样一个搜索过程在高纬度或者连续空间是非常困难的；</li><li>无法学习到随机策略，有些情况下随机策略往往是最优策略。</li></ul><h2 id="policy-gradient"><a class="markdownIt-Anchor" href="#policy-gradient"></a> Policy Gradient</h2><p>前面我们介绍的Q-Learning和DQN都是基于价值的强化学习算法，在给定一个状态下，计算采取每个动作的价值，我们选择有最高Q值（在所有状态下最大的期望奖励）的行动。如果我们省略中间的步骤，即直接根据当前的状态来选择动作，也就引出了强化学习中的另一种很重要的算法，即策略梯度(Policy Gradient， PG)</p><p>策略梯度不通过误差反向传播，它通过观测信息选出一个行为直接进行反向传播，当然出人意料的是他并没有误差，而是利用reward奖励直接对选择行为的可能性进行增强和减弱，好的行为会被增加下一次被选中的概率，不好的行为会被减弱下次被选中的概率。</p><p>举例如下图所示：输入当前的状态，输出action的概率分布，选择概率最大的一个action作为要执行的操作。<br /><img src="https://static.v2grad.com/img/202202081608856.png" alt="Policy Gradient" /></p><h3 id="优缺点"><a class="markdownIt-Anchor" href="#优缺点"></a> 优缺点</h3><p><strong>优点</strong></p><ul><li>连续的动作空间（或者高维空间）中更加高效；</li><li>可以实现随机化的策略；</li><li>某种情况下，价值函数可能比较难以计算，而策略函数较容易。</li></ul><p><strong>缺点</strong></p><ul><li>通常收敛到局部最优而非全局最优</li><li>评估一个策略通常低效（这个过程可能慢，但是具有更高的可变性，其中也会出现很多并不有效的尝试，而且方差高）</li></ul><h3 id="reinforce"><a class="markdownIt-Anchor" href="#reinforce"></a> REINFORCE</h3><p>蒙特卡罗策略梯度reinforce算法是策略梯度最简单的也是最经典的一个算法。<br /><img src="https://static.v2grad.com/img/202202081616628.png" alt="REINFORCE算法流程" /></p><h3 id="算法流程-3"><a class="markdownIt-Anchor" href="#算法流程-3"></a> 算法流程</h3><p><img src="https://static.v2grad.com/img/202202081645188.png" alt="REINFORCE流程图" /><br />首先我们需要一个 policy model 来输出动作概率，输出动作概率后，我们用 sample() 函数去得到一个具体的动作，然后跟环境交互过后，我们可以得到一整个回合的数据。拿到回合数据之后，我再去执行一下 learn() 函数，在 learn() 函数里面，我就可以拿这些数据去构造损失函数，扔给这个优化器去优化，去更新我的 policy model。</p><h2 id="actor-critic"><a class="markdownIt-Anchor" href="#actor-critic"></a> Actor Critic</h2><p>演员-评论家算法(Actor-Critic)是基于策略(Policy Based)和基于价值(Value Based)相结合的方法</p><p><img src="https://static.v2grad.com/img/202202091122103.png" alt="演员-评论家算法" /></p><ul><li>演员(Actor)是指策略函数 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>π</mi><mi>θ</mi></msub><mo stretchy="false">(</mo><mi>a</mi><mi mathvariant="normal">∣</mi><mi>s</mi><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">\pi_{\theta}(a|s)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">π</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.33610799999999996em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.02778em;">θ</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mopen">(</span><span class="mord mathdefault">a</span><span class="mord">∣</span><span class="mord mathdefault">s</span><span class="mclose">)</span></span></span></span>，即学习一个策略来得到尽量高的回报。</li><li>评论家(Critic)是指值函数 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><msup><mi>V</mi><mi>π</mi></msup><mo stretchy="false">(</mo><mi>s</mi><mo stretchy="false">)</mo></mrow><annotation encoding="application/x-tex">V^{\pi}(s)</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1em;vertical-align:-0.25em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.22222em;">V</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.664392em;"><span style="top:-3.063em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.03588em;">π</span></span></span></span></span></span></span></span></span><span class="mopen">(</span><span class="mord mathdefault">s</span><span class="mclose">)</span></span></span></span>，对当前策略的值函数进行估计，即评估演员的好坏。</li><li>借助于价值函数，演员-评论家算法可以进行单步更新参数，不需要等到回合结束才进行更新。</li></ul><h3 id="网络结构"><a class="markdownIt-Anchor" href="#网络结构"></a> 网络结构</h3><p>整体结构：<br /><img src="https://static.v2grad.com/img/202202091127132.png" alt="演员-评论家网络结构" /></p><p>Actor和Critic的网络结构：<br /><img src="https://static.v2grad.com/img/202202091128295.png" alt="Actor Critic network " /></p><h3 id="算法流程-4"><a class="markdownIt-Anchor" href="#算法流程-4"></a> 算法流程</h3><p><img src="https://static.v2grad.com/img/202202091125622.png" alt="Actor Critic Algorithm" /></p><h3 id="问题和改进"><a class="markdownIt-Anchor" href="#问题和改进"></a> 问题和改进</h3><p>Actor Critic 取决于 Critic 的价值判断， 但是 Critic 难收敛， 再加上 Actor 的更新， 就更难收敛，为了解决该问题又提出了 A3C 算法和 DDPG 算法。</p><p><strong>改进算法1：A3C</strong><br />异步的优势行动者评论家算法（Asynchronous Advantage Actor-Critic，A3C），相比Actor-Critic，A3C的优化主要有3点，分别是异步训练框架，网络结构优化，Critic评估点的优化。其中异步训练框架是最大的优化。</p><p><img src="https://static.v2grad.com/img/202202091452021.png" alt="A3C" /></p><p><strong>改进算法2：DDPG</strong><br />深度确定性策略梯度(Deep Deterministic Policy Gradient，DDPG)，从DDPG这个名字看，它是由D（Deep）+D（Deterministic ）+ PG(Policy Gradient)组成。</p><ul><li>Deep 是因为用了神经网络；</li><li>Deterministic 表示 DDPG 输出的是一个确定性的动作，可以用于连续动作的一个环境；</li><li>Policy Gradient 代表的是它用到的是策略网络。REINFORCE 算法每隔一个 episode 就更新一次，但 DDPG 网络是每个 step 都会更新一次 policy 网络，也就是说它是一个单步更新的 policy 网络。</li></ul><p><img src="https://static.v2grad.com/img/202202091454219.png" alt="DDPG" /></p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://spinningup.readthedocs.io/zh_CN/latest/spinningup/rl_intro.html">强化学习介绍 / OpenAI Spinning Up</a></li><li><a href="https://datawhalechina.github.io/easy-rl/#/">EasyRL / datawhalechina</a></li><li><a href="https://www.cnblogs.com/pinard/category/1254674.html">0084. 强化学习(19) / 刘建平Pinard / cnblogs</a></li><li><a href="https://github.com/wangshusen/DRL">Deep Reinforcement Learning / wangshusen</a></li><li><a href="https://mofanpy.com/tutorials/machine-learning/reinforcement-learning/">强化学习Reinforcement Learning / 莫烦Python</a></li><li><a href="https://www.davidsilver.uk/teaching/">UCL Course on RL / David Silver / 2015</a></li><li><a href="https://arxiv.org/pdf/1312.5602.pdf">Playing Atari with Deep Reinforcement Learning / David Silver / 2013</a></li><li><a href="https://web.stanford.edu/class/psych209/Readings/MnihEtAlHassibis15NatureControlDeepRL.pdf">Human-level control through deep reinforcement learning / David Silver / 2015</a></li><li><a href="https://blog.csdn.net/xz15873139854/article/details/108032932">一图看懂DQN(Deep Q-Network)深度强化学习算法 / 薄荷-塘</a></li><li><a href="https://proceedings.neurips.cc/paper/1999/file/464d828b85b0bed98e80ade0a5c43b0f-Paper.pdf"> Policy gradient methods for reinforcement learning with function approximation.<br /></a></li><li><a href="https://zhuanlan.zhihu.com/p/36494307">强化学习——策略梯度与Actor-Critic算法 / 野风 / 知乎</a></li><li><a href="http://proceedings.mlr.press/v48/mniha16.pdf">Asynchronous Methods for Deep Reinforcement Learning / Google DeepMind / A3C</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2022/02/10/reinforcement-learning/</id>
    <link href="https://v2grad.com/2022/02/10/reinforcement-learning/"/>
    <published>2022-02-10T14:00:00.000Z</published>
    <summary>介绍强化学习的概念定义、基本思想、分类和应用场景，讲解强化学习中的经典算法：基于表格的Q-Learning算法、基于价值的Deep Q Network、基于策略的Policy Gradient以及结合了Value-Based和Policy-Based的Actor Critic算法。</summary>
    <title>强化学习入门：基本思想和经典算法</title>
    <updated>2022-02-10T14:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="读书笔记" scheme="https://v2grad.com/categories/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="读书笔记" scheme="https://v2grad.com/tags/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <content>
      <![CDATA[<p>Naval Ravikant为大家所熟知是他成功创立了帮助初创公司融资的平台AngelList，同时他是优步和Twitter的早期投资人。他有一个很有名的长推特，叫做<a href="https://twitter.com/naval/status/1002103360646823936">《如何致富，不靠运气》</a>，谈了他的商业观，在网上引起了很多共鸣，被翻译成多国语言。</p><p>我读完以后，从<strong>财富认知、个人成长和个人选择</strong>总结了我从中学到的东西。</p><p><img src="https://static.v2grad.com/img/202201181418987.png" alt="如何不靠运气变得富有" /></p><h2 id="财富认知"><a class="markdownIt-Anchor" href="#财富认知"></a> 财富认知</h2><h3 id="追求财富"><a class="markdownIt-Anchor" href="#追求财富"></a> 追求财富</h3><blockquote><p>Seek wealth, not money or status. Wealth is having assets that earn while you sleep. Money is how we transfer time and wealth. Status is your place in the social hierarchy.</p></blockquote><p><strong>去寻求财富，而非金钱或地位</strong>。财富就是你拥有资产，而资产在你睡觉的时候都还在为你赚钱；金钱是我们转换时间和财富的工具；身份是你在社会等级体系里所处的位置。</p><ul><li><strong>财富</strong>是一个正和游戏,世界上每个人都可以拥有一所房子，你有房子并不会影响我有房子的能力。财富的终极目标是自由，财富是关于你如何成为你自己的事。</li><li><strong>金钱</strong>是社会信用，它是一种从别人的时间中获得信用和债务的能力。</li><li><strong>地位</strong>是一个零和游戏。这是一个非常古老的游戏。我们从原始人部落开始就玩这个游戏了。也就是等级制度。老大是谁？老二是谁？老三是谁？老三打败了老二，老二就必须让位。所以，地位是一个零和游戏。</li></ul><p>每个人都可以变得富有，每个人都可以退休，每个人都可以成功。这只是一个教育和欲望的问题。前提是你必须想要它。如果你不想要，没关系，没人强迫你参与游戏，但是不要试图贬低那些积极参与游戏的人。</p><h3 id="如何致富"><a class="markdownIt-Anchor" href="#如何致富"></a> 如何致富</h3><blockquote><p>You’re not going to get rich renting out your time. You must own equity — a piece of a business — to gain your financial freedom.</p></blockquote><p>出租时间不会让你变得富有，因为你不能非线性地赚钱，你必须拥有公司的股权，才能获得财务自由。</p><blockquote><p>You will get rich by giving society what it wants but does not yet know how to get. At scale.</p></blockquote><p>提供社会大众想要但是他们还不知道如何获取的东西，你就会因此而致富。但有一点：你必须规模化地供应社会。</p><ul><li>第一步：找到“个人-市场-产品”这三者交叉的那个定位。你问问自己，你的竞争力在哪里？市场需要的哪一种产品，可以用到你的这种竞争力？这就是你的定位。</li><li>第二步：使用各种杠杆（leverage），使得你的产品可以服务尽可能大的市场。</li></ul><p>赚大钱的奥秘就是<strong>定位</strong>和<strong>杠杆</strong>这两件事。当市场需要你的产品时，如果有办法&quot;放大&quot;产品，服务更多的人，你就成功了。</p><h3 id="慢慢变富"><a class="markdownIt-Anchor" href="#慢慢变富"></a> 慢慢变富</h3><blockquote><p>There are no get rich quick schemes. That’s just someone else getting rich off you.</p></blockquote><p>这个世界上并没有快速赚钱致富的方法，如果你想要找寻这种方法，那它只会让别人从你身上赚钱致富。</p><ul><li>财富不是一步登天，它是一点点堆积起来的。</li><li>致富与运气无关，要掌握致富的技能，而且每个人都可以拥有这种技能。</li><li>学会如何销售，学会如何创建。如果你同时能做到这两件事，你的成功将无可阻挡。硅谷模式：建造者+销售者=最佳拍档</li></ul><p><img src="https://static.v2grad.com/img/202201181519859.png" alt="Naval Ravikant" /></p><h2 id="个人成长"><a class="markdownIt-Anchor" href="#个人成长"></a> 个人成长</h2><blockquote><p><strong>Arm yourself with specific knowledge, accountability, and leverage.</strong></p></blockquote><p>用独到知识，责任感和杠杆武装自己。</p><h3 id="独到知识specific-knowledge"><a class="markdownIt-Anchor" href="#独到知识specific-knowledge"></a> 独到知识（specific knowledge）</h3><blockquote><p>Specific knowledge is knowledge that you cannot be trained for. If society can train you, it can train someone else, and replace you.</p></blockquote><p>独到知识是那种不可以通过培训而获得的知识。这是因为，如果这种知识可以经由培训而得，那么其他人同样也可以，并且以此取代你。你获得的收入=投资培训所产生的回报-培训你的成本。</p><ul><li>在真正的好奇心和热情驱使你前进的路上，你更有可能获得独到知识，而不是在追逐潮流热点的闻风起舞脚步里。</li><li>创建独到知识的过程对于你就像是在玩，而对于别人则像是工作。</li><li>不能通过学校教育教会一个人独到知识，它只能通过学徒制口传身教。</li><li>独到知识通常极富技术性和创造性，因此它不能被外包或自动实现。</li></ul><h3 id="承担责任accountability"><a class="markdownIt-Anchor" href="#承担责任accountability"></a> 承担责任（accountability）</h3><blockquote><p>Embrace accountability, and take business risks under your own name. Society will reward you with responsibility, equity, and leverage.</p></blockquote><p>拥抱责任感，押上自己的声誉以承担商业风险。社会也会以责任，产权和杠杆作为回报。</p><ul><li><strong>劳动者按小时计算薪酬，责任感少</strong>。假如你是一名建筑工人，你的工作是修理人们的房屋。有人在周围不断命令你，告诉你：”打破那块石头，磨碎那块木头，把那个东西放在什么什么地方。”。你是建筑工人中的一个不知名的齿轮，房子的主人或买主不知道也不关心你为之工作。</li><li><strong>总承包商获得权益，但他们也承担风险</strong>。10万美元来装修一栋房子，而实际上总承包商的成本，说来说去都是7万美元，那么承包商会把剩下的3万美元据为己有。他们得到了资产，但也承担了责任和风险。如果项目失败了，有了损失，他们就需要承受损失。但你看，责任感给了他们一些额外的潜在收入。</li></ul><p>最具责任感的人都具有独一无二的、世人皆知的、敢于冒险的个性特征，如奥普拉、川普、坎耶、埃隆。</p><h3 id="利用杠杆leverage"><a class="markdownIt-Anchor" href="#利用杠杆leverage"></a> 利用杠杆（leverage）</h3><blockquote><p>Fortunes require leverage. Business leverage comes from capital, people, and products with no marginal cost of replication (code and media).</p></blockquote><p>财富增长需要使用杠杆。商业杠杆有三个来源：1、资本；2、人力；3、复制起来边际成本为零的产品（如：代码和媒体）。</p><ul><li><strong>资本</strong>的意思就是钱。想要融资，那就运用你的独到知识，配合你责任感，展示出你良好的判断力。</li><li><strong>人力</strong>指的就是为你干活的人，它是最古老也是争夺最激烈的杠杆。人力杠杆会让你父母因为你手下有许多人为你工作而感到骄傲，但你不要浪费生命去追求这一点。</li><li><strong>代码和媒体</strong>是无需许可即可使用的杠杆。它们是新贵人群背后的杠杆，你可以通过自己创建的软件和媒体，在睡觉时仍然为你干活。</li></ul><p>对于劳动杠杆，必须有人决定跟随你。对于资本杠杆来说，必须有人给你钱，给你投资让你做产品。写代码、写书、录制播客、发推特、YouTubing，这些东西，都是无需权限的。你不需要任何人的许可就可以做这些事情，它们非常公平。</p><p><strong>杠杆能够成倍地放大你的判断力（所产生的效能）。</strong></p><p><strong>判断力需要经验，但它可以通过学习基本技能的方法更快速地建立起来。</strong></p><ul><li>阅读你所热爱的内容，直到你爱上阅读。</li><li>速食一百本书毫无意义。</li><li>学习的手段是丰富的，学习的欲望是稀缺的。</li><li>数学和逻辑是理解其他一切事物的基础。</li><li>没有所谓的商业技能，少读商业杂志和商业课程。</li><li>学习微观经济学、博弈论、心理学、说服力、伦理学、数学和计算机。</li><li>学习讲故事和编程。</li></ul><p><img src="https://static.v2grad.com/img/202201182108416.png" alt="Naval" /></p><h2 id="个人选择"><a class="markdownIt-Anchor" href="#个人选择"></a> 个人选择</h2><blockquote><p>Pick an industry where you can play long term games with long term people.</p></blockquote><p>选择一个你可以长期从事的产业，寻找一批可以一起长期共事的人。</p><h3 id="选择合作伙伴"><a class="markdownIt-Anchor" href="#选择合作伙伴"></a> 选择合作伙伴</h3><blockquote><p>Pick business partners with high intelligence, energy, and, above all, integrity.</p></blockquote><p>在选择商业合作伙伴的时候，选择那些<strong>高智商</strong>、<strong>精力旺盛</strong>的家伙，但在这一切之上，他应该是个<strong>正直诚实</strong>的人。</p><ul><li>不要和愤世嫉俗者和悲观主义者合作，因为他们会任由坏事发生，以此证明他们的负面看法是正确的。</li><li>与理性的乐观主义者合作，理性的意思是你必须看清世界的真相。但你必须对自己的能力保持乐观，对自己想要完成的使命保持乐观。</li></ul><h3 id="选择行业赛道"><a class="markdownIt-Anchor" href="#选择行业赛道"></a> 选择行业赛道</h3><blockquote><p>Play iterated games. All the returns in life, whether in wealth, relationships, or knowledge, come from compound interest.</p></blockquote><p>玩就玩复利游戏。无论是财富，人际关系或者是知识，所有你人生里获得的回报，都来自复利。</p><ul><li>选择一个你可以和长期伙伴玩长期游戏的行业，所有的回报都来自于多次游戏的复利。</li><li>在长期游戏中，似乎每个人都在让彼此更富有。而在短期游戏中，似乎每个人都在让自己更富有。</li></ul><p>复利是一种非常重要的力量，收益来自重复游戏的复利。</p><h3 id="选择生活方式"><a class="markdownIt-Anchor" href="#选择生活方式"></a> 选择生活方式</h3><blockquote><p>People busy upgrading their lifestyles just can’t fathom this freedom.People living below their means have freedom</p></blockquote><p>我们应该升级自己的自由，而不是生活方式。生活水平远低于其收入水平的人们享受着一种自由，这种自由是那些忙于改善生活方式的人们无法理解的</p><p>追求财富是因为它能给你带来自由，也就是说，你不必像白领那样一丝不苟地系领带；你不必早上6点就起床、996挤地铁上下班；你不必把时间浪费在一份没有灵魂，你不喜欢的工作上。而不是去买毛皮大衣，不是去开法拉利，不是去驾驶游艇，也不是去乘坐湾流飞机环游世界。那些东西很快就会变得无聊和愚蠢。</p><blockquote><p>健康的身体，平静的头脑，充满爱的家庭。这些东西是买不来的，必须要经营才能得到。</p></blockquote><p>即使你拥有世界上所有的钱，你也不会拥有这三样东西。Jeff Bezos（亚马逊董事长）还得健身，他也得为他的婚姻努力，他的内在精神状态仍然很难不被外部事件所影响。这将取决于他内心的平静与安宁。因此，我认为这三件事——你的身体健康，你的心理健康和你的亲密关系是你必须要培养的。他们能给你带来比任何金钱都多的安宁和幸福。</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://twitter.com/naval/status/1002103360646823936"> How to Get Rich (without getting lucky) / Naval / Tweetstrom </a></li><li><a href="https://nav.al/rich">《How to Get Rich》/ Naval / PodCast</a></li><li><a href="https://www.navalmanack.com/">《The Almanack of Naval Ravikant》/ Eric Jorgenson / Book</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2022/01/18/how-to-get-rich-without-getting-lucky/</id>
    <link href="https://v2grad.com/2022/01/18/how-to-get-rich-without-getting-lucky/"/>
    <published>2022-01-18T14:40:02.000Z</published>
    <summary>阅读了Naval的《如何不靠运气变得富有(How to Get Rich Without Getting Lucky)》以后很受启发，我从财富认知、个人成长和个人选择的角度总结了从中学到的东西。</summary>
    <title>《如何不靠运气变得富有》读后感</title>
    <updated>2026-11-13T09:01:05.227Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="思维精进" scheme="https://v2grad.com/categories/thinking/"/>
    <category term="年度演讲" scheme="https://v2grad.com/tags/%E5%B9%B4%E5%BA%A6%E6%BC%94%E8%AE%B2/"/>
    <content>
      <![CDATA[<h2 id="进化的力量"><a class="markdownIt-Anchor" href="#进化的力量"></a> 进化的力量</h2><p>刘润，中国著名商业顾问，润米咨询创始人，“5分钟商学院”主理人，微信公众号“刘润”主理人，微软（中国）有限公司前战略合作总监，曾任百度、海尔、中远国际、五源资本、康宝莱等，现任腾讯、恒基、尚景家居、云汉芯城等多家知名企业的战略顾问。</p><p><strong>商业进化和生物进化的底层逻辑是相通的</strong>：不是最强壮的，也不是最聪明的，而是最适合的才能生存。我们必须不断地进化，企业如此，个人也如此。</p><p>《进化的力量·刘润年度演讲》梳理2022年企业最需要关注的8个方面！帮助你看清世界的变化，不断进化。</p><p><img src="https://static.v2grad.com/img/202201091237196.png" alt="进化的力量思维导图" /></p><h2 id="达尔文雀"><a class="markdownIt-Anchor" href="#达尔文雀"></a> 达尔文雀</h2><p>厄瓜多尔的加拉帕戈斯群岛距离南美大陆约970公里，是一些由海底火山喷发形成的小岛。这些岛上生活着一群看起来不怎么起眼的鸟类，1835年，达尔文随皇家海军“贝格尔”号勘探船造访此地时，第一次采集到了这些鸟类的标本。因为在演化生物学研究领域声名显赫，这些外形各异的鸟类得到了“<strong>达尔文雀</strong>”（Darwin’s Finches）这一响亮的名称。传说，正是这些鸟儿启发了达尔文，让他领悟了演化理论的关键。</p><p><img src="https://static.v2grad.com/img/202201190703048.png" alt="进化论" /></p><h2 id="老龄化"><a class="markdownIt-Anchor" href="#老龄化"></a> 老龄化</h2><h3 id="现状"><a class="markdownIt-Anchor" href="#现状"></a> 现状</h3><p><strong>增速放缓</strong>(年平均增速：0.57%-&gt;0.53%)，<strong>男女均衡</strong>(出生人口性别比：118.1-&gt;111.3)，<strong>家庭缩小</strong>(户均人口：3.10-&gt;2.62)。这三组数据，是关于中国人的“<strong>生命</strong>”状态，能不能找到另一半，如何组成家庭。</p><p><strong>流动明显</strong>(人户分离人口：4.9亿,增长88.52%)，<strong>城乡转移</strong>(城镇人口：9.02亿；乡村人口：5.10亿)，<strong>人口聚集</strong>(东部：2.15% 西部：0.22%；中部：0.79%；东北：1.2%)。这三组数据，是关于“<strong>生活</strong>”，人们选择在哪里生活，靠什么生活，和谁一起生活。</p><p><strong>少子继续</strong>(总和生育率：1.3，意愿生育率：1.8)，<strong>老龄加深</strong>(60岁以上：2.64亿；65岁以上：1.91亿)，<strong>劳力减少</strong>(10.06亿-&gt;9.68亿)，<strong>素质提升</strong>(9.08年-&gt;9.91年)。这四组数据，是关于“<strong>生产</strong>”，有多少人需要工作，养活另外多少人，用什么方式。</p><p>每一年平均年龄增加三个月，我们这一代人大概率可以活到100岁。<br />中国在2000年，就已经进入轻度老龄化。预计在2022年进入深度老龄化时代，65岁以上人口占比13.5%。</p><h3 id="活力老人"><a class="markdownIt-Anchor" href="#活力老人"></a> 活力老人</h3><p>日本，1995年进入深度老龄化，26年了。或许可以是我们主要的研究对象。<br /><img src="https://static.v2grad.com/img/202201190723618.png" alt="日本应对老龄化的措施" /><br />关于少子化，试过生孩子就给钱啊，生孩子就放假啊，甚至海外移民计划。关于老龄化，试过延迟领取退休金啊，退休再就业啊。有些有效，有些效果不明显。在所有这些制度中，有一项制度，效果越来越突显。<br />这项制度就是：<strong>“活力老人”计划（Power Senior）</strong></p><p><strong>适合的岗位</strong>：专车司机，客服中心，银行柜员，空乘人员</p><p>活力老人的目的是提高生产率，让年轻人去做更有创造力的事情。</p><h3 id="科技创新"><a class="markdownIt-Anchor" href="#科技创新"></a> 科技创新</h3><p><strong>总财富 = 劳动力 * 生产率</strong>, 一个社会所能创造的总财富，等于劳动力总量，乘以每人所创造的财富。这个“每人所能创造的财富”，就是生产率。</p><p>劳动力不会高速增长了，要实现生产率的倍速增长，只能靠科技创新。</p><blockquote><p>最好的企业家拿到最先进的科学专利，找到最具行业洞察力和执行力能力的人一起合作，找到最好的协作企业共同开发。 – 王煜全 科技投资人</p></blockquote><p>所有理所当然的现在，都是曾经不可思议的未来，所有现在不可思议的未来，可能都是明天理所当然的现在。</p><h2 id="数字化"><a class="markdownIt-Anchor" href="#数字化"></a> 数字化</h2><p>销售数字告诉你：我想买什么，评论数据告诉你：什么在阻止我付钱</p><p><img src="https://static.v2grad.com/img/202201190728576.png" alt="数字化定义" /><br />数字化定义：从物理世界中，开采出数据，粗炼出信息，精炼出知识，聚合为智慧</p><h3 id="开采数据"><a class="markdownIt-Anchor" href="#开采数据"></a> 开采数据</h3><p>真正让iphone成功的，不是能让你感觉到他存在的东西；真正让iphone成功的，是让它能感知到你存在的东西。<br />你在感知这个世界的时候，这个世界也在感知你。</p><p><strong>隐私问题</strong></p><ul><li>Google读取邮件内容，可以在Google地图中查到酒店入住，可以直接帮你写好回复邮件。</li><li>隐私和便利性是相互冲突的</li><li>《个人信息保护法》11月1日实施。一个没有法律保护的市场，就是一个劣币驱逐良币的市场。</li></ul><h3 id="粗炼信息"><a class="markdownIt-Anchor" href="#粗炼信息"></a> 粗炼信息</h3><p>妈妈的味道，就是你小时候习惯了的味道。</p><p>粗炼：从数据到信息： 从金木水火土，到氢氦锂铍硼。</p><blockquote><p>牛肉的数字化：M1-M9， 钻石的数字化：4C标准</p></blockquote><p>牛肉、玉石、茶叶、沉香、古董。。。所有柠檬市场都值得用数字化重新做一遍。</p><p>这里主要指数据标准化的工作。</p><h3 id="精炼知识"><a class="markdownIt-Anchor" href="#精炼知识"></a> 精炼知识</h3><p>广告公司：用数字化的方式，把行业信息提炼为知识，提升广告效果。</p><p>企业办公：用数字化的方式，把组织信息提炼为知识，提升办公效率。</p><h3 id="聚合智慧"><a class="markdownIt-Anchor" href="#聚合智慧"></a> 聚合智慧</h3><blockquote><p>智慧，就是用更低的成本，做更好的决策。 – 信也科技创始人</p></blockquote><p>数字化 + 个人信息保护法 =  数字石油时代</p><h2 id="新消费"><a class="markdownIt-Anchor" href="#新消费"></a> 新消费</h2><p>体验 - 只要我喜欢，没有值不值<br /><img src="https://static.v2grad.com/img/202201190731100.png" alt="只要我喜欢，没有值不值" /><br />2021年中国人均GDP 1.21w美元，世界高收入标准是1.27w美元。</p><blockquote><p>2021年，我们站在了高收入的边界线上。 – 香帅 著名金融学者</p></blockquote><p>2001年，出口，中国外贸跑赢GDP1.5倍，一直增长到GDP占比36%。<br />2008年，投资，4万亿计划 地铁、4G、高铁<br />2020年，消费，大循环，双循环，消费升级，产业升级。</p><blockquote><p>2021年，中国或将成为全球最大的消费市场。  – 迟福林 中国改革发展研究院院长</p></blockquote><p><strong>新消费时代：新模式，新渠道，新品牌</strong></p><h3 id="新模式"><a class="markdownIt-Anchor" href="#新模式"></a> 新模式</h3><blockquote><p>看上去，我们是在帮开发商买房子，其实上，我们是在帮消费者买房子。 – 胡炜 若缺科技创始人。<br />基本上不赚钱，交个朋友。 – 罗永浩 [帮用户消费，大型团购]<br />面向超级用户，春暖花开。 – 罗振宇 得到APP创始人 [对用户好]</p></blockquote><h3 id="新渠道"><a class="markdownIt-Anchor" href="#新渠道"></a> 新渠道</h3><p>消费者决策的唯一依据：信息，文字-&gt;图文时代-&gt;视频时代</p><p>视频，可能是“经典互联网”的终极形态，直到元宇宙出现。经典互联网：听觉，视觉，元宇宙：触觉、味觉、嗅觉。</p><p>用短视频+直播，把所有产品都重新卖一遍。</p><h3 id="新品牌"><a class="markdownIt-Anchor" href="#新品牌"></a> 新品牌</h3><blockquote><p>品牌的基础是信任 – 未来设计<br />炮制虽繁，必不敢省人工，品味虽贵，必不敢减物力。 – 同仁堂</p></blockquote><p>品牌可能有点贵，但是被“骗”的成本更高。</p><p>新国货：经济自信 + 制度自信 = 文化自信</p><h2 id="z0时代"><a class="markdownIt-Anchor" href="#z0时代"></a> Z0时代</h2><p>22年，00后大学毕业了。</p><h3 id="时代划分"><a class="markdownIt-Anchor" href="#时代划分"></a> 时代划分</h3><ul><li>X时代(1965～1980):科技发展，社会巨变，经济危机。 –  迷茫</li><li>Y时代(1980~1995):千禧一代，个人电脑，互联网。 – 自信</li><li>Z时代(1995~2009):数字时代原住民，看重体验，挖掘更好。 – 独立</li></ul><h3 id="人群特点"><a class="markdownIt-Anchor" href="#人群特点"></a> 人群特点</h3><ul><li>富足：他们能赚，他们更敢花。</li><li>感性：有表情包广告文案，比没有表情包的，多33%的关注。</li><li>颜值：买基金看基金经理的颜值。</li><li>爱国：他们长大时，国家已经强大。</li><li>独立：不喜欢团建，反对加班。</li><li>懒宅：追求生活最优解，买衣服买最省事的。懒得社交，懒得点赞，懒得恋爱，懒得出门。</li><li>养宠：我可以得过且过，但主子必须应有尽有。</li><li>养生：啤酒里面加枸杞，可乐里面加党参。 – 朋克</li><li>意义：不是被缺钱的焦虑驱动，而是被意义的动力驱动。</li></ul><p>我们必须理解他们，只有理解了他们，我们才理解了未来。我们必须和他们做朋友，只有和他们做朋友，才是时间的朋友。</p><h2 id="流量"><a class="markdownIt-Anchor" href="#流量"></a> 流量</h2><p>产品生意和流量生意，前者是把产品做出来，后者是把产品卖出去。</p><h3 id="流量生态"><a class="markdownIt-Anchor" href="#流量生态"></a> 流量生态</h3><p>流量生态的第一次打通</p><ul><li>线下：一铺养三代，流量成本高</li><li>线上：天下没有难做的生意，流量成本低。</li></ul><p>流量生态的第二次打通</p><ul><li>公域：付费用水，价高者得。</li><li>私域：打井很贵，用水免费。</li></ul><p>私域就是那些你直接拥有的、可重复低成本甚至免费触达的用户<br /><img src="https://static.v2grad.com/img/202201190739417.png" alt="私域模型" /></p><h3 id="私有化"><a class="markdownIt-Anchor" href="#私有化"></a> 私有化</h3><p>临沂君悦购物中心</p><ul><li>用拼团，建立信任，团购转化率22%</li><li>用内容，降低成本，节约了90%以上的海报印刷费</li><li>用倾听，改进服务，从反馈中，创新产品。</li></ul><h3 id="复购率"><a class="markdownIt-Anchor" href="#复购率"></a> 复购率</h3><p>用覆盖率，来摊薄越来越贵的初次获客成本。</p><blockquote><p>花400元留住老客户，比花4000元获得新客户，便宜太多了。 – 小鹅通</p></blockquote><h3 id="转介绍"><a class="markdownIt-Anchor" href="#转介绍"></a> 转介绍</h3><table><thead><tr><th></th><th>高频</th><th>低频</th></tr></thead><tbody><tr><td>高价</td><td>苹果手机/茅台<br>太爽了</td><td>房子/装修<br><strong>私域：转介绍</strong></td></tr><tr><td>低价</td><td>生鲜，订阅服务<br><strong>私域：复购率</strong></td><td>针/指甲刀<br>太难了</td></tr></tbody></table><blockquote><p>同行已经做了的服务，就不是服务，是义务。 – 纪文华 豪车毒</p></blockquote><p>私域带来了8%的时间增量，和11%的空间增量。</p><h2 id="跨境"><a class="markdownIt-Anchor" href="#跨境"></a> 跨境</h2><p><img src="https://static.v2grad.com/img/202201190742116.png" alt="跨境" /><br />行业挣钱，看“红利”，企业挣钱，看“稀缺”。</p><p>把红利变成利润，把“不得不来”变成“不想离开”。</p><p><strong>跨境加时赛： 专业化 品牌化 本土化</strong></p><h3 id="专业化"><a class="markdownIt-Anchor" href="#专业化"></a> 专业化</h3><p>吴三柜，遇到了张三封。</p><p>你明明知道我在做什么，但是就是干不过我。</p><h3 id="品牌化"><a class="markdownIt-Anchor" href="#品牌化"></a> 品牌化</h3><blockquote><p>在美国人心中最知名的品牌：1.大疆，2.联想，3.安克Anker， 4.海尔， 5.青岛啤酒 – 郭杰瑞</p></blockquote><p>当消费者在平台上搜你的品牌，而不是品类时，你就获得了溢价。</p><h3 id="本土化"><a class="markdownIt-Anchor" href="#本土化"></a> 本土化</h3><p>物物交易  - 外汇储备限制。</p><p>东南亚招商，菲律宾：我们这里罢工少</p><p>所谓全球化，就是在每个国家的本土化</p><p>我们的星辰大海，不是跨境电商，而是全球化品牌。</p><h2 id="疯狂生长"><a class="markdownIt-Anchor" href="#疯狂生长"></a> 疯狂生长</h2><p>这个世界在哪里被撕裂，就会在哪里迎来一轮疯狂生长。</p><h3 id="教培新规"><a class="markdownIt-Anchor" href="#教培新规"></a> 教培新规</h3><p>曾经有位爬竿选手拿到了冠军，却被取消了资格，原因是：更富有的选手可以买更贵的杆子，请更好的老师学爬竿。</p><h3 id="反垄断"><a class="markdownIt-Anchor" href="#反垄断"></a> 反垄断</h3><p>2021年4月，阿里被罚182亿<br />2021年10月，美团被罚34亿</p><p>流量生态的第三次打通：平台壁垒<br />渐变，是大公司的小机会；突变，是小公司的大机会。2022年，平台壁垒打破，万物疯狂生长。</p><blockquote><p>我们用微软的软件武装了iPhone，我用的是iPhone Pro。  – 微软CEO</p></blockquote><p><strong>进化的力量：用“海量”的物竞， 应对“复杂“的天择。</strong></p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://www.bilibili.com/video/BV1Db4y1b7Uh?from=search&amp;seid=18390105715163562235&amp;spm_id_from=333.337.0.0">进化的力量 / bilibili</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2022/01/09/the-power-of-evolution/</id>
    <link href="https://v2grad.com/2022/01/09/the-power-of-evolution/"/>
    <published>2022-01-08T16:00:00.000Z</published>
    <summary>看完刘润老师的年度演讲《进化的力量》，记录了讲到的老龄化、数字化、新消费、Z0时代、流量、跨境以及疯狂生长的主题的核心内容。</summary>
    <title>《进化的力量·刘润年度演讲》观后感</title>
    <updated>2022-01-18T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="思维精进" scheme="https://v2grad.com/categories/thinking/"/>
    <category term="年终总结" scheme="https://v2grad.com/tags/%E5%B9%B4%E7%BB%88%E6%80%BB%E7%BB%93/"/>
    <content>
      <![CDATA[<p>真的觉得自己不适合写这种文章，总结用词上需要考量和斟酌的地方太多了。</p><h2 id="2021年终总结"><a class="markdownIt-Anchor" href="#2021年终总结"></a> 2021年终总结</h2><p>从下面几个角度总结一下自己的2021年吧</p><h3 id="工作"><a class="markdownIt-Anchor" href="#工作"></a> 工作</h3><p>今年自己的研究兴趣和工作内容发生了挺大的变换。</p><ul><li><strong>研究兴趣</strong>：传统搜广推算法 -&gt; 大规模预训练模型</li><li><strong>工作内容</strong>：程序化广告算法前沿探索 -&gt; 增加仿真支撑和变现探索的工作。</li></ul><p>列一下今年做的项目方向，以及收获和经验吧。</p><ul><li><strong>临时需求</strong>：做了一个短视频打标的项目，最终准确率达到了业务提出的要求，顺道复习了一下CV相关的知识。</li><li><strong>程序化相关</strong>：这个方向其实很成熟，我司无论人力还是实力都不是第一梯队的，大方向其实非常清晰，针对我们的数据集实验和探索就行了，今年我主要在做多目标模型方面的实验。</li><li><strong>仿真相关</strong>：非标准机器学习项目，行业知识方面需要补课，让我更加深刻的认识了广告这个行业，22年重点提升的方向。</li></ul><p>工作总结放一张年底在公司内部做分享的照片结束吧。<br /><img src="https://static.v2grad.com/img/202201031648392.jpg" alt="技术分享" /></p><h3 id="生活"><a class="markdownIt-Anchor" href="#生活"></a> 生活</h3><p><strong>运动</strong><br />年初开始运动，坚持了一两个月以后，得了足底筋膜炎，疼了半年时间，最近才感觉完全恢复。<br /><img src="https://static.v2grad.com/img/202201031646345.png" alt="运动" /></p><p><strong>饮食</strong><br />看到一句话：“<em>想减肥，靠吃就可以了；运动的目的是让你有线条。</em>”，开始减少吃面的频率，发现体重真的下来了。<br />体重从年初的90公斤，变成了现在的85公斤，这段时间隔离，在家动的少，吃的多，有破防的风险 = =！</p><p><strong>陪伴</strong><br />小孩两岁多了，觉得自己有责任花一些时间陪伴孩子，小孩睡得早，每天基本都是八点半到家，高质量陪伴家里的孩子半个小时到一个小时。现在他越来越喜欢跟我玩了～</p><h3 id="学习"><a class="markdownIt-Anchor" href="#学习"></a> 学习</h3><p>9月份开始尝试做一些内容的输出，输出倒逼输入，强制自己对一些问题深入思考。目前基本能保证两周一篇文章的节奏。</p><p>读书方面，渐渐适应了看电子书，打开了新世界，把大量的碎片时间都利用起来了，看书速度提高了不少。</p><h2 id="2022年规划"><a class="markdownIt-Anchor" href="#2022年规划"></a> 2022年规划</h2><ul><li><strong>对工作</strong>：以价值输出为导向，多思考，勤沟通，做真正能够推动业务的事情。</li><li><strong>对家庭</strong>：多陪伴，做到高质量陪伴。</li><li><strong>对个人</strong>：健康的身体，有趣的灵魂，保持好奇心。</li></ul><p>看到张辉的<a href="https://mp.weixin.qq.com/s/NtebXM2v6Ja1smbqpm5fjg">《用OKR改变工作和生活》</a>以及大伟的<a href="https://mp.weixin.qq.com/s/bViHW8VUPvKPilwOYeZS8g">《以OKR的方式回顾我的2021》</a>，我也考虑用OKR帮助自己实现22年的个人目标。</p><p>鉴于OKR我还在学习当中，这部分内容等我梳理好以后再说吧。。</p>]]>
    </content>
    <id>https://v2grad.com/2022/01/05/summary-2021/</id>
    <link href="https://v2grad.com/2022/01/05/summary-2021/"/>
    <published>2022-01-04T16:00:00.000Z</published>
    <summary>总结自己在21年工作、学习和生活上的大事件和感悟；2022年，终身学习、自我驱动、保持好奇心，由内而外重塑自己。</summary>
    <title>我的2021年年终总结</title>
    <updated>2022-01-04T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="机器学习" scheme="https://v2grad.com/categories/machinelearning/"/>
    <category term="pipeline" scheme="https://v2grad.com/tags/pipeline/"/>
    <content>
      <![CDATA[<h2 id="机器学习"><a class="markdownIt-Anchor" href="#机器学习"></a> 机器学习</h2><h3 id="经典编程方法-vs-机器学习方法"><a class="markdownIt-Anchor" href="#经典编程方法-vs-机器学习方法"></a> 经典编程方法 VS 机器学习方法</h3><p>业务需求：购物网站产品推荐，假设您需要创建一款后端应用程序，使其根据客户过去的购买记录向他们推荐产品。</p><p><strong>经典编程</strong>：根据数据（输入）进行预测（输出），需要对数据应用一些规则，在经典编程中，这些规则由人根据业务需求和领域知识等因素制定。</p><p><strong>机器学习</strong>：利用过去收集的各种数据,自动推导出数据中隐藏的模式。然后,利用模式创建模型,应用于新数据,从而提供更明智的自适应预测。</p><p><img src="https://static.v2grad.com/img/202112281403309.png" alt="机器学习VS经典编程" /></p><h3 id="什么是模型"><a class="markdownIt-Anchor" href="#什么是模型"></a> 什么是模型？</h3><p>机器学习中的模型是指经过训练的算法，用于识别数据中的模式。关键在于，他是通过机器学习过程来训练的，而不像经典编程一样，是由编程人员通过设置规则手动创建的。</p><h3 id="ml管道"><a class="markdownIt-Anchor" href="#ml管道"></a> ML管道</h3><p><img src="https://static.v2grad.com/img/202112220844576.jpg" alt="机器学习管道" /></p><ul><li><strong>业务问题</strong>：需要确定能够从机器学习中受益的业务问题。</li><li><strong>定义问题</strong>：需要理清业务问题并将其转化为机器学习问题。</li><li><strong>数据收集和整合</strong>：确保原始数据位于一个集中且易于访问的地方。</li><li><strong>预处理和可视化数据</strong>：将原始数据转换为易于理解的格式并从数据中提取重要特征。</li><li><strong>模型训练和优化</strong>：这是一个迭代的过程，可以在整个工作流程中多次执行。刚开始模型可能不会产生期望的结果，需要设计更多特征并优化模型超参数，然后重新训练。</li><li><strong>模型评估</strong>：持续的进行模型训练和优化，直到模型的评估结果显示模型的性能符合业务案例的要求。如果模型不符合业务目标，则需要重新评估一些东西，再次审视一下数据和特征，寻找改进模型的方法。</li><li><strong>模型部署</strong>：如果对训练结果感到满意，就可以部署模型来交付最佳预测结果，这通常是一项繁重的体力劳动。</li></ul><h2 id="问题定义"><a class="markdownIt-Anchor" href="#问题定义"></a> 问题定义</h2><p><img src="https://static.v2grad.com/img/202112281301865.jpg" alt="问题定义" /><br />问题定义是管道中的研究性阶段，是对需要解决的问题进行分析和定义的过程。这项工作是所有ML项目的起始点，因为我们需要充分确定某个问题，才能确定出相应的解决方案。</p><h3 id="确定问题"><a class="markdownIt-Anchor" href="#确定问题"></a> 确定问题</h3><p>示例：某些产品库存挤压，某些产品库存不足，分别导致开销增加和错过销售机会。</p><ul><li>业务问题：需求预测不准确，让企业蒙受损失。</li><li>业务目标：减少未销售的库存的数量，同时不因库存不足而错过销售机会。</li><li>成功指标：每月月底未销售出的库存不超过15%，同时不存在库存不足的问题。</li></ul><p>确定问题在业务方面的信息后，接下来需要确定使用哪种ML模型。<br />我们要预测每种产品的具体销量，因此这最有可能是一种回归问题。</p><h3 id="确定成功标准"><a class="markdownIt-Anchor" href="#确定成功标准"></a> 确定成功标准</h3><ul><li><strong>模型效果指标</strong><ul><li>在ML管道的测试和评估环节使用</li><li>一般通过准确性来体现</li></ul></li><li><strong>业务目标指标</strong><ul><li>在<strong>部署</strong>模型后使用</li><li>衡量模型在<strong>真实环境</strong>中的效果</li><li>可以识别出<strong>不当的模型效果指标</strong></li></ul></li></ul><h2 id="数据收集和整合"><a class="markdownIt-Anchor" href="#数据收集和整合"></a> 数据收集和整合</h2><p><img src="https://static.v2grad.com/img/202112281302881.jpg" alt="数据收集和整合" /></p><h3 id="选择数据"><a class="markdownIt-Anchor" href="#选择数据"></a> 选择数据</h3><ul><li><strong>了解数据</strong>：有多少数据，位于哪里，数据量，数据位置以及可否访问。</li><li><strong>寻找领域专家</strong>：是否拥有解决问题<strong>所需的数据</strong>？数据是否有<strong>代表性</strong>？</li><li><strong>评估数据质量</strong>：好的数据会包含与我们希望预测的现象有关的信号，是否具有足够的特征和标签。</li></ul><h3 id="数据湖"><a class="markdownIt-Anchor" href="#数据湖"></a> 数据湖</h3><p>了解了你需要的数据以后，现实场景中，机器学习项目的数据来自多个数据源，并呈现为不同类型的数据，包括结构化、半结构化和非结构化的数据。例如数据可以来自CSV文件和传统数据库。</p><p>当数据以不同格式存储在各个不同的位置时,组织经常会面临访问和分析其数据的挑战。随着数据不断收集自各种来源,如果不能妥善处理,这一挑战只会随着组织的成熟和发展而变得越来越严峻。无法轻松访问数据会导致工作流程出现瓶颈,因为员工经常需要向IT部门寻求帮助,以访问构建、训练和部署机器学习模型所需的信息。为了应对这些挑战,组织不得不寻求这样一种解决方案:<strong>能够提供单一数据来源,让员工能够随时根据需要轻松访问数据。</strong> 本地解决方案通常很难做到这一点,而且维护成本很高。</p><p><img src="https://static.v2grad.com/img/202112230809278.png" alt="数据湖" /><br />数据湖架构可以提供一个坚实的基础,用于构建解决方案应对这一挑战。借助数据湖, 可以将大量数据存储在一个集中存储库,以便组织内的各个团队随时对其进行分类、处理、扩充和使用。<br />但是,建立数据湖并没有什么灵丹妙药。在大多数情况下,构建数据湖需要使用多种 技术、工具和环境,包括来自第三方的数据。如果操作正确,数据湖将为全新的高级 分析方法打开一扇大门,从而推动数据科学和机器学习。</p><h2 id="数据预处理和可视化"><a class="markdownIt-Anchor" href="#数据预处理和可视化"></a> 数据预处理和可视化</h2><p><img src="https://static.v2grad.com/img/202112281303539.jpg" alt="数据预处理和可视化" /></p><h3 id="重新格式化数据"><a class="markdownIt-Anchor" href="#重新格式化数据"></a> 重新格式化数据</h3><ul><li><strong>Pandas</strong>：Pandas 是一个开源 Python 库,可用于重新格式化特定数据。Pandas 将 CSV、JSON、 Excel、Pickle 等各种格式的数据重新格式化为表格形式,以行和列的形式呈现出来。Pandas将数据格式化后得出的表格格式称为DataFrame，可以进行计算统计信息，清理数据，对其进行可视化，甚至将清理或转换后的数据重新以其原始格式存储。</li><li><strong>NumPy</strong>:NumPy是一个Python库,可在与 Python 搭配使用进行科学计算时用作基础 软件包。这是一个通用的数组处理程序包,可提供高性能的多维数组对象以及用于处理这些数组的工具。</li><li><strong>Scikit-learn</strong>:Scikit-learn是一个开源Python库,其中包括用于数据挖掘和数据分析的 各种工具。它基于NumPy、SciPy 和Matplotilb库而构建,可用于机器学习管道的每个阶段,包括数据预处理。我们将在管道的模型训练阶段回过头来学习Scitkit,因为该库包含了线性回归和随机森林等监督算法,以及集群和K-means等非监督算法。</li><li><strong>Matplotlib</strong>:Matplotlib 是 Python 中的可视化库,用于NumPy数组的二维图。借助 Matplotlib,您可以通过多种方式可视化数据,其中包括线形图和条形图、散点图和直方图。您可以直接在 Python 脚本、Jupyter笔记本、iPython Shell 和其他平台中利用该库。</li><li><strong>Seaborn</strong>:Seaborn 是另一个Python数据可视化库。它基于Matplotlib构建,并与Pandas DataFrame紧密集成。它提供了一个高级界面,可绘制有吸引力且内容丰富的统计图形。</li></ul><h3 id="数据预处理"><a class="markdownIt-Anchor" href="#数据预处理"></a> 数据预处理</h3><p>数据会出现多种形式混乱</p><ul><li>算法希望看到使用英语编写的数据，但数据中的有些单词使用了其他语言</li><li>某些单词中包含特殊字符，单词之间有多个空格，大小写混用。</li><li>数据有多个不同的数据单位，比如公里、米、英尺混用。</li><li>因为录入问题，某列中包含其他列中的数据。</li></ul><h4 id="异常值"><a class="markdownIt-Anchor" href="#异常值"></a> 异常值</h4><p>产生异常值的原因：</p><ul><li><strong>自然的异常值</strong> 不是人为的错误结果，而是反应了数据中的一些事实。</li><li><strong>人为错误的异常值</strong> 数据输入错误，以及其他错误类型。</li></ul><p>处理异常值的方法：</p><ul><li><strong>删除异常值</strong>:这种方法特别适合在人为错误导致异常值的情况下使用。</li><li><strong>转变异常值</strong>:您可以通过取一个值的自然对数进行这一操作,这将减少由极端异 常值引起的变化,从而减少异常值对整个数据集的影响。</li><li><strong>为异常值输入新值</strong>:例如,您可以使用特征的平均值,然后输入该值以替换异常值。同样,如果异常值是由人为错误引起的,那么这种方法非常合适。</li></ul><h4 id="缺失值"><a class="markdownIt-Anchor" href="#缺失值"></a> 缺失值</h4><p>由于数据收集错误,数据集中的某些列可能会缺失数据,或者直到进入数据收集过程之前才收集具有特定特征的数据。缺失数据会导致很难准确解读相关特征和目标变量之间的关系,因此,无论数据到底是怎么缺失的,处理这一问题都很重要。</p><p>缺失几个值可能不是问题,但如果一列中缺失的值过多,您可能会发现很难解读该特 征和目标(与模型需要预测的内容对应的该行中的值)之间的关系。</p><p><strong>缺失值统计</strong><br />pandas检查缺失值或者NULL值</p><ul><li>检查<strong>每一列</strong>有多少缺失值：df.isnull().sum()</li><li>检查<strong>每一行</strong>有多少缺失值：df.isnull().sum(axis=1)</li></ul><p><strong>缺失值处理</strong></p><ul><li><strong>替换缺失值</strong>：如果缺失值在整个数据集中随机分布，可能是由于数据捕获机制出现故障，并不代表其相应行或列的大部分，因为数据在很大程度是随机缺失的。这种情况下，替换是更好的选择。<ul><li>离散特征：使用出现最频繁的值来替换</li><li>连续特征：使用平均值或者中位数来替换</li></ul></li><li><strong>删除缺失值</strong>：如果列或者行的缺失占很大比例，则优先考虑删除整个行或列，而不是替换。<ul><li>删除行的风险：a.训练数据不足，过拟合。b.可能会偏向样本</li><li>删除列的风险：可能会丢失特征中的信息，欠拟合。</li></ul></li></ul><h3 id="数据可视化"><a class="markdownIt-Anchor" href="#数据可视化"></a> 数据可视化</h3><h4 id="分类数据可视化"><a class="markdownIt-Anchor" href="#分类数据可视化"></a> 分类数据可视化</h4><p>使用条形图可视化分类数据</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br><span class="line">7</span><br></pre></td><td class="code"><pre><code class="hljs python">speed = [<span class="hljs-number">0.1</span>, <span class="hljs-number">17.5</span>, <span class="hljs-number">40</span>, <span class="hljs-number">48</span>, <span class="hljs-number">52</span>, <span class="hljs-number">69</span>, <span class="hljs-number">88</span>]<br>lifespan = [<span class="hljs-number">2</span>, <span class="hljs-number">8</span>, <span class="hljs-number">70</span>, <span class="hljs-number">1.5</span>, <span class="hljs-number">25</span>, <span class="hljs-number">12</span>, <span class="hljs-number">28</span>]<br>index = [<span class="hljs-string">&#x27;snail&#x27;</span>, <span class="hljs-string">&#x27;pig&#x27;</span>, <span class="hljs-string">&#x27;elephant&#x27;</span>,<br>         <span class="hljs-string">&#x27;rabbit&#x27;</span>, <span class="hljs-string">&#x27;giraffe&#x27;</span>, <span class="hljs-string">&#x27;coyote&#x27;</span>, <span class="hljs-string">&#x27;horse&#x27;</span>]<br>df = pd.DataFrame(&#123;<span class="hljs-string">&#x27;speed&#x27;</span>: speed,<br>                   <span class="hljs-string">&#x27;lifespan&#x27;</span>: lifespan&#125;, index=index)<br>ax = df.plot.bar(rot=<span class="hljs-number">0</span>)<br></code></pre></td></tr></table></figure><p><img src="https://static.v2grad.com/img/202112252018884.png" alt="条形图" /></p><h4 id="数值数据可视化"><a class="markdownIt-Anchor" href="#数值数据可视化"></a> 数值数据可视化</h4><p><strong>直方图</strong><br />使用直方图进行数据可视化时会对值进行分箱，直方图中较高的峰值表示最常见的值。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br></pre></td><td class="code"><pre><code class="hljs python">df = pd.DataFrame(&#123;<br>    <span class="hljs-string">&#x27;length&#x27;</span>: [<span class="hljs-number">1.5</span>, <span class="hljs-number">0.5</span>, <span class="hljs-number">1.2</span>, <span class="hljs-number">0.9</span>, <span class="hljs-number">3</span>],<br>    <span class="hljs-string">&#x27;width&#x27;</span>: [<span class="hljs-number">0.7</span>, <span class="hljs-number">0.2</span>, <span class="hljs-number">0.15</span>, <span class="hljs-number">0.2</span>, <span class="hljs-number">1.1</span>]<br>    &#125;, index=[<span class="hljs-string">&#x27;pig&#x27;</span>, <span class="hljs-string">&#x27;rabbit&#x27;</span>, <span class="hljs-string">&#x27;duck&#x27;</span>, <span class="hljs-string">&#x27;chicken&#x27;</span>, <span class="hljs-string">&#x27;horse&#x27;</span>])<br>hist = df.hist(bins=<span class="hljs-number">3</span>)<br></code></pre></td></tr></table></figure><p><img src="https://static.v2grad.com/img/202112252017101.png" alt="直方图" /></p><p><strong>密度图</strong><br />密度图展示了单个特征的分布，密度图类似于直方图，但它使用核密度函数展示了平滑版的直方图密度。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs Python">s = pd.Series([<span class="hljs-number">1</span>, <span class="hljs-number">2</span>, <span class="hljs-number">2.5</span>, <span class="hljs-number">3</span>, <span class="hljs-number">3.5</span>, <span class="hljs-number">4</span>, <span class="hljs-number">5</span>])<br>ax = s.plot.kde()<br></code></pre></td></tr></table></figure><p><img src="https://static.v2grad.com/img/202112252020274.png" alt="密度图" /></p><p><strong>箱线图</strong><br />箱线图使用四分位间距来描绘特征的分布。</p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br></pre></td><td class="code"><pre><code class="hljs Python">data = np.random.randn(<span class="hljs-number">25</span>, <span class="hljs-number">4</span>)<br>df = pd.DataFrame(data, columns=<span class="hljs-built_in">list</span>(<span class="hljs-string">&#x27;ABCD&#x27;</span>))<br>ax = df.plot.box()<br></code></pre></td></tr></table></figure><p><img src="https://static.v2grad.com/img/202112252028029.png" alt="箱线图" /></p><h4 id="属性之间的关系"><a class="markdownIt-Anchor" href="#属性之间的关系"></a> 属性之间的关系</h4><p>对于具有多个变量或特征的情况,您可能需要查看它们之间的相关性。确定属性之间 的相关性很重要,因为两个属性之间的高相关性有时会导致模型性能较差。如果特征 之间密切相关,并且全都用于同一个模型中以预测响应变量,就可能会出现问题,例 如,模型损失不能收敛到最小状态。因此,请注意数据集中高度相关的特征。</p><p><strong>散点图和散点图矩阵</strong></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br><span class="line">3</span><br><span class="line">4</span><br><span class="line">5</span><br><span class="line">6</span><br></pre></td><td class="code"><pre><code class="hljs Python">df = pd.DataFrame([[<span class="hljs-number">5.1</span>, <span class="hljs-number">3.5</span>, <span class="hljs-number">0</span>], [<span class="hljs-number">4.9</span>, <span class="hljs-number">3.0</span>, <span class="hljs-number">0</span>], [<span class="hljs-number">7.0</span>, <span class="hljs-number">3.2</span>, <span class="hljs-number">1</span>],<br>                   [<span class="hljs-number">6.4</span>, <span class="hljs-number">3.2</span>, <span class="hljs-number">1</span>], [<span class="hljs-number">5.9</span>, <span class="hljs-number">3.0</span>, <span class="hljs-number">2</span>]],<br>                  columns=[<span class="hljs-string">&#x27;length&#x27;</span>, <span class="hljs-string">&#x27;width&#x27;</span>, <span class="hljs-string">&#x27;species&#x27;</span>])<br>ax1 = df.plot.scatter(x=<span class="hljs-string">&#x27;length&#x27;</span>,<br>                      y=<span class="hljs-string">&#x27;width&#x27;</span>,<br>                      c=<span class="hljs-string">&#x27;DarkBlue&#x27;</span>)<br></code></pre></td></tr></table></figure><p><img src="https://static.v2grad.com/img/202112252033581.png" alt="散点图" /></p><figure class="highlight python"><table><tr><td class="gutter"><pre><span class="line">1</span><br><span class="line">2</span><br></pre></td><td class="code"><pre><code class="hljs Python">df = pd.DataFrame(np.random.randn(<span class="hljs-number">1000</span>, <span class="hljs-number">4</span>), columns=[<span class="hljs-string">&#x27;A&#x27;</span>,<span class="hljs-string">&#x27;B&#x27;</span>,<span class="hljs-string">&#x27;C&#x27;</span>,<span class="hljs-string">&#x27;D&#x27;</span>])<br>pd.plotting.scatter_matrix(df, alpha=<span class="hljs-number">0.2</span>)<br></code></pre></td></tr></table></figure><p><img src="https://static.v2grad.com/img/202112252035865.png" alt="散点图矩阵" /></p><p><strong>相关性矩阵热图</strong><br />numpy.corrcoef 计算相关性矩阵，使用Matplotlib或者Seaborn进行可视化。<br /><img src="https://static.v2grad.com/img/202112252041244.png" alt="相关性矩阵热图" /></p><h2 id="模型训练和优化"><a class="markdownIt-Anchor" href="#模型训练和优化"></a> 模型训练和优化</h2><p><img src="https://static.v2grad.com/img/202112281304798.jpg" alt="模型训练和优化" /><br />在训练过程中,机器学习算法会更新一组称为参数或权重的数字。目标是更新模型中 的参数,使计算或预测的输出尽可能接近真实的输出(就像在数据中看到的一样)。</p><p>一次迭代无法完成,因为算法还没有学会;它不知道改变权重会如何使输出更接近期望值。因此,它会观察之前迭代中的权重和输出,使权重降低生成的输出的误差。执 行完定义的迭代次数后或当误差变化低于目标值时,此迭代过程将会停止。</p><p>如果输出误差随着每次连续迭代逐渐减小,则我们可以说该模型已收敛,训练成功。 但如果误差在迭代之间增大或随机变化,则需要重新评估构建模型时的假设。</p><p><img src="https://static.v2grad.com/img/202112261107474.png" alt="模型训练过程" /></p><h3 id="数据拆分"><a class="markdownIt-Anchor" href="#数据拆分"></a> 数据拆分</h3><p>对数据进行预处理之后，就可以开始训练了。首先需要确定拆分数据的最佳方式，一般而言，机器学习目标是构建一个泛化能力较强的模型。换句话说，模型不仅要能处理已知数据，还要能处理未知数据。因此拆分数据很重要。</p><p>拆分数据有助于确保数据块有资格成为未来的生成数据，还有助于保证模型预测未知数据的准确率和预测已知数据的准确率类似。这有助于提高模型的泛化能力。</p><p>测试和验证方法</p><ul><li><strong>简单留出验证</strong>：将数据拆分为多个数据集，通常为训练集、验证集和测试集。<br /><img src="https://static.v2grad.com/img/202112260724131.png" alt="简单留出验证" /></li><li><strong>K折交叉验证</strong>：把数据集分成K份，每个子集互不相交且大小相同，依次从K份中选出1份作为验证集，其余K-1份作为训练集，这样进行K次单独的模型训练和验证，最后将K次验证结果取平均值，作为此模型的验证误差。<br /><img src="https://static.v2grad.com/img/202112261104698.png" alt="K折交叉验证" /></li><li><strong>留一交叉验证</strong>：测试集是一个数据点，适用于<strong>非常小</strong>的数据集</li><li><strong>分层K折交叉验证</strong>：训练集和测试集平衡类别分布，适用于<strong>不平衡</strong>的数据。</li><li><strong>打乱数据的迭代K折验证</strong></li></ul><h3 id="损失函数"><a class="markdownIt-Anchor" href="#损失函数"></a> 损失函数</h3><p>模型训练的目标是创建一个准确的模型，让他根据需求正确地解答业务问题。</p><p>损失函数用来评价模型的预测值和真实值不一样的程度，损失函数越好，通常模型的性能越好。不同的模型用的损失函数一般也不一样。</p><p>损失函数分为经验风险损失函数和结构风险损失函数。经验风险损失函数指预测结果和实际结果的差别，结构风险损失函数是指经验风险损失函数加上正则项。</p><p><img src="https://static.v2grad.com/img/202112261818366.png" alt="损失函数" /></p><h3 id="优化器"><a class="markdownIt-Anchor" href="#优化器"></a> 优化器</h3><p><img src="https://static.v2grad.com/img/202112261822292.png" alt="梯度下降" /></p><ul><li><strong>批量梯度下降法（Batch Gradient Descent）</strong>：批量梯度下降法，是梯度下降法最常用的形式，具体做法也就是在更新参数时使用所有的样本来进行更新，</li><li><strong>随机梯度下降法（Stochastic Gradient Descent）</strong>：随机梯度下降法，其实和批量梯度下降法原理类似，区别在与求梯度时没有用所有的m个样本的数据，而是仅仅选取一个样本j来求梯度。</li><li><strong>小批量梯度下降法（Mini-batch Gradient Descent）</strong>：小批量梯度下降法是批量梯度下降法和随机梯度下降法的折衷，也就是对于m个样本，我们采用x个样子来迭代，1&lt;x&lt;m。一般可以取x=10，当然根据样本的数据，可以调整这个x的值。</li></ul><p><strong>步长/学习速率</strong><br />步长的大小至关重要,因为步长较大可能会导致模型超过最低点,从而使模型来回摆动,永远不会达到最小值。但是,步长较小可能会导致模型非常缓慢地朝着最小值移动,在给定时间内无法达到最小值。步长大小又称“学习速率”,它是模型的超参数。</p><h2 id="模型评估"><a class="markdownIt-Anchor" href="#模型评估"></a> 模型评估</h2><p><img src="https://static.v2grad.com/img/202112281304583.jpg" alt="模型评估" /></p><h3 id="过拟合和欠拟合"><a class="markdownIt-Anchor" href="#过拟合和欠拟合"></a> 过拟合和欠拟合</h3><p><img src="https://static.v2grad.com/img/202112270845483.png" alt="过拟合和欠拟合" /></p><ul><li><strong>欠拟合</strong>是指模型不能在训练集上获得足够低的误差。换句话说，就是模型复杂度低，模型在训练集上就表现很差，没法学习到数据背后的规律。</li><li><strong>过拟合</strong>是指训练误差和测试误差之间的差距太大。换句话说，就是模型复杂度高于实际问题，模型在训练集上表现很好，但在测试集上却表现很差。模型对训练集&quot;死记硬背&quot;，没有理解数据背后的规律，泛化能力差。</li></ul><p><img src="https://static.v2grad.com/img/202112270848369.png" alt="过拟合和欠拟合" /></p><p><strong>解决方案</strong></p><ul><li><strong>欠拟合</strong><ul><li>增加模型复杂度</li><li>增加模型的特征</li></ul></li><li><strong>过拟合</strong><ul><li>正则化（Regularization）（L1和L2）</li><li>数据扩增，即增加训练数据样本</li><li>Dropout</li><li>Early stopping</li></ul></li></ul><h3 id="方差和偏差"><a class="markdownIt-Anchor" href="#方差和偏差"></a> 方差和偏差</h3><ul><li><strong>偏差</strong>：预测值于真实值之间的差距，即学习算法的拟合能力。</li><li><strong>方差</strong>：预测值的分散程度，训练集与验证集的差异造成的模型表现的差异。</li></ul><p><img src="https://static.v2grad.com/img/202112270851712.png" alt="方差和偏差" /></p><table><thead><tr><th></th><th>低偏差</th><th>高偏差</th></tr></thead><tbody><tr><td><strong>低方差</strong></td><td>射手很稳，枪的准星也很准。</td><td>射手很稳，但是枪的准星有问题，所有子弹都固定地偏向一侧。</td></tr><tr><td><strong>高方差</strong></td><td>射手不太稳，但枪的准星没问题，虽然弹着点分布很散，但没有整体偏移。</td><td>射手不稳，而且枪的准星也有问题，弹着点分布很散且有规律地偏向一侧。</td></tr></tbody></table><p><img src="https://static.v2grad.com/img/202112270900432.png" alt="偏差和方差" /></p><p>我们希望偏差与方差越小越好，但实际并非如此。一般来说，偏差与方差是有冲突的，称为<strong>偏差-方差窘境 (bias-variance dilemma)</strong>。</p><ul><li>给定一个学习任务，在训练初期，由于训练不足，网络的拟合能力不够强，偏差比较大，也是由于拟合能力不强，数据集的特征也无法使网络产生显著变化，也就是欠拟合的情况。</li><li>随着训练程度的加深，网络的拟合能力逐渐增强，训练数据的特征也能够渐渐被网络学到。</li><li>充分训练后，网络的拟合能力已非常强，训练数据的微小特征都会导致网络发生显著变化，当训练数据自身的、非全局的特征被网络学到了，则将发生过拟合。</li></ul><h3 id="评估指标"><a class="markdownIt-Anchor" href="#评估指标"></a> 评估指标</h3><h4 id="分类问题指标"><a class="markdownIt-Anchor" href="#分类问题指标"></a> 分类问题指标</h4><p><img src="https://static.v2grad.com/img/202112270937734.png" alt="混淆矩阵" /><br />标签解释</p><ul><li><strong>P</strong>：样本数据中的正例数。</li><li><strong>N</strong>：样本数据中的负例数。</li><li><strong>Y</strong>：通过模型预测出来的正例数。</li><li><strong>N</strong>：通过模型预测出来的负例数。</li></ul><p>组合解释</p><ul><li><strong>真阳性</strong>:True Positives，表示实际是正样本预测成正样本的样本数，真实为1，预测也为1。</li><li><strong>假阳性</strong>:False Positives，表示实际是负样本预测成正样本的样本数，真实为0，预测为1。</li><li><strong>假阴性</strong>:False Negatives，表示实际是正样本预测成负样本的样本数，真实为1，预测为0。</li><li><strong>真阴性</strong>:True Negatives，表示实际是负样本预测成负样本的样本数，真实为0，预测也为0。</li></ul><p>计算公式</p><ul><li><strong>准确率Accuracy</strong>:分类模型总体判断的准确率(包括了所有class的总体准确率)。<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mtext> Accuracy </mtext><mo>=</mo><mfrac><mrow><mi>T</mi><mi>P</mi><mo>+</mo><mi>T</mi><mi>N</mi></mrow><mrow><mi>T</mi><mi>P</mi><mo>+</mo><mi>T</mi><mi>N</mi><mo>+</mo><mi>F</mi><mi>P</mi><mo>+</mo><mi>F</mi><mi>N</mi></mrow></mfrac></mrow><annotation encoding="application/x-tex">\text { Accuracy }=\frac{T P+T N}{T P+T N+F P+F N}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.8777699999999999em;vertical-align:-0.19444em;"></span><span class="mord text"><span class="mord"> Accuracy </span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.275662em;vertical-align:-0.403331em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.872331em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span><span class="mbin mtight">+</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span><span class="mbin mtight">+</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">F</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span><span class="mbin mtight">+</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">F</span><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.394em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span><span class="mbin mtight">+</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.403331em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li><strong>精确率Precision</strong>: 预测为1的准确率。 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><mtext> Precision </mtext><mo>=</mo><mfrac><mrow><mi>T</mi><mi>P</mi></mrow><mrow><mi>T</mi><mi>P</mi><mo>+</mo><mi>F</mi><mi>P</mi></mrow></mfrac></mrow><annotation encoding="application/x-tex">\text { Precision }=\frac{T P}{T P+F P}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.68333em;vertical-align:0em;"></span><span class="mord text"><span class="mord"> Precision </span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.275662em;vertical-align:-0.403331em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.872331em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span><span class="mbin mtight">+</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">F</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.394em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.403331em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li><strong>召回率ReCall</strong>：真实为1的准确率。<span class="katex"><span class="katex-mathml"><math><semantics><mrow><mtext> Recall </mtext><mo>=</mo><mfrac><mrow><mi>T</mi><mi>P</mi></mrow><mrow><mi>T</mi><mi>P</mi><mo>+</mo><mi>F</mi><mi>N</mi></mrow></mfrac></mrow><annotation encoding="application/x-tex">\text { Recall }=\frac{T P}{T P+F N}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.69444em;vertical-align:0em;"></span><span class="mord text"><span class="mord"> Recall </span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.275662em;vertical-align:-0.403331em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.872331em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span><span class="mbin mtight">+</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">F</span><span class="mord mathdefault mtight" style="margin-right:0.10903em;">N</span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.394em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.13889em;">T</span><span class="mord mathdefault mtight" style="margin-right:0.13889em;">P</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.403331em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li><strong>F1</strong>：对于某个分类，综合了Precision和Recall的一个判断指标，F1-Score的值是从0到1的，1是最好，0是最差。<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>F</mi><mn>1</mn></msub><mtext> Score </mtext><mo>=</mo><mfrac><mrow><mn>2</mn><mo>∗</mo><mtext> Precision </mtext><mo>∗</mo><mtext> Recall </mtext></mrow><mrow><mtext> Precision </mtext><mo>+</mo><mtext> Recall </mtext></mrow></mfrac></mrow><annotation encoding="application/x-tex">F_{1} \text { Score }=\frac{2 * \text { Precision } * \text { Recall }}{\text { Precision }+\text { Recall }}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.83333em;vertical-align:-0.15em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.13889em;">F</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.30110799999999993em;"><span style="top:-2.5500000000000003em;margin-left:-0.13889em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">1</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mord text"><span class="mord"> Score </span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.283439em;vertical-align:-0.403331em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.8801079999999999em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord text mtight"><span class="mord mtight"> Precision </span></span><span class="mbin mtight">+</span><span class="mord text mtight"><span class="mord mtight"> Recall </span></span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.394em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span><span class="mbin mtight">∗</span><span class="mord text mtight"><span class="mord mtight"> Precision </span></span><span class="mbin mtight">∗</span><span class="mord text mtight"><span class="mord mtight"> Recall </span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.403331em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li><strong>AUC-ROC</strong>：反映的是对于任意一对正负例样本,模型将正样本预测为正例的可能性大于将负例预测为正例的可能性的概率。</li></ul><h4 id="回归问题指标"><a class="markdownIt-Anchor" href="#回归问题指标"></a> 回归问题指标</h4><ul><li><strong>均方差</strong><br />Mean Squared Error叫做均方误差,用真实值-预测值,然后平方之后求和平均。</li></ul><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><mrow><mi mathvariant="normal">M</mi><mi mathvariant="normal">S</mi><mi mathvariant="normal">E</mi></mrow><mo>=</mo><mfrac><mn>1</mn><mi>m</mi></mfrac><munderover><mo>∑</mo><mrow><mi>i</mi><mo>=</mo><mn>1</mn></mrow><mi>m</mi></munderover><msup><mrow><mo fence="true">(</mo><msub><mi>y</mi><mi>i</mi></msub><mo>−</mo><msub><mover accent="true"><mi>y</mi><mo>^</mo></mover><mi>i</mi></msub><mo fence="true">)</mo></mrow><mn>2</mn></msup></mrow><annotation encoding="application/x-tex">\mathrm{MSE}=\frac{1}{m} \sum_{i=1}^{m}\left(y_{i}-\hat{y}_{i}\right)^{2}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.68333em;vertical-align:0em;"></span><span class="mord"><span class="mord mathrm">M</span><span class="mord mathrm">S</span><span class="mord mathrm">E</span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:2.929066em;vertical-align:-1.277669em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:1.32144em;"><span style="top:-2.314em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord mathdefault">m</span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.677em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord">1</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.686em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mop op-limits"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:1.6513970000000002em;"><span style="top:-1.872331em;margin-left:0em;"><span class="pstrut" style="height:3.05em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="mrel mtight">=</span><span class="mord mtight">1</span></span></span></span><span style="top:-3.050005em;"><span class="pstrut" style="height:3.05em;"></span><span><span class="mop op-symbol large-op">∑</span></span></span><span style="top:-4.3000050000000005em;margin-left:0em;"><span class="pstrut" style="height:3.05em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">m</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:1.277669em;"><span></span></span></span></span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">−</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mord"><span class="mord accent"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.19444em;">^</span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.19444em;"><span></span></span></span></span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.954008em;"><span style="top:-3.2029em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span></span></span></span></span></span></span></span></span></p><ul><li><strong>R平方</strong><br />Coefficient of Determination，也叫R Squared，翻译为拟合系数。其定义是，对于某个变量<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>y</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">y_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>有一系列观测值<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mi>y</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">y_i</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.625em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>（比如某个区域的100套房子价格），和对应的预测值<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msub><mover accent="true"><mi>y</mi><mo>^</mo></mover><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">\hat{y}_{i}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.8888799999999999em;vertical-align:-0.19444em;"></span><span class="mord"><span class="mord accent"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.19444em;">^</span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.19444em;"><span></span></span></span></span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>（比如根据房型和面积预测出的房子价格</li></ul><p><span class="katex-display"><span class="katex"><span class="katex-mathml"><math><semantics><mrow><msup><mi>R</mi><mn>2</mn></msup><mo>=</mo><mn>1</mn><mo>−</mo><mfrac><mrow><munder><mo>∑</mo><mi>i</mi></munder><msup><mrow><mo fence="true">(</mo><msub><mover accent="true"><mi>y</mi><mo>^</mo></mover><mi>i</mi></msub><mo>−</mo><msub><mi>y</mi><mi>i</mi></msub><mo fence="true">)</mo></mrow><mn>2</mn></msup></mrow><mrow><munder><mo>∑</mo><mi>i</mi></munder><msup><mrow><mo fence="true">(</mo><msub><mi>y</mi><mi>i</mi></msub><mo>−</mo><mover accent="true"><mi>y</mi><mo>ˉ</mo></mover><mo fence="true">)</mo></mrow><mn>2</mn></msup></mrow></mfrac></mrow><annotation encoding="application/x-tex">R^{2}=1-\frac{\sum_{i}\left(\hat{y}_{i}-y_{i}\right)^{2}}{\sum_{i}\left(y_{i}-\bar{y}\right)^{2}}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.8641079999999999em;vertical-align:0em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.00773em;">R</span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.8641079999999999em;"><span style="top:-3.113em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:0.72777em;vertical-align:-0.08333em;"></span><span class="mord">1</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">−</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:2.7874360000000005em;vertical-align:-1.143718em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:1.6437180000000002em;"><span style="top:-2.155992em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mop"><span class="mop op-symbol small-op" style="position:relative;top:-0.0000050000000000050004em;">∑</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.16195399999999993em;"><span style="top:-2.40029em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.29971000000000003em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">−</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mord accent"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.56778em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.19444em;">ˉ</span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.19444em;"><span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.954008em;"><span style="top:-3.2029em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span></span></span></span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.6897100000000003em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mop"><span class="mop op-symbol small-op" style="position:relative;top:-0.0000050000000000050004em;">∑</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.16195399999999993em;"><span style="top:-2.40029em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.29971000000000003em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="minner"><span class="minner"><span class="mopen delimcenter" style="top:0em;">(</span><span class="mord"><span class="mord accent"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.69444em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.19444em;">^</span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.19444em;"><span></span></span></span></span></span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">−</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.03588em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mclose delimcenter" style="top:0em;">)</span></span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.954008em;"><span style="top:-3.2029em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">2</span></span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:1.143718em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></span></p><p>其中， <span class="katex"><span class="katex-mathml"><math><semantics><mrow><mover accent="true"><mi>y</mi><mo>ˉ</mo></mover></mrow><annotation encoding="application/x-tex">\bar{y}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.7622199999999999em;vertical-align:-0.19444em;"></span><span class="mord accent"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.56778em;"><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.03588em;">y</span></span></span><span style="top:-3em;"><span class="pstrut" style="height:3em;"></span><span class="accent-body" style="left:-0.19444em;">ˉ</span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.19444em;"><span></span></span></span></span></span></span></span></span>是100套房子的平均价格。<br />R方的含义是，该预测模型解释了变量的方差的比例。方差衡量的是变量取值的分散程度或者波动范围，方差越小，说明变量值波动越小，换言之，变量的取值越容易被预测和猜中。假设R方=0.8，则说明拟合之后，变量的方差减小了80%，则变量的取值更容易被确定。比如，我们需要对房子进行估价，采用房型和面积对房子价格进行拟合之后，发现房屋价格的方差减小了80%，那么我们更容易得到房子价格的准确估计。</p><h2 id="特征设计和模型优化"><a class="markdownIt-Anchor" href="#特征设计和模型优化"></a> 特征设计和模型优化</h2><p><img src="https://static.v2grad.com/img/202112281305843.jpg" alt="特征设计和模型优化" /></p><p>特征工程是从现有数据中提取更多信息，以便提高模型的预测能力和学习速度的一门科学。在特征工程中，我们不会添加任何新的数据，而是让已有的数据发挥更大的作用。这一过程往往需要依靠数据领域的知识才能设计更有效的特征。</p><p><strong>特征抽取</strong>和<strong>特征选择</strong>是DimensionalityReduction（降维）的两种方法。</p><p><strong>维数灾难</strong>：当维数增大时，空间数据会变得更稀疏，这将导致bias和variance的增加，最后影响模型的预测效果。<br /><img src="https://static.v2grad.com/img/202112280738673.png" alt="维数灾难" /></p><h3 id="特征抽取"><a class="markdownIt-Anchor" href="#特征抽取"></a> 特征抽取</h3><p><strong>特征抽取</strong>:从现有特征中创建新特征来自动降低数据集中维数的过程，特征抽取后的新特征是原来特征的一个映射。<br />Feature Extraction: Creatting a subset of new features by combinations of the exsiting features</p><ul><li><strong>目的</strong>：减少特征数据集中的属性(或者称为特征)的数目，DimensionalityReduction（降维）</li><li><strong>手段</strong>：通过属性间的关系，如组合不同的属性得新的属性，这样就改变了原来的特征空间</li></ul><p><img src="https://static.v2grad.com/img/202112281042712.png" alt="特征抽取" /></p><h3 id="特征选择"><a class="markdownIt-Anchor" href="#特征选择"></a> 特征选择</h3><p><strong>特征选择</strong>:根据预测的重要性对现有属性进行排序，然后选择最相关的属性。特征选择后的特征是原来特征的一个子集。<br />Feature Selection: Choosing a subset of all the features(the ones more informative)</p><ul><li><strong>目的</strong>：减少特征数据集中的属性(或者称为特征)的数目，DimensionalityReduction（降维）</li><li><strong>手段</strong>：从原始特征数据集中选择出子集，是一种包含的关系，没有更改原始的特征空间。</li></ul><p><img src="https://static.v2grad.com/img/202112281044198.png" alt="特征选择" /></p><h3 id="特征创建和转换"><a class="markdownIt-Anchor" href="#特征创建和转换"></a> 特征创建和转换</h3><p>与特征提取和特征选择不同，特征创建和转换不是一个减少维数的方法，相反，<strong>特征创建和转换是从现有特征中生成新特征的过程。</strong></p><p>举个例子，假如我们将日期作为一个特征，其格式为两位数日期、两位数月份和两位数年份（日日-月月-年年），我们发现，将日期、月份和年份整合成一项特征对预测并没有太大帮助。相反，我们可以生成三项不同的特征，分别对应着日期，月份和年份，进而可能会发现其中某项特征和目标之间存在着有用的关系。</p><h4 id="数值数据"><a class="markdownIt-Anchor" href="#数值数据"></a> 数值数据</h4><ul><li>对数转换</li><li>平方或立方</li><li>分箱</li><li>缩放<ul><li>均值/方差标准化<span class="katex"><span class="katex-mathml"><math><semantics><mrow><msubsup><mi>x</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow><mo>∗</mo></msubsup><mo>=</mo><mfrac><mrow><msub><mi>x</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow></msub><mo>−</mo><msub><mi>μ</mi><mi>j</mi></msub></mrow><msub><mi>σ</mi><mi>j</mi></msub></mfrac></mrow><annotation encoding="application/x-tex">x_{i, j}^{*}=\frac{x_{i, j}-\mu_{j}}{\sigma_{j}}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1.0834679999999999em;vertical-align:-0.394772em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.688696em;"><span style="top:-2.441336em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="mpunct mtight">,</span><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span><span style="top:-3.063em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">∗</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.394772em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.457971em;vertical-align:-0.5423199999999999em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.915651em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.03588em;">σ</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:-0.03588em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.50732em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="mpunct mtight">,</span><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span><span class="mbin mtight">−</span><span class="mord mtight"><span class="mord mathdefault mtight">μ</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.5423199999999999em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li>最大最小缩放 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><msubsup><mi>x</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow><mo>∗</mo></msubsup><mo>=</mo><mfrac><mrow><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><mi>min</mi><mo>⁡</mo><msub><mi>x</mi><mi>j</mi></msub></mrow><mrow><mi>max</mi><mo>⁡</mo><msub><mi>x</mi><mi>j</mi></msub><mo>−</mo><mi>min</mi><mo>⁡</mo><msub><mi>x</mi><mi>j</mi></msub></mrow></mfrac></mrow><annotation encoding="application/x-tex">x_{i, j}^{*}=\frac{x_{i}-\min x_{j}}{\max x_{j}-\min x_{j}}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1.0834679999999999em;vertical-align:-0.394772em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.688696em;"><span style="top:-2.441336em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="mpunct mtight">,</span><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span><span style="top:-3.063em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">∗</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.394772em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.517142em;vertical-align:-0.5423199999999999em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.9748220000000001em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mop mtight">max</span><span class="mspace mtight" style="margin-right:0.19516666666666668em;"></span><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span><span class="mbin mtight">−</span><span class="mop mtight">min</span><span class="mspace mtight" style="margin-right:0.19516666666666668em;"></span><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.50732em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span><span class="mbin mtight">−</span><span class="mop mtight">min</span><span class="mspace mtight" style="margin-right:0.19516666666666668em;"></span><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.5423199999999999em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li>最大绝对值缩放 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><msubsup><mi>x</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow><mo>∗</mo></msubsup><mo>=</mo><mfrac><msub><mi>x</mi><mrow><mi>i</mi><mo separator="true">,</mo><mi>j</mi></mrow></msub><mrow><mi>max</mi><mo>⁡</mo><mrow><mo fence="true">(</mo><mrow><mo fence="true">∣</mo><msub><mi>x</mi><mi>j</mi></msub><mo fence="true">∣</mo></mrow><mo fence="true">)</mo></mrow></mrow></mfrac></mrow><annotation encoding="application/x-tex">x_{i, j}^{*}=\frac{x_{i, j}}{\max \left(\left|x_{j}\right|\right)}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:1.0834679999999999em;vertical-align:-0.394772em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.688696em;"><span style="top:-2.441336em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="mpunct mtight">,</span><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span><span style="top:-3.063em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">∗</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.394772em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.351032em;vertical-align:-0.5423199999999999em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.808712em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mop mtight">max</span><span class="minner mtight"><span class="mopen mtight delimcenter" style="top:0em;"><span class="mtight">(</span></span><span class="minner mtight"><span class="mopen mtight delimcenter" style="top:0em;"><span class="mtight">∣</span></span><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span><span class="mclose mtight delimcenter" style="top:0em;"><span class="mtight">∣</span></span></span><span class="mclose mtight delimcenter" style="top:0em;"><span class="mtight">)</span></span></span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.50732em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span><span class="mpunct mtight">,</span><span class="mord mathdefault mtight" style="margin-right:0.05724em;">j</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.2818857142857143em;"><span></span></span></span></span></span></span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.5423199999999999em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li>稳健缩放 <span class="katex"><span class="katex-mathml"><math><semantics><mrow><msubsup><mi>x</mi><mi>i</mi><mo>∗</mo></msubsup><mo>=</mo><mfrac><mrow><msub><mi>x</mi><mi>i</mi></msub><mo>−</mo><msub><mi>Q</mi><mn>25</mn></msub><mo stretchy="false">(</mo><mi>x</mi><mo stretchy="false">)</mo></mrow><mrow><msub><mi>Q</mi><mn>75</mn></msub><mo stretchy="false">(</mo><mi>x</mi><mo stretchy="false">)</mo><mo>−</mo><msub><mi>Q</mi><mn>25</mn></msub><mo stretchy="false">(</mo><mi>x</mi><mo stretchy="false">)</mo></mrow></mfrac></mrow><annotation encoding="application/x-tex">x_{i}^{*}=\frac{x_{i}-Q_{25}(x)}{Q_{75}(x)-Q_{25}(x)}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.94736em;vertical-align:-0.258664em;"></span><span class="mord"><span class="mord mathdefault">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.688696em;"><span style="top:-2.441336em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span><span style="top:-3.063em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">∗</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.258664em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.53em;vertical-align:-0.52em;"></span><span class="mord"><span class="mopen nulldelimiter"></span><span class="mfrac"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:1.01em;"><span style="top:-2.655em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">Q</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31731428571428577em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mtight">7</span><span class="mord mtight">5</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span><span class="mopen mtight">(</span><span class="mord mathdefault mtight">x</span><span class="mclose mtight">)</span><span class="mbin mtight">−</span><span class="mord mtight"><span class="mord mathdefault mtight">Q</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31731428571428577em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mtight">2</span><span class="mord mtight">5</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span><span class="mopen mtight">(</span><span class="mord mathdefault mtight">x</span><span class="mclose mtight">)</span></span></span></span><span style="top:-3.23em;"><span class="pstrut" style="height:3em;"></span><span class="frac-line" style="border-bottom-width:0.04em;"></span></span><span style="top:-3.485em;"><span class="pstrut" style="height:3em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight"><span class="mord mathdefault mtight">x</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.3280857142857143em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span><span class="mbin mtight">−</span><span class="mord mtight"><span class="mord mathdefault mtight">Q</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31731428571428577em;"><span style="top:-2.357em;margin-left:0em;margin-right:0.07142857142857144em;"><span class="pstrut" style="height:2.5em;"></span><span class="sizing reset-size3 size1 mtight"><span class="mord mtight"><span class="mord mtight">2</span><span class="mord mtight">5</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.143em;"><span></span></span></span></span></span></span><span class="mopen mtight">(</span><span class="mord mathdefault mtight">x</span><span class="mclose mtight">)</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.52em;"><span></span></span></span></span></span><span class="mclose nulldelimiter"></span></span></span></span></span></li><li>归一化</li></ul></li></ul><h4 id="分类数据"><a class="markdownIt-Anchor" href="#分类数据"></a> 分类数据</h4><ul><li>顺序：分类区分顺序，将定序变量中不同分类定义相对差值。</li><li>名目：分类不区分顺序，采用独热码进行编码。</li></ul><h3 id="模型优化-超参优化"><a class="markdownIt-Anchor" href="#模型优化-超参优化"></a> 模型优化-超参优化</h3><h4 id="超参的三种类型"><a class="markdownIt-Anchor" href="#超参的三种类型"></a> 超参的三种类型</h4><p><img src="https://static.v2grad.com/img/202112281109739.png" alt="超参数的类型" /></p><ul><li><strong>模型超参数</strong>：可以帮助定义模型本身。例如,某些基于神经网络的模型需要我们在开始训练前先定义一个架构。这个架构会包含神经网络中特定数量的层,以及在其中使用的激活函数。以处理计算机视觉问题的神经网 络为例,我们需要定义架构的其他属性,例如筛选器大小、池化、步长和填充。</li><li><strong>优化器超参数</strong>：与模型如何根据数据来确定模式相关,用于神经网络模型。这种类型的超参数包含梯度下降和随机梯度下降等优化器。还可以包含Adam等使用动量的优化器,或者使用Xavier初始化或He初始化等方法将参数权重初始化的优化器。</li><li><strong>数据超参数</strong>：与数据本身的属性相关。这些属性包括定义不同的数据扩增方法(例如用于图像相关问题的裁剪或大小调整)的属性。这种参数一般在没有足够数 据或数据中没有足够变量时使用。</li></ul><h4 id="超参的优化类型"><a class="markdownIt-Anchor" href="#超参的优化类型"></a> 超参的优化类型</h4><ul><li>网格搜索（grid search）是超参数优化的传统方法，是对超参数组合的子集进行穷举搜索，找到表现最佳的超参数子集。</li><li>随机搜索（random search），是对超参数组合的子集简单地做固定次数的随机搜索，找到表现最佳的超参数子集。对于规模较大的参数空间，采用随机搜索往往效率更高。</li><li>贝叶斯优化(Bayesian Optimization) 与网格/随机搜索最大的不同，在于考虑了历史调参的信息，使得调参更有效率。（但在高维参数空间下，贝叶斯优化复杂度较高，效果会近似随机搜索。）<br /><img src="https://static.v2grad.com/img/202112281118708.png" alt="网格搜索和随机搜索" /><br /><img src="https://static.v2grad.com/img/202112281120191.png" alt="贝叶斯优化" /></li></ul><h2 id="模型部署"><a class="markdownIt-Anchor" href="#模型部署"></a> 模型部署</h2><p><img src="https://static.v2grad.com/img/202112281305005.jpg" alt="模型部署" /><br />模型部署指的是将模型及其资源集成到一个生产环境中，用于创建预测。</p><h3 id="生产环境基础设置"><a class="markdownIt-Anchor" href="#生产环境基础设置"></a> 生产环境基础设置</h3><p><img src="https://static.v2grad.com/img/202112281127053.png" alt="生产环境基础设施" /></p><h3 id="推理类型"><a class="markdownIt-Anchor" href="#推理类型"></a> 推理类型</h3><h4 id="批处理"><a class="markdownIt-Anchor" href="#批处理"></a> 批处理</h4><ul><li>模型在批量预测时可用</li><li>推理分批进行</li><li>数据集有多个行</li><li>作业完成后按计划获取结果</li></ul><h4 id="实时"><a class="markdownIt-Anchor" href="#实时"></a> 实时</h4><ul><li>模型始终可用</li><li>推理实时进行</li><li>对数据进行单次观察</li><li>用户交互时可实时获得结果</li></ul><h3 id="推理vs训练"><a class="markdownIt-Anchor" href="#推理vs训练"></a> 推理VS训练</h3><p>推理是使用经训练的模型进行推断或预测测试样本的阶段,它与训练一样,包括用于预测值的前向传递。与训练不同的是,它不包括用于计算误差和更新权重的反向传递。</p><table><thead><tr><th>推理</th><th>训练</th></tr></thead><tbody><tr><td>通常在单个输入上实时进行</td><td>需要高并行度和大规模批处理能力，以提高吞吐量</td></tr><tr><td>非计算/内存密集型</td><td>计算/内存密集型</td></tr><tr><td>集成到应用程序推展工作流程</td><td>独立，未集成到应用程序堆栈</td></tr><tr><td>在边缘和云中的不同设备上运行</td><td>在云中运行</td></tr><tr><td>持续运行</td><td>运行频率通常较低（只训练一次，不经常训练）</td></tr></tbody></table><h3 id="监控"><a class="markdownIt-Anchor" href="#监控"></a> 监控</h3><p>监控预测的性能并触发告警从而采取进一步的行动，它对模型的进化至关重要。<br />监控关键的特征变化也很重要。</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://www.aws.training/Details/InstructorLedTraining?id=89189">The Machine Learning Pipeline on AWS (Simplified Chinese)</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2021/12/28/ml-pipeline/</id>
    <link href="https://v2grad.com/2021/12/28/ml-pipeline/"/>
    <published>2021-12-27T16:00:00.000Z</published>
    <summary>本文梳理机器学习管道，从一个业务问题开始，分别讲解定义问题、数据收集和整合、预处理和可视化数据、模型训练和优化、模型评估和模型部署环节的主要工作和关键技术。</summary>
    <title>机器学习的建模流程和Pipeline搭建</title>
    <updated>2021-12-27T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="读书笔记" scheme="https://v2grad.com/categories/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="创业维艰" scheme="https://v2grad.com/tags/%E5%88%9B%E4%B8%9A%E7%BB%B4%E8%89%B0/"/>
    <category term="奇点系列" scheme="https://v2grad.com/tags/%E5%A5%87%E7%82%B9%E7%B3%BB%E5%88%97/"/>
    <content>
      <![CDATA[<p>本·霍洛维茨，硅谷顶级投资人，与网景之父马克·安德森联手合作18年，有着丰富的创业和管理经验。2009年创立风险投资公司A16Z，被外媒誉为“硅谷最牛的50个天使投资人”之一，先后在初期投资了Facebook、Twitter、Groupon、Skype，是诸多硅谷新贵的创业导师。扎克伯格认为霍洛维茨是“<strong>我们这些硅谷年轻企业家的管理导师</strong>”。</p><p>这本书是写给创业者的“<strong>极限生存指南</strong>”。霍洛维茨在书里讲述了他在创业路上经历的“九九八十一难”，把自己从这些生死大劫中学到的东西总结出来，告诉创业者该如何面对逆境。大多数创业书所说的都是如何做正确的事，不把事情搞砸，而本·霍洛维茨还会告诉你：<strong>当事情已经搞砸时，你该怎么办。</strong></p><p>这本书和《从0到1》、《联盟》、《支付战争》一起组成了<strong>奇点系列</strong>图书，这个系列的图书是关于互联网时代人才变革、商业哲学、创新与创业思想。每本书都是来势汹汹，不仅在国外引起读者的追捧，在中国的商界也已经有了非常好的口碑，在大众读者心目中也有了一定的认知度。</p><h2 id="企业家真正的难题"><a class="markdownIt-Anchor" href="#企业家真正的难题"></a> 企业家真正的难题</h2><p>每次我读到一本管理类或励志类书籍时，我总在想：“写得不错，可他们所说的还不是真正的难题。”对于一家企业来说，真正的难题并不是设置一个宏伟的、难以实现的、大胆的目标，而是你在没有实现宏伟目标之时不得不忍痛裁员的过程。真正的难题不是聘请出色的人才，而是这些“出色的人才”逐渐滋生一种优越感并开始提出过分的要求。真正的难题不是绘制一张组织结构图表，而是让大家在你刚设计好的组织结构内相互交流。真正的难题不是拥有伟大的梦想，而是你在半夜一身冷汗地惊醒时发现，梦想变成了一场噩梦。</p><p>前3章主要讲作者的一些亲身经历，4～8章主要讲作者的经验教训。</p><h2 id="第一章从革命者到风险资本家"><a class="markdownIt-Anchor" href="#第一章从革命者到风险资本家"></a> 第一章：从革命者到风险资本家</h2><p>讲述本·霍洛维茨早期的一些个人经历：</p><ul><li>SGI实习，喜欢上了现代计算机图形</li><li>毕业后被拉入伙，加入创业公司NetLabs</li><li>想找一份稳定的工作去了莲花公司（Lotus Development）</li><li>几个月以后加入了网景（Netscape），在里面待了很多年，跟微软PK</li><li>最后因为行业竞争，决定重新创建一家公司LoudCloud。</li></ul><p>美国前国务卿科林·鲍威尔说，<strong>领导力是一种能让别人追随你的能力，即使别人只是出于好奇。</strong></p><h2 id="第二章loudcloud沉浮录我会坚强活下去"><a class="markdownIt-Anchor" href="#第二章loudcloud沉浮录我会坚强活下去"></a> 第二章：LoudCloud沉浮录：我会坚强活下去</h2><p>应对2000年的互联网泡沫，决定让公司上市，后来又将公司卖给了EDS，但是还好保留下了Opsware的知识产权。</p><p><strong>我所面临的唯一选择是，要么生存，要么彻底毁灭。</strong></p><p><strong>你的一生都需要两类朋友：第一类是当你遇到好事时，你可以打电话与之分享喜悦的朋友。第二是当你身陷困境时，可以打电话与之分担、向其倾述的朋友。</strong></p><p>如果我任凭那些根本不了解具体情况的人对公司的发展大计指手画脚，那我就无药可救了。我需要的是信息和数据，而不是有关公司未来发展方向的任何建议。</p><h2 id="第三章转型opsware这一次跟着感觉走"><a class="markdownIt-Anchor" href="#第三章转型opsware这一次跟着感觉走"></a> 第三章：转型Opsware：这一次跟着感觉走</h2><p>最大的客户EDS认为Opsware没有达到预期目标，决定取消配置，终止合作，他们只争取到60天的完善时间，最终终于化险为夷。</p><p>每当大公司打算实施某一计划时，该计划总会落到某个人身上，而此人却也有可能延误整个计划。</p><p>产品策略的要义所在：研发好产品是创新者的职责，而不是客户的任务。</p><h2 id="第四章陷入绝境"><a class="markdownIt-Anchor" href="#第四章陷入绝境"></a> 第四章：陷入绝境</h2><p>创业公司的CEO不应该计算成功的概率。创建公司时，你必须坚信，任何问题都有一个解决办法。而你的任务就是找出解决办法，无论这一概率是十分之九，还是千分之一，你的任务始终不变。</p><p>人们总是问我：“当一名成功的CEO的秘诀是什么？”遗憾的是，根本没有秘诀。如果说存在这样一种技巧，那就是看其专心致志的能力和在无路可走时选择最佳路线的能力。<strong>与普通人相比，那些令你最想躲藏起来或干脆死掉的时刻，就是你作为一名CEO所要经历的不同于常人的东西。</strong></p><h3 id="创业的挣扎"><a class="markdownIt-Anchor" href="#创业的挣扎"></a> 创业的挣扎</h3><ul><li><strong>不要抗下所有责任</strong>。除了负有最大责任的人以外，没有人会把损失当回事，没有人比责任人更感同身受。当你无法分担所有负担时，你要将某些负担分担出去，找尽可能多的人来共同解决问题，即使这些问题事关企业的生死存亡。</li><li><strong>这不是国际跳棋，而是国际象棋</strong>。天无绝人之路，总有一步棋可走。</li><li><strong>只要坚持下去就有转机</strong></li><li><strong>不要过分苛责自己</strong></li></ul><h3 id="ceo必须实话实说"><a class="markdownIt-Anchor" href="#ceo必须实话实说"></a> CEO必须实话实说</h3><p>对公司出现的问题做透明化处理很重要，主要原因有三：</p><ul><li><strong>信任</strong>。没有了信任，沟通就会中断。随着公司的成长，沟通成了公司最大的挑战。如果员工完全信任CEO，沟通的效率就会大大提高。实话实说就是建立这种信任的关键。一名CEO在一段时间内拥有这种被信任的能力，往往是一家管理良好的公司和一家管理混乱的公司之间最大的差别。</li><li><strong>参与解决问题的人越多越好</strong>。让领域专家去解决对应的问题，一个人，无论多么出色，他都无法解决自己不了解的问题。</li><li><strong>健康的企业文化就像过去的路由信息协议：好事不出门，坏事传千里</strong></li></ul><h3 id="如何解雇员工"><a class="markdownIt-Anchor" href="#如何解雇员工"></a> 如何解雇员工</h3><ul><li><strong>保持头脑清晰</strong>：如果公司没能实现自己的财政计划，形势严重到了必须辞退那些不惜重金聘请而来的员工的地步，这对CEO而言，无疑是巨大的压力和沉重的负担。在这样的时刻，我们很难顾及未来，因为过去会将你压得毫无喘息之机，而这正是你必须要面对的。</li><li><strong>当机立断</strong>：一旦决定裁员，那么必须尽快执行。如果走漏消息，就会横生枝节，麻烦不断。</li><li><strong>对裁员的原因要有清晰的认识</strong>：告诉员工是因为公司没有实现自己的计划，并不是因为个人绩效的问题，所以传递给公司和被辞退人员的信息不应该是“裁员非常必要，我们要借此机会考核大家的工作绩效”，而是“公司经营不善，为了继续发展，我们不得不忍痛辞掉一些优秀的员工”。承认失败似乎没什么了不起，但请相信我，这实际上非常了不起。</li><li><strong>对管理人员进行培训</strong>：对管理人员的培训需遵循一条黄金法则：自己的员工要自己亲自辞退，不能将这项工作推卸给人力资源部门或某个更严厉的同事，更不能雇用一家外包公司来完成。<br />只要你清楚地认识到管理者必须亲自裁掉自己的员工，那么，接下来，他们就要为此做好充分的准备：<ul><li>1.向员工简要解释目前的局势，告诉员工这是公司经营不善所致，与个人表现无关。</li><li>2.向员工明确指出：员工人数过多，裁员不容商榷。</li><li>3.对公司计划提供的福利和补贴等所有相关细节都要做到了然于胸。</li></ul></li><li><strong>向公司全体人员发表讲话</strong>：CEO必须为管理者们解释裁员的合理性，如果这一点做得好，管理人员在裁员时就会更加容易。<strong>话是说给哪些留下来的人听的</strong>。</li><li><strong>一定要让大家看见你，你一定要在公司出现</strong></li></ul><h3 id="如何裁掉高管"><a class="markdownIt-Anchor" href="#如何裁掉高管"></a> 如何裁掉高管</h3><ul><li><strong>分析根本原因</strong>。不要以表现不佳等理由解雇高管，要搞清楚自己为什么给公司找错了人。</li><li><strong>告知董事会</strong>。三个目标：1.得到他们的支持和理解。2.获取他们的意见，让他们批准解雇补偿金区分方案。3.保护被解雇高管的声誉。</li><li><strong>为面谈做好准备</strong>。三个关键点：1.原因要清楚，2.说话要果断，3.确定解雇补偿金区分方案。</li><li><strong>准备向公司宣布消息</strong>。向公司宣布消息的正确顺序是：1.该高管的直接下属，因为他们所受影响最大；2.其他高管，因为他们需要就此事回答一些问题；3.公司其余员工。</li></ul><h3 id="给好朋友降职"><a class="markdownIt-Anchor" href="#给好朋友降职"></a> 给好朋友降职</h3><ul><li>说话要得体</li><li>承认现实</li><li>承认他的贡献</li></ul><h3 id="失败者的谎言"><a class="markdownIt-Anchor" href="#失败者的谎言"></a> 失败者的谎言</h3><p>他辞职了，不过我们本来就打算辞掉他，而且他的业绩评价也不合格。高科技公司往往将员工流失的原因归为三类：1.自己辞职。2.被炒鱿鱼。3.自己辞职，但因为公司本来也不想再要他，因此对公司不会造成影响。第三类人员的增长速度似乎比第一类人员快得多。</p><p>这些精明能干的CEO为什么不明确道出公司即将到来的命运？他们并不是在欺骗投资者，而是在欺骗自己。人，尤其是那些创建事物的人，只愿意听好消息。</p><h3 id="笨方法才最有效"><a class="markdownIt-Anchor" href="#笨方法才最有效"></a> 笨方法才最有效</h3><p>当竞争对手在产品上超过我们的时候，我们面临的不是市场问题，客户们一直都在购买，只是没有购买我们的产品而已，对我们来说，没有任何良策可以改变局面，我们必须研发一款更好的产品，除此之外，别无出路。</p><h3 id="没人会在意"><a class="markdownIt-Anchor" href="#没人会在意"></a> 没人会在意</h3><p>与其将所有的心思用来哀叹自己的痛苦，还不如努力去寻找一种看似不可能的出路，令自己摆脱目前的困境。不要花时间去懊悔过去，要将所有的时间花在自己可以做的事情上，因为说到底，没人会在意，只要好好经营公司就行了。</p><h2 id="第五章依次管理好人-产品和利润"><a class="markdownIt-Anchor" href="#第五章依次管理好人-产品和利润"></a> 第五章：依次管理好人、产品和利润</h2><p>三者之中，管理好人是最难的，管不好人，其他两项就无从谈起。</p><h3 id="知道我今天为什么来上班吗好公司与烂公司的区别"><a class="markdownIt-Anchor" href="#知道我今天为什么来上班吗好公司与烂公司的区别"></a> 知道我今天为什么来上班吗？好公司与烂公司的区别</h3><p>严格要求管理者的必要性：</p><ul><li><strong>生与死的差别</strong>。一切顺利之时，成为一家好公司并不难，但遇到困难时，公司的好坏可能就是生与死的差别。</li><li><strong>事情并非总是一帆风顺</strong>。在管理混乱的公司里，经济优势一旦消失，员工就会随之流失。在科技公司里，一旦员工流失，就会出现螺旋式循环：公司价值下跌，最优秀的员工流失，公司价值继续下跌，最优秀的员工继续流失。这种恶性循环很难逆转。</li><li><strong>成为一家好公司本身就是一个目标。</strong></li></ul><h3 id="创业公司为何要进行人员培训"><a class="markdownIt-Anchor" href="#创业公司为何要进行人员培训"></a> 创业公司为何要进行人员培训？</h3><p>为什么要进行人员培训？</p><ul><li><strong>生产力</strong>。除了面试环节的严格筛选，还需要关注新员工生产力的高低，而且培训是管理者可以开展的最有效的活动之一。</li><li><strong>绩效管理</strong>。对员工进行岗位培训时，管理者应该清晰明确地提出工作期望。不对人员进行培训，绩效管理就毫无基础，进而变得松散无序、前后矛盾。</li><li><strong>产品质量</strong>。随着公司的成功，会进行大量的招聘，新工程师进来没有进行培训的话，会导致用户体验不一致，各种性能问题，以及整体混乱。</li><li><strong>员工留任</strong>。人们辞职主要有两个原因：1.他们讨厌自己的管理者，2.学不到东西。这两个都可以通过培训直接解决。</li></ul><h3 id="可以从朋友公司挖人么"><a class="markdownIt-Anchor" href="#可以从朋友公司挖人么"></a> 可以从朋友公司挖人么？</h3><p>将那些规定未经CEO（或高级主管）同意，不得雇用其员工的公司名单列举出来。有了这项政策，在录用朋友的员工之前，你就可以给朋友最后一次机会，让其留住员工，或提出反对意见。</p><h3 id="大公司主管为何难以胜任小公司的工作"><a class="markdownIt-Anchor" href="#大公司主管为何难以胜任小公司的工作"></a> 大公司主管为何难以胜任小公司的工作？</h3><p>大公司主管和创业公司主管的差异：<br />在处理日常业务时，大公司的主管往往都是中断驱动式的，大部分工作都是“即将来临的工作”。相反，如果你是创业公司的一名主管，除非你自己找事，否则便无事可干。在公司创立初期，你每天必须做出8~10个新方案，否则公司就会停滞不前。</p><p>雇用大公司主管可能会出现的两种危险的不匹配情况：</p><ul><li><strong>节奏不匹配</strong>。这样的主管已经习惯于等待邮件到达，等待电话铃声响起，等待会议被安排得井井有条。在你的公司里，他会长时间处于等待状态。</li><li><strong>技能不匹配</strong>。管理大公司需要的技能和创建新公司大不相同。大公司需要的是复杂的决策制定、次序优先、机构设计、流程改进，以及部门交流。创建公司时，没有大公司的那些问题，更需要非常熟练地实施高质量的招聘流程，具备丰富的专业领域知识，懂得如何从零开始创造流程，把握新方向，制定新任务。</li></ul><p>筛选不匹配的情况，可以问的几个题目：</p><ul><li><strong>你上班的第一个月会干什么？</strong> – 注意哪些过分强调学习的回答。</li><li><strong>这份新工作和你目前的工作有什么不同？</strong>  – 挑选那些能意识到工作差异的应聘者。</li><li><strong>你为什么要加入一个小公司？</strong>  – 注意将获得股权作为首要动机的应聘者。</li></ul><p>积极帮助新人融入公司</p><ul><li>**促使他们积极创造。**定期给他们制定目标。</li><li><strong>确保他们明白自己的职责所在。</strong> 每天安排一次和新主管的会面，要求他们带着各种问题而来。</li><li><strong>把他们放入集体。</strong> 确保他们和同事以及公司中的重要人员进行接触和交流。</li></ul><h3 id="招聘主管在没有招聘经验的情况下怎样才能招到优秀的人才"><a class="markdownIt-Anchor" href="#招聘主管在没有招聘经验的情况下怎样才能招到优秀的人才"></a> 招聘主管：在没有招聘经验的情况下，怎样才能招到优秀的人才？</h3><ul><li><strong>知道自己想要什么</strong>。写下你想要的能力，以及你愿意忍受的缺点</li><li><strong>控制招聘流程</strong>1.设置检验招聘标准的问答题目，2.组成面试小组，3.私密调查与公开调查</li><li><strong>单独做决定</strong>。做决定是一份孤独的任务，但总得有人来做。</li></ul><h3 id="为什么实现了业绩目标却没有达到预期效果"><a class="markdownIt-Anchor" href="#为什么实现了业绩目标却没有达到预期效果"></a> 为什么实现了业绩目标，却没有达到预期效果？</h3><p>设置合理的业绩目标，才能达到最好的效果。</p><ul><li><strong>拉平曲棍球棒曲线：目标错误。</strong> 给团队下达一个不可能完成的任务会削弱其实力。我并没有削弱团队的实力，却打乱了团队的工作顺序。</li><li>**过于关注数字。**指标并没有描述出真正的目标，而员工们的注意力大都集中在这些指标上，忽略了其他目标，团队注意力发生了偏移。</li><li><strong>严格按数字进行管理就如同利用数字进行绘画</strong>。你想促成的事有些也许可以量化，有些则不可以。你不能只汇报量化目标，而忽视质化目标，因为质化目标才是最重要的目标。</li></ul><h3 id="管理债务"><a class="markdownIt-Anchor" href="#管理债务"></a> 管理债务</h3><p>管理债是类比于技术债的一个概念。创业公司中比较流行的三种管理债务形式：</p><ul><li><strong>一山藏二虎</strong>。想留两个员工最终留下的可能只是混乱。</li><li><strong>因某一员工得到了另一工作机会而对其补偿过度</strong>。这会引起其他员工的不满和效仿</li><li><strong>缺乏绩效管理机制或员工反馈机制</strong>。人们意识不到自己的缺点时，很少会对其加以改正。不对员工的行为做出反馈的最终代价是：公司业绩的系统性一塌糊涂。</li></ul><h3 id="有效的人力资源管理"><a class="markdownIt-Anchor" href="#有效的人力资源管理"></a> 有效的人力资源管理</h3><p>一个高质量的人力资源机构无法给你创造一个管理完善、企业文化成熟的公司，却可以告诉你，你和你的管理者何时没有尽到职责。<br />应该找哪种类型的人才来帮助自己全面、持续地了解自己管理团队的质量呢？</p><ul><li><strong>世界一流的流程设计师</strong>。必须精通流程设计</li><li><strong>真正的外交官</strong>。优秀的人力资源主管会真心实意地为管理者提供帮助，不会因为发现了问题而大肆表功。他们会直接找管理者解决问题，提高管理质量。如无必要，他们一般不会将问题上报给CEO。</li><li><strong>行业知识专家</strong>。薪酬、福利、最佳招募方法等变化极快，人力资源主管在行业之中必须建有深厚的关系网，对所有最新情况了如指掌。</li><li><strong>CEO信任的智慧顾问</strong>。CEO必须相信人力资源主管的思考和判断。<br />• <strong>感觉灵敏的人</strong></li></ul><h2 id="第六章关注眼前的麻烦"><a class="markdownIt-Anchor" href="#第六章关注眼前的麻烦"></a> 第六章：关注眼前的麻烦</h2><p>公司里面在抱怨说脏话的问题，只需要设置一个底线，就是不能用来人身攻击，自然就可以解决冲突。</p><h3 id="如何最大限度地减少办公室政治"><a class="markdownIt-Anchor" href="#如何最大限度地减少办公室政治"></a> 如何最大限度地减少办公室政治？</h3><ul><li>选拔员工时要衡量对方的野心有多大。</li><li>建立严格的流程来防范潜在的办公室政治，并认真执行。<ul><li>业绩评估与业绩奖励</li><li>机构设置和职权划分。</li><li>员工提拔。</li><li>当心道听途说。</li></ul></li></ul><h3 id="适度的野心"><a class="markdownIt-Anchor" href="#适度的野心"></a> 适度的野心</h3><p>以“团队”为出发点来考虑问题的人说话时很少使用“我”，哪怕是在谈论其个人成就。</p><h3 id="头衔与升迁"><a class="markdownIt-Anchor" href="#头衔与升迁"></a> 头衔与升迁</h3><p>对于一个高速发展的公司而言，清晰的机构划分极为重要。</p><p>没有一套缜密、严格的人员任用标准和升职体系，员工会陷入因不公而引发的无穷无尽的矛盾之中。只要你预防得当，大家就不会再纠缠于头衔的高低，只会一心争当明星员工。</p><h3 id="当天才员工变成超级混蛋"><a class="markdownIt-Anchor" href="#当天才员工变成超级混蛋"></a> 当天才员工变成超级混蛋</h3><p>一个公司是由集体的力量造就的，员工如果不能成为这个集体中值得信赖的力量，那么无论他的个人能力有多强，对于公司来说都是没有价值的。</p><h3 id="该不该招资深人士"><a class="markdownIt-Anchor" href="#该不该招资深人士"></a> 该不该招资深人士？</h3><p><strong>对这个岗位来说，你认为究竟是外围经验重要还是内部经验重要。</strong></p><ul><li>技术部经理更需要了解编码基础和技术团队的综合情况，而不是如何管理该部门。因此，作为CEO的你最好从公司内部选拔人才，而不必考虑从外围引进。</li><li>销售主管就必须了解目标客户的想法和需求，知道他们的文化取向，清楚销售人员聘用的标准和尺度，从而实现销售业绩的最大化。只了解本公司的产品和文化是远远不够的。</li></ul><h3 id="一对一沟通"><a class="markdownIt-Anchor" href="#一对一沟通"></a> “一对一”沟通</h3><p><strong>以员工为中心的会谈</strong>，不是以上司为中心。它不拘于形式，目的是解决迫在眉睫的问题、交流精彩绝伦的想法，或者倾诉郁结已久的焦虑。这些话题往往不适合通过工作报告、电子邮件或是其他非私人化的途径开展。”</p><h3 id="打造企业文化"><a class="markdownIt-Anchor" href="#打造企业文化"></a> 打造企业文化</h3><p>企业文化是关于如何设计一种工作方式，让全公司齐心协力。</p><p>推行适宜的企业文化有助于你在一些重要的领域取得长足的进展。</p><h3 id="控制公司规模的诀窍"><a class="markdownIt-Anchor" href="#控制公司规模的诀窍"></a> 控制公司规模的诀窍</h3><p>进行组织设计时需要遵循以下几个<strong>基本步骤</strong>：</p><ul><li>明确要交流的信息。</li><li>明确要决定的内容。</li><li>明确你的侧重点。</li><li>明确小组中谁说了算。</li><li>明确哪些方面你尚未完善。</li><li>制订预案以应对那些你尚未完善的问题。</li></ul><p>工作流程的意义就是保障信息的畅通，关于<strong>工作流程</strong>的几个建议：</p><ul><li>把“产出”放在第一位。</li><li>明确以何种方式衡量你是否实现了各个阶段的目标。</li><li>引入问责制。</li></ul><h3 id="能力预期谬论"><a class="markdownIt-Anchor" href="#能力预期谬论"></a> 能力预期谬论</h3><ul><li>在一定程度上，管理能力是后天掌握的一种技能，而不是天生具备的禀赋。</li><li>不能预先判断人们能否胜任将来的工作，这样子会阻碍别人的发展。</li><li>切勿操之过急换主管，你必须等公司发展到更大规模时再做决断。</li><li>腹背受敌的日子不好过</li></ul><h2 id="第七章前途未卜时怎么办"><a class="markdownIt-Anchor" href="#第七章前途未卜时怎么办"></a> 第七章：前途未卜时怎么办</h2><h3 id="最难掌握的ceo决胜技"><a class="markdownIt-Anchor" href="#最难掌握的ceo决胜技"></a> 最难掌握的CEO决胜技</h3><p>CEO最难做到的，就是对自己内心的控制。组织设计、流程设计、指标设置以及人员安排等都是相对简单的工作，对内在情绪的控制才是最艰难的</p><p><strong>安抚神经的良药</strong></p><ul><li>多交朋友</li><li>把想法写出来。</li><li>盯着路，别看墙。</li></ul><h3 id="胆怯与勇敢只一线之隔"><a class="markdownIt-Anchor" href="#胆怯与勇敢只一线之隔"></a> 胆怯与勇敢只一线之隔</h3><p>我的CEO生涯告诉我，在面临那些至关紧要的问题时，老天考验的是我的勇气，而不是我的智商。</p><p>你每做一次艰难而正确的决定，勇气就会增加一分。相反，你每做一次轻松却错误的决定，怯懦就会多出一分。作为CEO，你的公司是勇往直前还是畏首畏尾，完全取决于你的选择。</p><h3 id="一与二"><a class="markdownIt-Anchor" href="#一与二"></a> “一”与“二”</h3><ul><li><strong>“一”</strong>：习惯收集信息形成决策</li><li><strong>“二”</strong>：从操控流程中获得满足</li></ul><p>管理公司必需的两项核心技能：第一，目标明确，知道自己该做什么；第二，能带动全公司去实现这个目标。</p><h3 id="优秀领导者的特质"><a class="markdownIt-Anchor" href="#优秀领导者的特质"></a> 优秀领导者的特质</h3><ul><li><strong>勾画蓝图的能力</strong>。只要用心、努力，任何人都能在这方面取得进步。每一位CEO都有必要在这项才能上多用心思。</li><li><strong>让他人追随你的能力</strong>。“这个特质的“先天赋予性”最强”</li><li><strong>实现梦想与抱负的能力</strong>。</li></ul><h3 id="顺境中的ceo和逆境中的ceo"><a class="markdownIt-Anchor" href="#顺境中的ceo和逆境中的ceo"></a> 顺境中的CEO和逆境中的CEO</h3><p>顺境中的CEO沿着常规的路径向成功迈进，而逆境中的CEO则跳出常规来争取突围。</p><p>公司处于顺境时，领导者必须最大限度地拓展现有机会。因此，他们的管理策略是以推动全方位、多层面的创新与贡献为重心。相反，当公司身处逆境时，领导者拼尽全力也要一发命中目标。能否走出逆境完全取决于领导者能否有效地完成使命。</p><h3 id="ceo是后天磨炼出来的"><a class="markdownIt-Anchor" href="#ceo是后天磨炼出来的"></a> CEO是后天磨炼出来的</h3><p>CEO意味着要做许多有违本能的事，要想将这种有违常规的身体运动转化为自然而然的本能反应，大量的练习必不可少。</p><p>做CEO还需要有更广泛的技能，但要达到高级水平，获得天生就是CEO的感觉，你还要掌握这些后天的行事技巧。</p><h3 id="如何评估ceo"><a class="markdownIt-Anchor" href="#如何评估ceo"></a> 如何评估CEO？</h3><ul><li>CEO是否知道该做什么？优秀的CEO必须是远景和蓝图的保护者。会通过策略来收集必要信息并及时做出决策。</li><li>CEO是否能让公司按照他的意愿行事？公司有能力这样做，员工能够正常履行职责。</li><li>CEO是否能就既定的目标取得理想的结果？首先要确保目标的正确性。</li></ul><h2 id="第八章-企业家头条法则没有法则"><a class="markdownIt-Anchor" href="#第八章-企业家头条法则没有法则"></a> 第八章： 企业家头条法则：没有法则</h2><h3 id="解决问责与创意之间的矛盾"><a class="markdownIt-Anchor" href="#解决问责与创意之间的矛盾"></a> 解决问责与创意之间的矛盾</h3><p>平庸与杰出之间的差距往往就源于你的态度。</p><p>问责制需要考虑的方面：</p><ul><li><strong>努力程度</strong>。不尽最大努力，那就必须要受到处罚</li><li><strong>承诺</strong>。勇于承诺，兑现承诺。</li><li><strong>结果</strong>。考虑员工的资历、任务的难度、以及是否存在不必要的风险。</li></ul><h3 id="怪诞星期五管理策略"><a class="markdownIt-Anchor" href="#怪诞星期五管理策略"></a> “怪诞星期五”管理策略</h3><p>技术部门和客户部的主管调换工作岗位。</p><h3 id="如何打造一流的管理团队"><a class="markdownIt-Anchor" href="#如何打造一流的管理团队"></a> 如何打造一流的管理团队？</h3><p>没有一流的团队，就无法创建一流的公司。</p><p>世界上奉行两种评价标准，一是根据你的表现，二是根据你的身份。</p><h3 id="该不该转让公司"><a class="markdownIt-Anchor" href="#该不该转让公司"></a> 该不该转让公司</h3><p>如果公司在一个很大的市场中占领了先机，并且极有可能成为同行业中的顶尖者，那么就让公司继续独立运营下去。</p><h2 id="第九章-是结束也是开始"><a class="markdownIt-Anchor" href="#第九章-是结束也是开始"></a> 第九章 是结束，也是开始</h2><p>创业公司需要的网络：大型公司、管理人员、技术人员、媒体人员和分析师、投资方和收购方。</p>]]>
    </content>
    <id>https://v2grad.com/2021/12/21/reading-the-hard-thing-about-hard-things/</id>
    <link href="https://v2grad.com/2021/12/21/reading-the-hard-thing-about-hard-things/"/>
    <published>2021-12-20T16:00:00.000Z</published>
    <summary>作者是被扎克伯格认为是“硅谷年轻企业家的管理导师”的著名硅谷顶级投资人本·霍洛维茨，《创业维艰》是写给创业者的极限生存指南，前3章主要讲作者的一些亲身经历，让你看到的都是创业血泪史，后面的章节主要讲作者的经验教训，是创业者的避坑指南。</summary>
    <title>《创业维艰》读书笔记</title>
    <updated>2026-08-03T22:15:52.151Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="思维精进" scheme="https://v2grad.com/categories/thinking/"/>
    <category term="熵增定律" scheme="https://v2grad.com/tags/%E7%86%B5%E5%A2%9E%E5%AE%9A%E5%BE%8B/"/>
    <content>
      <![CDATA[<p><img src="https://static.v2grad.com/img/202112140927974.png" alt="生命以负熵为生" /><br />奥地利理论物理学家，量子力学的奠基人之一埃尔温•薛定谔在其名著《生命是什么》中说：人活着就是在对抗熵增定律，<strong>生命以负熵为生。</strong></p><p><img src="https://static.v2grad.com/img/202112140925456.png" alt="吴军老师三个公式" /><br />吴军老师说：如果地球毁灭了，一张名片上写下地球文明的全部精髓，他给出了三个公式：</p><ul><li><span class="katex"><span class="katex-mathml"><math><semantics><mrow><mn>1</mn><mo>+</mo><mn>1</mn><mo>=</mo><mn>2</mn></mrow><annotation encoding="application/x-tex">1+1=2</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.72777em;vertical-align:-0.08333em;"></span><span class="mord">1</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span><span class="mbin">+</span><span class="mspace" style="margin-right:0.2222222222222222em;"></span></span><span class="base"><span class="strut" style="height:0.64444em;vertical-align:0em;"></span><span class="mord">1</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:0.64444em;vertical-align:0em;"></span><span class="mord">2</span></span></span></span>（代表了数学文明）</li><li><span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi mathvariant="normal">E</mi><mo>=</mo><msup><mrow><mi mathvariant="normal">m</mi><mi mathvariant="normal">c</mi></mrow><mo>∧</mo></msup><mn>2</mn></mrow><annotation encoding="application/x-tex">\mathrm{E}=\mathrm{mc}^{\wedge} 2</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.68333em;vertical-align:0em;"></span><span class="mord"><span class="mord mathrm">E</span></span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:0.751892em;vertical-align:0em;"></span><span class="mord"><span class="mord"><span class="mord mathrm">m</span><span class="mord mathrm">c</span></span><span class="msupsub"><span class="vlist-t"><span class="vlist-r"><span class="vlist" style="height:0.751892em;"><span style="top:-3.063em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mtight">∧</span></span></span></span></span></span></span></span></span><span class="mord">2</span></span></span></span>（爱因斯坦的质能方程）</li><li><span class="katex"><span class="katex-mathml"><math><semantics><mrow><mi>S</mi><mo>=</mo><mo>−</mo><msub><mo>∑</mo><mi>i</mi></msub><msub><mi>P</mi><mi>i</mi></msub><mi>ln</mi><mo>⁡</mo><msub><mi>P</mi><mi>i</mi></msub></mrow><annotation encoding="application/x-tex">S=-\sum_{i} P_{i} \ln P_{i}</annotation></semantics></math></span><span class="katex-html" aria-hidden="true"><span class="base"><span class="strut" style="height:0.68333em;vertical-align:0em;"></span><span class="mord mathdefault" style="margin-right:0.05764em;">S</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span><span class="mrel">=</span><span class="mspace" style="margin-right:0.2777777777777778em;"></span></span><span class="base"><span class="strut" style="height:1.0497100000000001em;vertical-align:-0.29971000000000003em;"></span><span class="mord">−</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mop"><span class="mop op-symbol small-op" style="position:relative;top:-0.0000050000000000050004em;">∑</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.16195399999999993em;"><span style="top:-2.40029em;margin-left:0em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.29971000000000003em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.13889em;">P</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.13889em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mop">ln</span><span class="mspace" style="margin-right:0.16666666666666666em;"></span><span class="mord"><span class="mord mathdefault" style="margin-right:0.13889em;">P</span><span class="msupsub"><span class="vlist-t vlist-t2"><span class="vlist-r"><span class="vlist" style="height:0.31166399999999994em;"><span style="top:-2.5500000000000003em;margin-left:-0.13889em;margin-right:0.05em;"><span class="pstrut" style="height:2.7em;"></span><span class="sizing reset-size6 size3 mtight"><span class="mord mtight"><span class="mord mathdefault mtight">i</span></span></span></span></span><span class="vlist-s">​</span></span><span class="vlist-r"><span class="vlist" style="height:0.15em;"><span></span></span></span></span></span></span></span></span></span>(熵的定义)</li></ul><p>清华大学的科学史系主任吴国盛说：<strong>如果物理学只能留一条定律，我会留熵增定律。</strong></p><p>爱丁顿爵士也曾说：我认为，<strong>熵增原则是自然界所有定律中至高无上的</strong>。如果有人指出你的宇宙理论与麦克斯韦方程不符，那么麦克斯韦方程可能有不对；如果你的宇宙理论与观测相矛盾，嗯，观测的人有时也会把事情搞错；但是如果你的理论违背了热力学第二定律，我就敢说你没有指望了，你的理论只有丢尽脸、垮台。</p><p>管理学大师彼得·德鲁克说：“<strong>管理要做的只有一件事情，就是如何对抗熵增</strong>。在这个过程中，企业的生命力才会增加，而不是默默走向死亡。”</p><p>在1998年亚马逊致股东信里，贝佐斯说：“<strong>我们要反抗熵（We want to fight entropy）。</strong>”</p><p>《少有人走的路》写到：“<strong>因为所有事物都向着无规律，向着无序和混乱发展，如果你要变得自律，你就得逆着熵增做功，这个过程会非常痛苦。</strong>”</p><p>这么多人都在谈论熵，说要反抗熵，然而到底什么是熵？</p><h2 id="什么是熵增定律"><a class="markdownIt-Anchor" href="#什么是熵增定律"></a> 什么是熵增定律</h2><h3 id="熵entropy"><a class="markdownIt-Anchor" href="#熵entropy"></a> 熵（Entropy）</h3><p>德国物理学家鲁道夫·克劳修斯首次提出熵的概念，用来表示任何一种能量在空间中分布的均匀程度，能量分布得越均匀，熵就越大。</p><p>熵其实并不神秘，和长度一样，是用来度量东西的。<strong>它是用来衡量无序，是不确定性的一种度量。</strong><br /><img src="https://static.v2grad.com/img/202112140930851.gif" alt="熵" /></p><p>简单易懂的解释：比如你去跟朋友商量，扔一个硬币，如果正面就去你喜欢的店吃饭，如果反面就去他喜欢的店吃饭。这时候你特别想去你喜欢的店，于是悄悄在硬币上做了手脚，让每次扔都是正面朝上。是不是去哪里吃饭这件事就是确定的，不随机的。这时候，熵是最小的。如果硬币是公平的，正反面出现可能性相同。这时候，去哪家吃饭这个事件不会偏向你们两个任何一方。熵是最大的。所以说，熵是对不确定程度的一种描述。</p><h3 id="熵增定律"><a class="markdownIt-Anchor" href="#熵增定律"></a> 熵增定律</h3><p>熵增定律，也叫热力学第二定律，克劳修斯对其的表述为：<strong>不可能把热量从低温物体传向高温物体而不引起其它变化</strong>。换种表述方法为：<strong>在孤立的系统里面，热量肯定是从高温流向低温，此过程是不可逆的</strong>。<br /><img src="https://static.v2grad.com/img/202112140931271.png" alt="熵增定律" /></p><p>一滴墨水滴在清水中，一段时间过后，墨水会扩散到整杯水中，这就是一个典型的熵增加过程。我们不会看到一杯水中的墨水自动汇聚，重新变成一滴墨滴，因为在自然情况下，熵不可逆。</p><p><img src="https://static.v2grad.com/img/202112090617694.png" alt="熵增定律" /><br />墨水分子会不断地随机运动，每个墨水分子会走到哪里，处在什么位置完全随机，这么一来，整体来看，最有可能发生的情况就是墨水分子平均的分布在整杯水中，这是从统计学来看概率最大的情况。不排除刚好所有分子都恰好走到了同一个地方，重新汇聚成了一滴，但是这种概率小到可以不计。</p><p><strong>熵增原理，指孤立热力学系统的熵不减少，总是增大或者不变。用来给出一个孤立系统的演化方向。</strong></p><h2 id="熵增的社会学意义"><a class="markdownIt-Anchor" href="#熵增的社会学意义"></a> 熵增的社会学意义</h2><p>有的人认为熵增定律揭示了宇宙演化的终极规律。这个规律包括我们所有生命和非生命的演化规律，生命里又包含着个人和群体的演化规律。</p><p><strong>熵或者熵增, 本身没有好坏之分, 它们只是一个客观概念。</strong></p><p>熵增意味着有效能量的丧失, 无序混沌、一潭死水状态的增多, 这自然不符合人类发展的需要, 因为人类发展的各个方面, 都意味着对势能的利用以及对规则和秩序的追求。所以，负熵代表着系统的活力，负熵越高就意味着系统越有序，这也是为什么薛定谔会说“生命以负熵为生”。</p><h3 id="生活中的熵增"><a class="markdownIt-Anchor" href="#生活中的熵增"></a> 生活中的熵增</h3><p><img src="https://static.v2grad.com/img/202112140926603.png" alt="熵增到熵减" /></p><ul><li>刚搬新房时，一切物件都井井有条，2年后一切都乱了。</li><li>刚毕业那会，一夏天衣服就2套，人活的很精神，现在衣柜里面满满当当的，很多衣服都已经穿不上了，弃之可惜、留之无用。</li><li>微信好友几十人时，很好经营和维护，几千人时，有一种很堵的感觉，无数小红点，无数群消息，无数朋友圈内容。</li><li>一个人生活很无忧无虑，二个人生活很快乐幸福，有小有老一大家子人生活时，出现了各种矛盾和隔阂。</li></ul><h3 id="生命的熵增演化过程"><a class="markdownIt-Anchor" href="#生命的熵增演化过程"></a> 生命的熵增演化过程</h3><p><img src="https://static.v2grad.com/img/202112140941541.png" alt="熵增" /></p><ul><li>个人生活中的各种坏习惯和不规律</li><li>公司越大组织越臃肿</li><li>国家越封闭越落后。</li></ul><h3 id="非生命的熵增演化过程"><a class="markdownIt-Anchor" href="#非生命的熵增演化过程"></a> 非生命的熵增演化过程</h3><ul><li>电脑手机会越来越卡</li><li>马路会越来越脏</li><li>交通会越来越堵</li><li>太阳会不断燃烧直至热寂。</li></ul><p>这些现象都有个共性：<strong>随着时间的推移，变的越来越混乱了。</strong></p><h2 id="如何对抗熵增-耗散结构"><a class="markdownIt-Anchor" href="#如何对抗熵增-耗散结构"></a> 如何对抗熵增 - 耗散结构</h2><p>既然知道了，这么一个最令人沮丧的定律，灭亡是改变不了的。那我们该如何对抗它呢？</p><p>对抗熵增的过程称作：反熵增、负熵、熵减。反熵增的本质就是为了系统有序。</p><p>想要对抗熵增，就要引入一个非常重要的理论：<strong>耗散结构</strong>。</p><p><img src="https://static.v2grad.com/img/202112130943921.png" alt="耗散结构" /></p><p>耗散结构是一个远离平衡态的非线性的开放系统（不管是物理的、化学的、生物的乃至社会的、经济的系统），通过不断地与外界交换物质和能量，在系统内部某个参量的变化达到一定的阈值时，通过涨落，系统可能发生突变即非平衡相变，由原来的混沌无序状态转变为一种在时间上、空间上或功能上的有序状态。</p><p>根据普里高津“耗散结构”原理可以总结归纳出，系统形成有序结构所需要的几个条件：</p><ul><li><strong>开放式系统</strong>。打破原来的封闭系统，才能使系统实现从无序变有序。系统把无用的熵排出去，然后吸收新的可用物质、能量和信息。</li><li><strong>远离平衡态</strong>。系统由于开放离开了平衡态，逐渐推向了非线性区，相互作用的非线性，才可能会涌现出新的有序结构。</li></ul><h2 id="企业对抗熵增"><a class="markdownIt-Anchor" href="#企业对抗熵增"></a> 企业对抗熵增</h2><p>“熵增”是不可逆的，对抗熵增是企业管理者们矢志不渝的挑战和追求<br /><img src="https://static.v2grad.com/img/202112140946192.png" alt="企业对抗熵增" /></p><h3 id="开放式系统"><a class="markdownIt-Anchor" href="#开放式系统"></a> 开放式系统</h3><p>企业要想对抗熵增，就必须开放，把那些衰败为熵的东西全部排出系统。比如腐败的制度、无产出的员工、落后的信息等等；然后吸收新鲜血液，比如先进的理念、新的人才、前沿信息等等。</p><ul><li>华为是一家伟大的企业，它为什么能发展的那么好，因为它的反熵增做的好。向外部市场开放，能自产的也外购，给行业保留利润。</li><li>华为每年淘汰干部10%，员工淘汰5%。每年18万人会淘汰5千人到9千人来激活这个团队。</li><li>从1997年开始，华为就开始持续引进来自外部的管理经验，包括IBM、埃森哲、波士顿咨询等。他们陆续给华为提供了多方面的变革，使华为在管理创新、组织机构创新、流程变革方面不断进步，奠定了华为成为一家全球化公司的根基。</li><li>亚马逊的「开放性」，则体现在贝佐斯把公司内部的业务，打造成一个商业化的对外的服务：有以用户为中心的Prime会员服务；有开放的Marketplace第三方卖家服务；有极具创新性可以长期产生收益的AWS云服务。一旦对外，它就要面对市场竞争，要不断打磨自己的服务，不断提高自己的核心竞争力。</li></ul><h3 id="远离平衡态"><a class="markdownIt-Anchor" href="#远离平衡态"></a> 远离平衡态</h3><p>企业做大了，企业内部就会形成一种非常稳固的结构，这种结构很可能就是官僚结构。企业想要推行新的理念，引进新的人才，吸收新的信息，都会非常困难。</p><ul><li>华为以奋斗者为本，换工号二次上岗，红蓝军机制</li><li>韩都衣舍，他们采取小团队模式，每个团队2-3人，包括设计师、页面制作专员、货品管理专员。员工自己可以自由选择任何团队，也可以自己组建团队。通过分成、授权、竞争、淘汰等一系列机制，来进行充分的内部流动。<strong>最后无能的员工（熵）被淘汰出局，剩下的精英继续流动、重组，变得更加强大。</strong></li><li>贝佐斯非常清楚“熵增”对一个企业组织的危害，所以他不断远离平衡感，不断把钱、把资源投入到新的领域，不断让企业进入到新的不稳定状态，最终让亚马逊创造出了重量级的云架构和云业务，而这就是”流动性”的力量。</li></ul><h2 id="个人对抗熵增"><a class="markdownIt-Anchor" href="#个人对抗熵增"></a> 个人对抗熵增</h2><p><img src="https://static.v2grad.com/img/202112140936716.png" alt="个人对抗熵增" /></p><h3 id="开放式系统-2"><a class="markdownIt-Anchor" href="#开放式系统-2"></a> 开放式系统</h3><p><strong>第一，用“成长型思维”代替“固定型思维”。</strong><br /><strong>固定型思维模式</strong>的人认为他们的才智和天赋是一成不变的，无力改变什么。这是一种相对消极的世界观。“我不擅长数学。”或“我一向不擅长与人相处，为什么还要尝试呢？”</p><p><strong>成长型思维模式</strong>的人认为通过付出和努力，自己的基础能力可以得到发展和提高，他们的信念是自己坐在驾驶员的位置，因此可以提高和改变。这种积极主动的世界观会带来积极主动的思维方法和语言。“我需要提高数学。”或者“我可以对我的伴侣更体贴。”</p><p><strong>第二，用“流量思维”代替“存量思维”。</strong><br /><strong>存量思维</strong>，眼里总是盯着我现在有什么，很多人一辈子省吃俭用，就是为了多攒点存量，而且总是守着这份存量，形成了故步自封的状态，之所以很多人很迷茫也是因为我们总是使用存量思维进行思考，有人迷茫是为什么，大部分情况在于他们觉得自己看不到希望，这种绝望的根源在哪里，他们觉得自己现在拥有的能力，工作，社会地位，资源没法让他们得到自己想要的东西，这就是一种典型的存量思维，他们觉得现在的一切在决定着他们现在的命运。</p><p><strong>流量思维</strong>，当同样面对现状的绝望时，流量思维的人想的不是存量，因为存量是现状，我们要想改变现状就要具备流量，做一个简单的类比，比如你是一个有很少水的水桶，你对于现状不满，你抱怨凭什么别人生下来就是水缸，装了满满的水，而我只是一个水桶，而且还这么一点水，这就是典型的存量思维，他们只会抱怨命运的不公平，尤其是看到别人不用努力也比自己强很多的时候，但是流量思维的人，他们却可以转化这种现状，水不够，你可以去找水源啊，你可以使用水管把流量导给自己啊，所以富人不注重自己拥有什么，而是自己能创造什么，这也就是一种能力。</p><p><strong>第三，用“终身学习”代替“临时学习”</strong><br />有人，每天都在学习，不论是多还是少。有人，偶尔学习一次，看一本书要用七八个月。前者，我称之为“终身学习者”，后者，我称之为“临时学习者”。学习对于前者如同呼吸一般，对于后者则如同救急的膏药，只在受到刺激或工作需要之时，才会想起。</p><p>对于“<strong>终身学习者</strong>”而言，他通过每天学习，将自己打造成了一个开放的系统，并且能够产生复利效应。</p><p>对于“<strong>临时学习者</strong>”而言，他是封闭的体系，无力对抗熵增，也无法产生复利效应。短期内自然看不出来，但是长期来看，二者却有天壤之别。</p><h3 id="远离平衡态-2"><a class="markdownIt-Anchor" href="#远离平衡态-2"></a> 远离平衡态</h3><p><strong>第一，走出舒适区</strong><br />美国人诺埃尔·蒂奇（Noel Tichy）把人的知识和技能层次划分为舒适区（comfort zone）、学习区（stretch zone）和恐慌区（panic zone）。对应已经熟练掌握的知识、有一定挑战性的知识和暂时无法学会的知识，来看看。</p><p><img src="https://static.v2grad.com/img/202112140902950.png" alt="走出舒适区" /><br />最里面一圈是“舒适区”， 对于你来说是没有学习难度的知识或者习以为常的事务，自己可以处于舒适心理状态。中间一圈“学习区”，对自己来说有一定挑战，因而感到不适，但是不至于太难受。最外面一圈“恐慌区”，是超出自己能力范围太多的事务或知识，心理感觉会严重不适，可能导致崩溃以致放弃学习。</p><p>对于一个人来说，最理想的状态是处于“学习区”，学习具有适当挑战性的东西， 一段时间后，“学习区”会慢慢变为“舒适区”， “舒适区”越变越大， 而一部分的“恐慌区” 也会相应变成“学习区”。</p><p><strong>第二，颠覆式成长</strong><br />个人成长遵循的是S型曲线，在刚开始的时候，会有非常漫长的平坦状态，而后则会如火箭般骤然升空，并最终在高位保持平稳。<br /><img src="https://static.v2grad.com/img/202112140907579.png" alt="颠覆式成长" /></p><p>想要远离平衡态也是如此，需要一次又一次的走在漫长的平路上，然后跃上巅峰，在好不容易跃上巅峰之后，又要开始第二条S型曲线，就这样，不断进行自我颠覆。</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://www.wxkol.com/item/f7b44505db1f4ef5.html">真正的高手，都有对抗“熵增”的底层思维</a></li><li><a href="https://zhuanlan.zhihu.com/p/72896309">熵增定律：为什么那么多人因此顿悟了</a></li><li><a href="http://www.ruanyifeng.com/blog/2013/04/entropy.html">熵的社会学意义</a></li><li><a href="https://baike.baidu.com/tashuo/browse/content?id=0cbc6fa2b707cc38f30e0436&amp;lemmaId=10127998&amp;fromLemmaModule=pcBottom&amp;lemmaTitle=%E7%86%B5%E5%A2%9E%E5%AE%9A%E5%BE%8B">人活着就是在对抗“熵增定律”</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2021/12/14/entropy-growing/</id>
    <link href="https://v2grad.com/2021/12/14/entropy-growing/"/>
    <published>2021-12-13T16:00:00.000Z</published>
    <summary>人活着就是在对抗熵增定律，生命以负熵为生。熵增定律的内涵以及生活中的现象，讲解借助于耗散结构，个人和企业如何对抗熵增。</summary>
    <title>打造耗散结构，对抗熵增定律</title>
    <updated>2026-11-13T09:01:05.227Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="读书笔记" scheme="https://v2grad.com/categories/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="读书笔记" scheme="https://v2grad.com/tags/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="理财" scheme="https://v2grad.com/tags/%E7%90%86%E8%B4%A2/"/>
    <content>
      <![CDATA[<p>读完了《小狗钱钱》1和2两部，这是一本很好的理财启蒙书。<br />第一部主要讲吉娅在小狗“钱钱”的指导下，一步步学会如何支配金钱，而不是受金钱支配；如何像富人那样思考，正确地认识和使用金钱；如何进行理财投资，找到积累资产的方法，早日实现财务自由！<br />第二部主要是讲吉娅去美国交流的一段冒险经历，让我们懂得比金钱更珍贵的是什么，发掘和培养孩子的优秀品格，品格才是孩子受用一生的精神财富。<br />第一部主要讲理财的<strong>技法</strong>，那么第二部书讲的就是<strong>心法</strong>，两部一起看，才能塑造人格健全、优秀卓越的人。</p><h2 id="正确的金钱观"><a class="markdownIt-Anchor" href="#正确的金钱观"></a> 正确的金钱观</h2><p>明确金钱对你的意义</p><h3 id="金钱是中性的"><a class="markdownIt-Anchor" href="#金钱是中性的"></a> 金钱是中性的</h3><p>要想过更幸福、更满意的生活，人就得改变自身。这和钱无关，金钱本身既不会使人幸福，也不会带来不幸。金钱是中性的，既不好，也不坏。只有当钱属于某一个人的时候，它才会对这个人产生好的影响或者坏的影响。钱可以被用于好的用途，也可以被用于坏的用途。一个幸福的人有了钱会更幸福；而一个悲观忧虑的人，钱越多，烦恼就越多。</p><h3 id="不要羞于谈钱"><a class="markdownIt-Anchor" href="#不要羞于谈钱"></a> 不要羞于谈钱</h3><p>吉娅的妈妈告诉她：“可是不应该随便跟别人开口谈钱。”，这是吉娅妈妈小时候家人拿来教育她的理念。但是小狗钱钱告诉吉娅，追求金钱是人与生俱来的权利，提及金钱，没有人对它会不感兴趣，许多人爱钱，但是将其挂在嘴边会羞于被嘲笑而深藏心底，也没有思考过金钱对自己究竟意味着什么。既然如此，不如打开天窗说亮话，把钱的问题算清了，彼此心里也就清净了。</p><p>所以，拥有正确金钱观的人，是那些能够把钱和感情分开的人。你会发现，坦然地和亲近的人谈钱，不仅不会伤感情，还会让彼此更亲密。</p><h3 id="认真对待金钱"><a class="markdownIt-Anchor" href="#认真对待金钱"></a> 认真对待金钱</h3><p>钱不是人生命中最重要的东西，不过当人们缺钱时，钱会成为生活中唯一谈论的事情。就像将要溺死的人，只想如何获救一样。其实，钱可以成为生活中一种令人愉快的力量。无论多大开始提高钱商，都不晚。</p><p>如果说我们平时，挣的钱够我们吃穿消费，那我们可能就会觉得这些金钱足矣，对我们来说确实也没那么重要。但是当我们的亲人躺在医院，而我们的银行卡余额，寥寥无几的时候；当自己意识到，就算把自己的全部身家都搭上，父母的全部养老金也都搭上，距离房子首付还遥不可及的时候，我们就会知道金钱到底有多重要了。</p><h2 id="如何赚钱"><a class="markdownIt-Anchor" href="#如何赚钱"></a> 如何赚钱</h2><h3 id="建立目标愿望清单"><a class="markdownIt-Anchor" href="#建立目标愿望清单"></a> 建立目标：愿望清单</h3><p>大多数人并不清楚自己想要的是什么，他们只知道，自己想得到更多的东西。你可以把自己的生活想象成一家很大的邮购公司。如果你给一家邮购公司写信说‘请给我寄一些好东西来’，你肯定什么都得不到。我们的愿望也是一样。我们必须确切地知道自己心里渴望的是什么才行。</p><p><strong>愿望清单</strong>：你自己必须真的有‘想要变得富有’这个愿望，所以你必须找到10个‘想要变得富有’的理由。</p><h3 id="坚持梦想梦想储蓄罐梦想相册"><a class="markdownIt-Anchor" href="#坚持梦想梦想储蓄罐梦想相册"></a> 坚持梦想：梦想储蓄罐+梦想相册</h3><p>建立<strong>梦想储蓄罐</strong>，从10个变富有原因中，找出3个（找到自己真正最想实现的，保持专注），为之储蓄、攒钱。</p><p><strong>梦想相册</strong>：把愿望做成影集，想象着自己成功的那一天，想象着自己实现理想的时刻。当你想像的时候，强烈的欲望就产生了。</p><h3 id="提升自信成功日记"><a class="markdownIt-Anchor" href="#提升自信成功日记"></a> 提升自信：成功日记</h3><p><strong>你是否能挣到钱，最关键的并不是你有没有好点子，也不是你有多聪明，而是你的自信程度。</strong></p><p><strong>成功日记</strong>：把所有做成功的事情记录进去。你最好每天都做这件事，每次都至少写五条你个人的成果。<br />“当你记成功日记的时候，你会对自身，对世界，还有对成功的规律做更深入的思考，你就会越来越多地了解自己和自己的愿望，这会使你有能力去理解别人。要彻底了解自己和世界上的所有秘密，是我们无法完全实现的一种理想。但我们可以一步一步地慢慢接近这个理想。”</p><h3 id="建立事业专注能掌控的"><a class="markdownIt-Anchor" href="#建立事业专注能掌控的"></a> 建立事业：专注能掌控的</h3><p>一个非常成功的商人总结赚钱的秘密：“<strong>第一，为别人解决一个难题，那么你就能赚到许多钱；第二，把精力集中在你知道的、能做的和拥有的东西上。</strong>”</p><p>一个叫达瑞的8岁男孩，他不会做的事情有很多。达瑞为父亲取报纸的时候，突然冒出了一个主意。当天他就挨个按响邻居的门铃，对他们说，只需每个月付给他1美元，他就负责每天早上把报纸塞到他们的房门底下。大多数人都同意了，达瑞很快有了70多个顾客。一个月后，当他第一次自己赚到了钱的时候，他高兴得简直快飞上了天。</p><blockquote><p>最好先找出自己喜欢做什么，再想想怎么通过它们来挣钱。</p></blockquote><p>吉娅受这个故事的启发，将自己平时喜欢做的事情和事业结合起来，他开始给邻居们遛狗，按次收费，然后还给狗教技能，按技能数收费。她将自己最大的爱好和事业结合起来，开启了自己的事业，大幅度提高了自己的收入。</p><p><strong>重要性和紧迫性之间有什么区别？如何保证在任何情况下都不偏离制订的目标？</strong><br />“这正是许多没有钱的人爱犯的错误。他们总是有那么多紧急的事情要做，以至于没有时间来关注重要的事情。”</p><ul><li>第一点，在遇到困难的时候，仍然要<strong>坚持自己的想法</strong>。一切正常的时候，每个人都能做到这一点。只有当真正的困难出现时才能见分晓。只有少数人能坚定不移地贯彻自己的计划。那些非常成功的人，甚至有能力在他们最困难的时候作出最杰出的表现。</li><li>第二点，在一切进展非常顺利的情况下，你也应该做这些事情。<strong>你每天应该在固定的时间里，有规律地做这些事情。</strong></li><li>第三点：遵守<strong>72小时规定</strong>，当你决定做一件事情的时候，你必须在72小时之内完成，否则你很可能永远不会再做了。</li></ul><blockquote><p>你要每天不间断地去做对你的未来意义重大的事情。你为此花费的时间不会超过10分钟，但是就是这10分钟会让一切变得不同。</p></blockquote><h3 id="扩大事业给工作增值"><a class="markdownIt-Anchor" href="#扩大事业给工作增值"></a> 扩大事业：给工作增值</h3><p>吉娅的“生意”越做越大，她开始寻找一些帮手，把自己原定要做的事情交给小伙伴完成，然后把酬劳分一半给小伙伴们。</p><p>因为看起来自己并没有做什么，却依旧能拿到一半的酬劳，吉娅有些内疚，总觉得是自己占了便宜。</p><p>为此，吉娅的表哥对她说：<strong>工作本身往往最多只值得报酬的一半，另一半的价值来源于你的想法和实施这个想法的勇气。</strong></p><p>吉娅把这番理论告诉了小伙伴，劝告对方可以自己重新找一份工作，就能挣到更多的钱，可对方却觉得做好现在的工作就够了，而不想去开辟新工作。</p><h2 id="如何理财"><a class="markdownIt-Anchor" href="#如何理财"></a> 如何理财</h2><p>仅有较高的收入绝不可能解决我们的财务难题。</p><p>要想变得有钱，我们不能为钱工作，而要让钱为我们工作。</p><h3 id="量入为出"><a class="markdownIt-Anchor" href="#量入为出"></a> 量入为出</h3><p>从前，有一个农夫，他每天早上都会去鹅舍收鹅蛋。他的鹅又大又白，能下很多鹅蛋。每天他收完鹅蛋，就去集市上卖掉，换回食物和衣服。<br />一天早晨，一个农夫发现自家的鹅窝中有一只金灿灿的蛋。他把蛋带回家，惊喜地发现这是一个金蛋。<br />从此以后，农夫的鹅每天都下一个金蛋。他每天都把金蛋拿到集市上去卖，很快他就变得富有起来了。<br />慢慢地，农夫变得越来越贪心，他就想：要是我把鹅的肚子划开不就能得到很多的金蛋了。于是，他把鹅杀死了，但是，鹅肚子中什么也没有。<br />农夫再也得不到金蛋了，因为他把生金蛋的鹅杀死了。</p><h3 id="资金分配"><a class="markdownIt-Anchor" href="#资金分配"></a> 资金分配</h3><p>既然我们要让鹅下金蛋，那么第一条原则就是：只进不出。我们绝对不能杀了自己的鹅，反而要喂鹅，让它长大。所以我们要养成定期存入全鹅账户一定资金的习惯，而且，绝对不取出。</p><p>理财要遵循的541的分配原则——</p><ul><li>50% 用来养“鹅”，就像“鹅生金蛋”一样，储蓄下来用钱生钱；</li><li>40% 用来实现中短期的目标，存入梦想储蓄罐；</li><li>10%用于日常开销。</li></ul><h3 id="学会投资"><a class="markdownIt-Anchor" href="#学会投资"></a> 学会投资</h3><p>投资比大多数人想象的要容易的多，基本上只要注意三点就可以：</p><ul><li>把钱投资在安全的地方；</li><li>我的钱应该下很多金蛋；</li><li>我们的投资应该简单明白。</li></ul><p><strong>挑选基金</strong>时的注意事项：</p><ul><li>基金应该至少有10年历史。假如它在这么长时间内一直有丰厚的利润，那我们可以认为，未来它也会运作良好。</li><li>应该选择大型的跨国股票基金。这种基金在世界各地购买股票，以此分散风险，所以十分安全。</li><li>对基金的走势图进行比较。我们应该观察在过去10年间哪些基金的年终利润最好。</li></ul><p><strong>72定理</strong>：用 72 除以投资的年收益率的百分比，得出的数字就是这笔钱翻一倍所要的年数。它可以告诉我们，在一定通货膨胀率下，我们的钱在多长时间后会贬值一半。按72除以3%的通货膨胀率计算，得到24，就是说24年以后，你的钱只值现在的一半。</p><h2 id="甜甜圈原理"><a class="markdownIt-Anchor" href="#甜甜圈原理"></a> 甜甜圈原理</h2><p>甜甜圈是由外面的圆圈和里面的圆孔共同组成的。外面的圆圈就好比是金钱等一切可以用来消费的东西，而里面的圆孔则代表着人们无法一眼看到的人类的品格。</p><p>优秀的品格无法用外在的金钱来衡量，唯有具有优秀的品格的人，才会感到快乐和幸福。所以这是比看得见的成功更重要的东西。但也绝不能忽视外在的东西，否则内心也无法彰显出来。所以内在的优良品格和外在的东西一样重要。</p><h2 id="养成优秀品格的七条准则"><a class="markdownIt-Anchor" href="#养成优秀品格的七条准则"></a> 养成优秀品格的七条准则</h2><h3 id="友好亲和"><a class="markdownIt-Anchor" href="#友好亲和"></a> 友好亲和</h3><ul><li>我有一个强烈的愿望，希望其他人能够像我一样生活美好而幸福。</li><li>我不会伤害任何人。我克制自己，不介入任何争端。</li><li>我谦虚有礼，尊重他人。我并不是永远正确。</li></ul><h3 id="勇于承担"><a class="markdownIt-Anchor" href="#勇于承担"></a> 勇于承担</h3><ul><li>遇事我能自我抉择。我能自行判断对某种情况应该作何反应。</li><li>我不受不公平之事的影响，而是将注意力集中在我能做的事情、我知道的知识和我拥有的东西之上。</li><li>把责任推托给别人的同时，也把相应的权利转交给了对方。</li></ul><h3 id="善待他人"><a class="markdownIt-Anchor" href="#善待他人"></a> 善待他人</h3><ul><li>我只称赞他人。如果确实无法称赞他人，那就最好什么都不说。</li><li>我尽量不批评他人。如果不得不批评，也要用非常礼貌和友善的方式。</li><li>我将注意力集中在他人的优点和闪光点上。</li></ul><h3 id="帮助给予"><a class="markdownIt-Anchor" href="#帮助给予"></a> 帮助给予</h3><ul><li>我祝愿自己遇到过的所有人都能一切顺利。</li><li>我送给某人礼物，因为我想表达自己对他的好感。</li><li>最美好的事情莫过于帮助他人。我总是在想自己能够帮助谁，没有什么比这更令人快乐。</li></ul><h3 id="感恩之心"><a class="markdownIt-Anchor" href="#感恩之心"></a> 感恩之心</h3><ul><li>我总是心怀感恩，哪怕是对看似寻常的事情。</li><li>即便遇到了困难，我还是会关注值得感激的事物。</li><li>我对身边的人都充满感激之情，并非常享受和他们共度的美好时光。</li></ul><h3 id="勤学不辍"><a class="markdownIt-Anchor" href="#勤学不辍"></a> 勤学不辍</h3><ul><li>如果我骄傲自满，那无异于说自己不必再学任何东西了。因此我应该保持谦恭好学的态度。</li><li>我不仅要阅读好的书籍、写成功日记和知识笔记，还要尽可能多地向他人学习。</li><li>我不拿自己和别人比较，而是尽我所能做到最好。</li></ul><h3 id="值得信赖"><a class="markdownIt-Anchor" href="#值得信赖"></a> 值得信赖</h3><ul><li>我能否成功总是取决于自身培养出的习惯。</li><li>如果我是一个非常自律的人，我就能比那些虽有天赋但却懒惰散漫的人获得更多的成功。</li><li>我总是很守时。我信守对他人作出的承诺。</li></ul>]]>
    </content>
    <id>https://v2grad.com/2021/11/17/reading-puppy-money/</id>
    <link href="https://v2grad.com/2021/11/17/reading-puppy-money/"/>
    <published>2021-11-16T16:00:00.000Z</published>
    <summary>《小狗钱钱1+2》是一套非常好的儿童理财启蒙书，第一部主要讲吉娅在小狗“钱钱”的指导下，学会如何支配金钱、如何像富人那样思考、如何进行理财投资。第二部主要是讲吉娅去美国交流的一段冒险经历，让吉娅懂得比金钱更珍贵的是什么，发掘和培养了自己优秀的品格。第一部主要讲理财的技法，那么第二部书讲的就是心法，两部一起看，才能塑造人格健全、优秀卓越的人。</summary>
    <title>《小狗钱钱1+2》读书笔记</title>
    <updated>2021-11-20T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="机器学习" scheme="https://v2grad.com/categories/machinelearning/"/>
    <category term="预训练" scheme="https://v2grad.com/tags/%E9%A2%84%E8%AE%AD%E7%BB%83/"/>
    <category term="自然语言处理" scheme="https://v2grad.com/tags/%E8%87%AA%E7%84%B6%E8%AF%AD%E8%A8%80%E5%A4%84%E7%90%86/"/>
    <content>
      <![CDATA[<h2 id="预训练"><a class="markdownIt-Anchor" href="#预训练"></a> 预训练</h2><p>预训练(Pre-trained Models,PTMs)的实施过程跟<strong>迁移学习</strong>是一样的，一般是先在一个基础数据集上进行任务训练，生成一个基础网络，然后将学习到的特征重新进行微调或者迁移到另一个目标网络上，用来训练新目标任务。</p><p>预训练是在大量常规数据集上学习数据中的“<strong>共性</strong>”，然后在特定领域的少量标注数据学习“<strong>特性</strong>”，这样子模型只需要从“共性”出发，去学习特定任务的“特性”部分即可。</p><p><img src="https://static.v2grad.com/img/202112041107988.png" alt="预训练模型" /></p><p>这和小孩子读书一样，一开始语文、数学、化学都学，读书、网上游戏等，在脑子里积攒了很多。当他学习计算机时，实际上把他以前学到的所有知识都带进去了。如果他以前没上过中学，没上过小学，突然学计算机就不懂这里有什么道理。<strong>预训练模型就意味着把人类的语言知识，先学了一个东西，然后再代入到某个具体任务，就顺手了，就是这么一个简单的道理。</strong></p><h3 id="为什么需要预训练"><a class="markdownIt-Anchor" href="#为什么需要预训练"></a> 为什么需要预训练</h3><ul><li>预训练模型中的参数都是从大量数据中训练得来，比起在自己的数据集上从头开始训练参数，在预训练模型参数基础上继续训练的方式肯定要快一些。</li><li>预训练模型是通过海量数据训练得来，更好地学到了数据中的普遍特征，比起在自己的数据集上从头开始训练参数，使用预训练模型参数通常会有更好的泛化效果。</li></ul><h3 id="计算机视觉上的预训练"><a class="markdownIt-Anchor" href="#计算机视觉上的预训练"></a> 计算机视觉上的预训练</h3><p>预训练首先是在计算机视觉方向取得较好效果并实现大规模应用的，我们会在庞大的ImageNet语料库上预训练模型，然后针对不同的任务在较小的数据上进一步微调。这比随机初始化要好得多，因为模型学习了一般的图像特征，然后可以将其用于各种视觉任务。<br />ImageNet这个数据集，数据量足够大，而且分类齐全，不限定领域，具有很好的通用型，使用范式一般如下图所示：<br /><img src="https://static.v2grad.com/img/202111041801550.png" alt="ImageNet预训练" /></p><h3 id="自然语言处理上的预训练"><a class="markdownIt-Anchor" href="#自然语言处理上的预训练"></a> 自然语言处理上的预训练</h3><p>借鉴视觉领域的做法,自然语言处理领域开始尝试使用预训练技术实现迁移学习，但是预训练在自然语言处理领域大爆发会缓慢很多，主要是因为自然语言处理任务(除机器翻译)没有计算机视觉方面那么多的标注好的数据集，而且没有很好的特征提取器，直到最近几年几个关键技术的成熟，神经网络才开始全面引入到了自然语言理解。从大规模的语言数据到强有力的算力，加上深度学习，把整个自然语言带到一个新的阶段。</p><p>自然语言处理预训练在不同时期有不同的称谓，但是，<strong>本质是使用大量语料预测相应单词或词组，生成一个半成品用以训练后续任务</strong>。</p><p>自然语言处理任务可以分为以下3个模块:<strong>数据处理、文本表征和特定任务模型</strong>。其中，<strong>数据处理模块</strong>和<strong>特定任务模型模块</strong>需要根据具体任务的不同做相应设计，而<strong>文本表征模块</strong>则可以作为一个相对<strong>通用</strong>的模块来使用。类似于计算机视觉领域中基于ImageNet预训练模型的做法，自然语言处理领域也可以预训练一个通用的文本表征模块，这种通用的文本表征模块对于文本的迁移学习具有重要意义。</p><h3 id="发展历史"><a class="markdownIt-Anchor" href="#发展历史"></a> 发展历史</h3><p>自然语言处理的预训练方法属于<strong>自然语言的表示学习</strong>，自然语言表示学习的形成已经经过了长期的历史发展。</p><ul><li>1948年N-gram分布式模型被提出来，使用one-hot对单词进行编码，这是最初的语言模型，存在维度灾难和语义鸿沟等问题。</li><li>1986年出现了分布式语义表示，即用一个词的上下文来表示该词的词义，它在one-hot的基础上压缩了描述语料库的维度，从原先的V-dim降低为了自己设定的K值。当时通用的方案是基于向量空间模型（Vector Space Model，VSM）的<strong>词袋假说</strong>（Bag of Words Hypothesis），即一篇文档的词频（而不是词序）代表了文档的主题，我们可以构造一个term-document矩阵，提取行向量做为word的语义向量，或者提取列向量作为文档的主题向量，使用奇异值分解(SVD)的进行计算。</li><li>2003年经典的NNLM神经语言模型被提出，开始使用神经网络来进行语言建模。更早期百度 IDL（深度学习研究院）的徐伟在他2000年发表的文章《Can Artificial Neural Networks Learn Language Models?》中也有相似方向的探索。</li><li>2013年word2vec被提出并在NLP领域大获成功，它基于向量空间模型的<strong>分布假说</strong>（Distributional Hypothesis），即上下文环境相似的两个词有着相近的语义，构造一个word-context的矩阵，矩阵的列变成了context里的word，矩阵的元素也变成了一个context窗口里word的共现次数。Word Embedding是Word2Vec模型的中间产物，是在不断最小化损失函数时候，不断迭代更新生成的。</li><li>2018年出现了预训练语言模型。</li></ul><h3 id="传统的预训练技术-vs-神经网络预训练技术"><a class="markdownIt-Anchor" href="#传统的预训练技术-vs-神经网络预训练技术"></a> 传统的预训练技术 VS 神经网络预训练技术</h3><p><strong>传统的预训练技术</strong><br />传统预训练技术与模型耦合较为紧密，该技术与模型之间并没有明确的区分界限，为了方便阐述，将语料送入模型到生成词向量的这一过程称为传统预训练技术。<br /><img src="https://static.v2grad.com/img/202111120845409.png" alt="传统的预训练技术" /></p><p><strong>神经网络预训练技术</strong><br />神经网络预训练技术是在预训练阶段采用神经网络模型进行预训练的技术统称，由于预训练与后续任务耦合性不强，能单独成为一个模型，因此也称为预训练语言模型，这一称谓是区别于传统预训练技术的叫法。</p><p>神经网络自然语言处理的预训练发展经历从浅层的词嵌入到深层编码两个阶段，按照这两个主要的发展阶段，我们归纳出预训练的两大范式：「浅层词嵌入」和「上下文的词嵌入」。</p><ul><li><strong>第一代预训练旨在学习浅层词嵌入(Word Embeddings)</strong>。由于下游的任务不再需要这些模型的帮助，因此为了计算效率，它们通常采用浅层模型，如 Skip-Gram 和 GloVe。尽管这些经过预训练的嵌入向量也可以捕捉单词的语义，但它们却不受上下文限制，只是简单地学习「共现词频」。这样的方法明显无法理解更高层次的文本概念，如句法结构、语义角色、指代等等。</li><li><strong>第二代预训练专注于学习上下文的词嵌入(Contextual Embeddings)</strong>，如CoVe、ELMo、GPT以及BERT。它们会学习更合理的词表征，这些表征囊括了词的上下文信息，可以用于问答系统、机器翻译等后续任务。另一层面，这些模型还提出了各种语言任务来训练，以便支持更广泛的应用，因此它们也可以称为预训练语言模型。</li></ul><p>本文重点讲解基于<strong>神经网络</strong>模型在<strong>自然语言处理</strong>领域的<strong>预训练技术</strong>。</p><h2 id="关键技术"><a class="markdownIt-Anchor" href="#关键技术"></a> 关键技术</h2><h3 id="transfromer"><a class="markdownIt-Anchor" href="#transfromer"></a> Transfromer</h3><p>Google 2017年提出了Transformer模型，之后席卷了整个NLP领域，红极一时的BERT、GPT-2都采用了基于Transformer的架构，现在都用到CV领域了，用于目标检测和全景分割的DETR就是代表。Transfromer的特征提取能力显著强于以往常用的CNN和RNN，<strong>这可以让我们更快更好的在样本上学习知识</strong></p><p>Transformer之所以表现优异有以下几点原因：</p><ul><li>模型并行度高，使得训练时间大幅度降低。</li><li>可以直接捕获序列中的长距离依赖关系。</li><li>可以产生更具可解释性的模型。</li></ul><p>想详细了解Transfromer，可以参考我以前的文章<a href="https://v2grad.com/2021/09/18/transformer/">《Attention Is All You Need – Transformer》</a></p><h3 id="自监督学习"><a class="markdownIt-Anchor" href="#自监督学习"></a> 自监督学习</h3><p>自监督学习是无监督学习的一种特殊方式，这些自监督的方法的核心是一个叫做 “pretext task” 的框架，它允许我们使用数据本身来生成标签，并使用监督的方法来解决非监督的问题。NLP预训练模型，就是利用自监督学习实现的，可以看做是一种去噪自编码器denoising Auto-Encoder。<strong>这可以让我们在大规模无标注数据集上学习知识。</strong></p><p>在预训练模型中，最常用的自监督学习方法是自回归语言模型（AutoRegressive LM，AR）和自编码语言模型（AutoEncoder LM，AE）。 <strong>自回归语言模型</strong>根据上文内容预测下一个可能跟随的单词，就是常说的自左向右的语言模型任务，或者反过来也行，就是根据下文预测前面的单词。 <strong>自编码语言模型</strong>根据上下文内容预测随机Mask掉的一些单词。</p><h3 id="微调"><a class="markdownIt-Anchor" href="#微调"></a> 微调</h3><p>微调旨在利用其标注样本对预训练网络的参数进行调整，可以将预训练的模型结果在新的任务上利用起来。<br /><img src="https://static.v2grad.com/img/202111140618731.png" alt="微调" /></p><h2 id="第一代技术预训练技术word-embeddings"><a class="markdownIt-Anchor" href="#第一代技术预训练技术word-embeddings"></a> 第一代技术预训练技术：Word Embeddings</h2><h3 id="nnlm"><a class="markdownIt-Anchor" href="#nnlm"></a> NNLM</h3><p>神经网络语言模型(Neural Network Language Model，NNLM)是2003年蒙特利尔大学的Yoshua Bengio教授在《A Neural Probabilistic Language Model》中提出来的模型，这个模型第一次用神经网络来解决语言模型的问题，虽然在当时并没有得到太多的重视，却为后来深度学习在解决语言模型问题甚至很多别的nlp问题时奠定了坚实的基础，后人站在Yoshua Bengio的肩膀上，做出了更多的成就。<br /><img src="https://static.v2grad.com/img/202111101654276.png" alt="NNLM" /><br />模型一共三层，第一层是<strong>映射层</strong>，将n个单词映射为对应word embeddings的拼接，其实这一层就是MLP的输入层；第二层是<strong>隐藏层</strong>，激活函数用tanh；第三层是<strong>输出层</strong>，因为是语言模型，需要根据前n个单词预测下一个单词，所以是一个多分类器，用softmax。整个模型最大的计算量集中在最后一层上，因为一般来说词汇表都很大，需要计算每个单词的条件概率，是整个模型的计算瓶颈。</p><p><strong>评价</strong></p><ul><li>NNLM模型是第一次使用神经网络对语言建模</li><li>由于模型使用的是全连接神经网络，所以只能处理定长序列。</li><li>由于模型最后一层使用softmax进行计算，参数空间巨大，训练速度极慢。</li></ul><h3 id="word2vec"><a class="markdownIt-Anchor" href="#word2vec"></a> Word2Vec</h3><p>Word2Vec是从大量文本语料中以无监督的方式学习<strong>语义知识</strong>的一种模型，将单词从原先所属的空间<strong>映射</strong>到新的多维空间中，即把原先词所在空间嵌入(Embedding)到一个新的空间中去，用词向量的方式表征词的语义信息，通过一个嵌入空间使得语义上相似的单词在该空间内距离很近。</p><p>Word2Vec模型中，主要有Skip-Gram和CBOW两种模型，从直观上理解，Skip-Gram是给定input word来预测上下文。而CBOW是给定上下文，来预测input word。<br /><img src="https://static.v2grad.com/img/202111101903380.png" alt="CBOW&amp;Skip-Gram" /></p><p><strong>评价</strong></p><ul><li>优化了计算效率，特别是google同时开源了工具包，使得其在工业界能够大规模使用。</li><li>Word2vec并没有考虑到词序信息以及全局的统计信息等</li></ul><h3 id="glove"><a class="markdownIt-Anchor" href="#glove"></a> GloVe</h3><p>Glove(Global Vectors for Word Representation)是一种无监督的词嵌入方法，该模型用到了语料库的全局特征，即单词的共现频次矩阵，来学习词表征（word representation）。</p><p><strong>第一步统计共现矩阵</strong>：下面给出了三句话，假设这就是我们全部的语料。我们使用一个size=1的窗口，对每句话依次进行滑动，相当于只统计紧邻的词。这样就可以得到一个共现矩阵。共现矩阵的每一列，自然可以当做这个词的一个向量表示。这样的表示明显优于one-hot表示，因为它的每一维都有含义——共现次数，因此这样的向量表示可以求词语之间的相似度。<br /><img src="https://static.v2grad.com/img/202111111038802.png" alt="共现矩阵" /></p><p><strong>第二步训练词向量</strong>：共现矩阵维度是词汇量的大小，维度是很大的，并且也存在过于稀疏的问题，这里我们使用<strong>SVD矩阵分解</strong>来进降维。<br /><img src="https://static.v2grad.com/img/202111110902602.png" alt="SVD求解" /></p><p><strong>评价</strong></p><ul><li>利用词共现矩阵，词向量能够充分考虑到语料库的全局特征，直观上来说比Word2Vec更合理。</li><li>GloVe中的很多推导都是intuitive的，实际使用中，GloVe还是没有Word2vec来的广泛。</li></ul><h2 id="第二代技术预训练技术-contextual-embeddings"><a class="markdownIt-Anchor" href="#第二代技术预训练技术-contextual-embeddings"></a> 第二代技术预训练技术: Contextual Embeddings</h2><p>通过预训练得到高质量的词向量一直是具有挑战性的问题，主要有两方面的难点，一个是词本身具有的<strong>语法语义复杂</strong>属性，另一个是这些语法语义的复杂属性如何随着上下文语境产生变化，也就是<strong>一词多义性</strong>问题。传统的词向量方法例如word2vec、GloVe等都是训练完之后，每个词向量就固定下来，这样就无法解决一词多义的问题。接下来的模型就是基于解决这个问题展开的。</p><h3 id="elmo"><a class="markdownIt-Anchor" href="#elmo"></a> ELMo</h3><p>ELMo（Embeddings from Language Models）是由AI2提出，该模型不仅去学习<strong>单词特征</strong>，还有<strong>句法特征</strong>与<strong>语义特征</strong>。其通过在大型语料上预训练一个深度BiLSTM语言模型网络来获取词向量，也就是每次输入一句话，可以根据这句话的上下文语境获得每个词的向量，这样子就可以解决一词多义问题。</p><p><img src="https://static.v2grad.com/img/202111150545462.png" alt="ELMo" /></p><p>Elmo模型的<strong>本质思想</strong>是先用语言模型学习一个单词的 Word Embedding，此时无法区分一词多义问题。在实际使用Word Embedding的时候，单词已经具备特定的上下文，这时可以根据上下文单词的语义调整单词的 Word Embedding 表示，这样经过调整后的 Word Embedding 更能表达上下文信息，自然就解决了多义词问题。</p><p><strong>评价</strong></p><ul><li>在模型层面解决了一词多义的问题，最终得到的词向量能够随着上下文变化而变化。</li><li>LSTM抽取特征的能力远弱于Transformer</li><li>拼接方式双向融合特征融合能力偏弱。</li></ul><h3 id="gpt"><a class="markdownIt-Anchor" href="#gpt"></a> GPT</h3><p>GPT（Generative Pre-Training）模型用单向Transformer代替ELMo的LSTM来完成预训练任务，其将12个Transformer叠加起来。训练的过程较简单，将句子的n个词向量加上位置编码(positional encoding)后输入到 Transformer中 ，n个输出分别预测该位置的下一个词。</p><p>GPT的单向Transformer结构和GPT的模型结构，如图所示：<br /><img src="https://static.v2grad.com/img/202111150547484.png" alt="GPT" /></p><p><strong>评价</strong></p><ul><li>第一个结合 Transformer 架构（Decoder）和自监督预训练目标的模型</li><li>语言模型使用的是单向语言模型为目标任务。</li></ul><h3 id="bert"><a class="markdownIt-Anchor" href="#bert"></a> BERT</h3><p>BERT采用和GPT完全相同的两阶段模型，首先是语言模型预训练，其次是后续任务的拟合训练。和GPT最主要不同在于预训练阶段采了类似ELMo的双向语言模型技术、MLM(mask language model)技术以及 NSP(next sentence prediction) 机制。</p><p><img src="https://static.v2grad.com/img/202111150548149.png" alt="BERT" /></p><p><strong>评价</strong></p><ul><li>采用了Transformer结构能够更好的捕捉全局信息。</li><li>采用双向语言模型，能够更好的利用了上下文的双向信息。</li><li>mask不适用于自编码模型，[Mask]的标记在训练阶段引入，但是微调阶段看不到。</li></ul><h2 id="延伸方向"><a class="markdownIt-Anchor" href="#延伸方向"></a> 延伸方向</h2><h3 id="研究方向"><a class="markdownIt-Anchor" href="#研究方向"></a> 研究方向</h3><p>预训练模型延伸出了很多新的研究方向。包括了：</p><ul><li>基于知识增强的预训练模型，Knowledge-enriched PTMs</li><li>跨语言或语言特定的预训练模型，multilingual or language-specific PTMs</li><li>多模态预训练模型，multi-modal PTMs</li><li>领域特定的预训练模型，domain-specific PTMs</li><li>压缩预训练模型，compressed PTMs<br /><img src="https://static.v2grad.com/img/202111150915051.png" alt="预训练的延伸方向" /><br />摘自《Pre-trained models for natural language processing: A survey》</li></ul><h3 id="模型衍生"><a class="markdownIt-Anchor" href="#模型衍生"></a> 模型衍生</h3><p><img src="https://static.v2grad.com/img/202111160553063.png" alt="模型衍生" /><br />摘自《Pre-Trained Models: Past, Present and Future》</p><h2 id="应用于下游任务"><a class="markdownIt-Anchor" href="#应用于下游任务"></a> 应用于下游任务</h2><h3 id="迁移学习"><a class="markdownIt-Anchor" href="#迁移学习"></a> 迁移学习</h3><p><img src="https://static.v2grad.com/img/202111150901877.png" alt="迁移学习" /></p><ul><li>不同的PTMs在相同的下游任务上有着不同的效果，这是因为PTMs有着不同的预训练任务，模型架构和语料。针对不同的下游任务需要<strong>选择合适的预训练任务、模型架构和语料库</strong>。</li><li>给定一个预训练的模型，不同的网络层捕获了不同的信息，基础的句法信息出现在浅层的网络中，高级的语义信息出现在更高的层级中。针对不通的任务需要<strong>选择合适的网络层</strong>。</li><li>主要有两种方式进行模型迁移：<strong>特征提取</strong>（预训练模型的参数是固定的）和<strong>模型微调</strong>（预训练模型的参数是经过微调的）。当采用特征提取时，预训练模型可以被看作是一个特征提取器，但以特征提取的方式需要更复杂的特定任务的架构。除此之外，我们应该采用内部层作为特征，因为他们通常是最适合迁移的特征。所以<strong>微调是一种更加通用和方便的处理下游任务的方式</strong>。</li></ul><h3 id="微调策略"><a class="markdownIt-Anchor" href="#微调策略"></a> 微调策略</h3><p>微调的过程通常是比较不好预估的，即使采用相同的超参数，不同的随机数种子也可能导致差异较大的结果。除了标准的微调外，如下为一些有用的微调策略：</p><ul><li>两步骤微调：两阶段的迁移，在预训练和微调之间引入了一个中间阶段。在第一个阶段，PTM 通过一个中间任务或语料转换为一个微调后的模型，在第二个阶段，再利用目标任务进行微调。</li><li>多任务微调：在多任务学习框架下对其进行微调。</li><li>利用额外模块进行微调：微调的主要缺点就是其参数的低效性。每个下游模型都有其自己微调好的参数，因此一个更好的解决方案是将一些微调好的适配模块注入到PTMs中，同时固定原始参数。</li></ul><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li><a href="https://mp.weixin.qq.com/s/kwKZfNSYTzc-PGKxTxm8-w">复旦大学最新《预训练语言模型》2020综述论文大全</a></li><li><a href="http://www.jsjkx.com/CN/article/openArticlePDF.jsp?id=18933">面向自然语言处理的预训练技术研究综述/李舟军</a></li><li><a href="https://www.zhihu.com/question/327642286/answer/1465037757">请问深度学习中预训练模型是指什么？如何得到？/ 微软亚洲研究院的回答 / 知乎</a></li><li><a href="https://www.jmlr.org/papers/volume3/bengio03a/bengio03a.pdf">A Neural Probabilistic Language Model/ Bengio</a></li><li><a href="https://zhuanlan.zhihu.com/p/21240807">A Neural Probabilistic Language Model/ paperweekly/ zhihu</a></li><li><a href="https://arxiv.org/pdf/1301.3781.pdf">Efficient Estimation of Word Representations in Vector Space / Tomas Mikolov</a></li><li><a href="https://nlp.stanford.edu/pubs/glove.pdf">GloVe: Global Vectors for Word Representation / Jeffrey Pennington</a></li><li><a href="https://v2grad.com/2021/09/18/transformer/">Attention Is All You Need – Transformer / zhanghao</a></li><li><a href="https://arxiv.org/pdf/1802.05365.pdf">Deep contextualized word representations</a></li><li><a href="https://s3-us-west-2.amazonaws.com/openai-assets/research-covers/language-unsupervised/language_understanding_paper.pdf">Improving Language Understanding by Generative Pre-Training</a></li><li><a href="https://arxiv.org/pdf/1810.04805.pdf">BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding</a></li><li><a href="https://arxiv.org/pdf/1906.08237.pdf">XLNet: Generalized Autoregressive Pretraining for Language Understanding</a></li><li><a href="https://arxiv.org/pdf/2003.08271.pdf">Pre-trained models for natural language processing: A survey</a></li><li><a href="https://arxiv.org/pdf/2106.07139.pdf">Pre-Trained Models: Past, Present and Future</a></li></ul>]]>
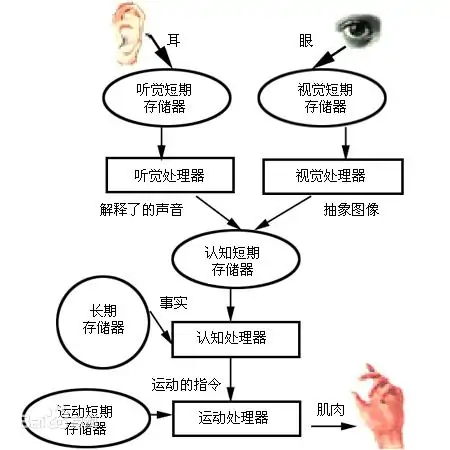
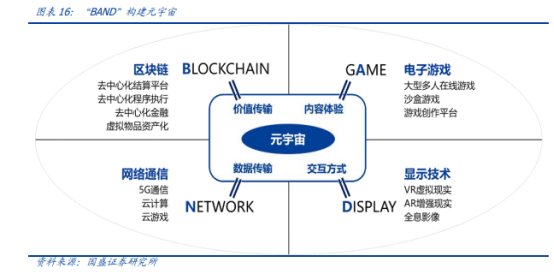
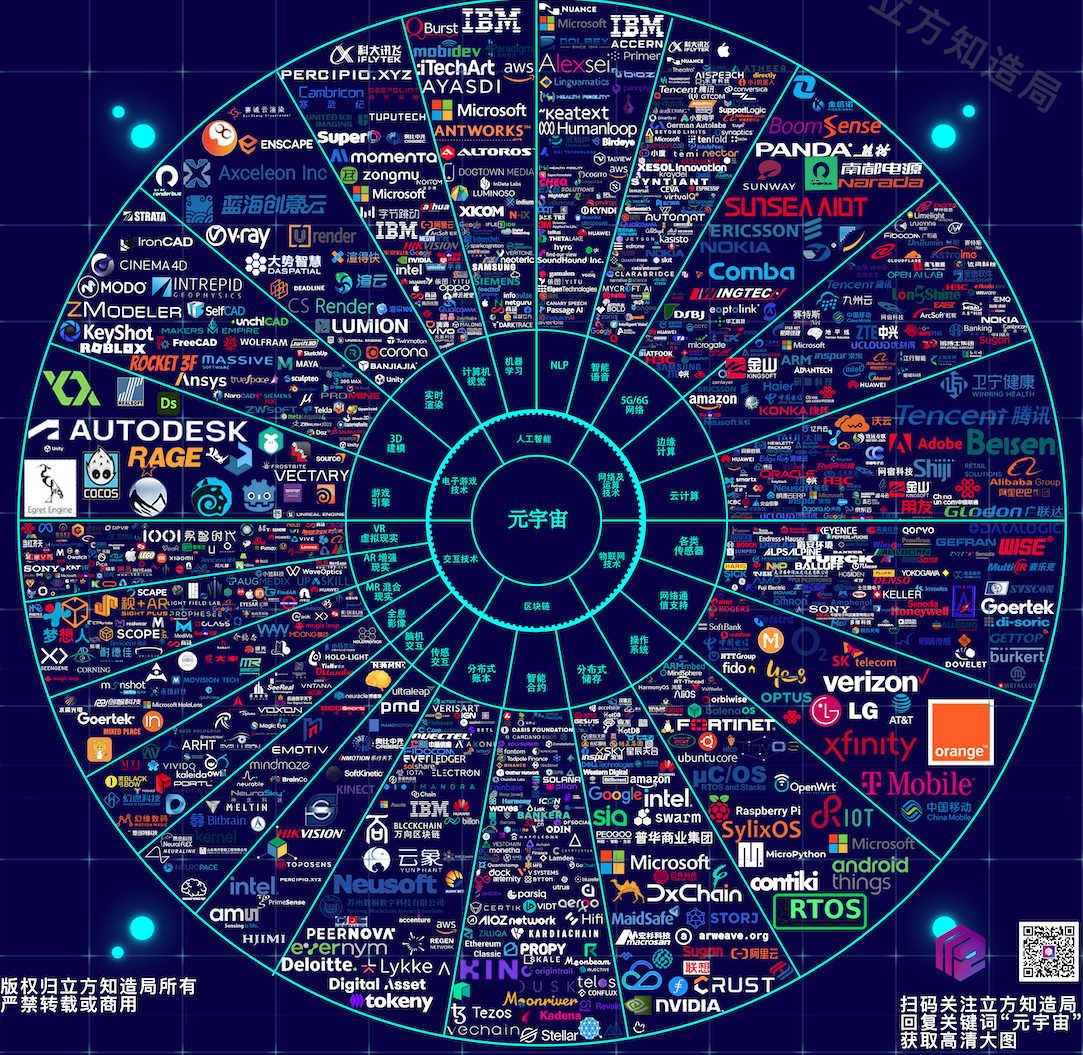
    </content>
    <id>https://v2grad.com/2021/11/15/ptms-pre-trained-models/</id>
    <link href="https://v2grad.com/2021/11/15/ptms-pre-trained-models/"/>
    <published>2021-11-14T16:00:00.000Z</published>
    <summary>本文梳理预训练技术的原理和发展脉络，着重讲解了几个具有代表性的模型，第一代的预训练模型：NNLM,word2vec,Glove，和第二代的预训练模型：ELMo,GPT,Bert。这是一个正在井喷的研究方向，简单描述了目前预训练技术的几个延伸方向以及应用到下游任务的方案。</summary>
    <title>自然语言处理预训练技术综述</title>
    <updated>2021-11-14T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="读书笔记" scheme="https://v2grad.com/categories/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <category term="读书笔记" scheme="https://v2grad.com/tags/%E8%AF%BB%E4%B9%A6%E7%AC%94%E8%AE%B0/"/>
    <content>
      <![CDATA[<h2 id="概述"><a class="markdownIt-Anchor" href="#概述"></a> 概述</h2><p>高效能人士的七个习惯是我司今年主推的一本提升公司学习力的工具书，公司也买了一些配套的课程给员工进行培训。我在读这本书的过程中，经常会有：“对对对，就应该是这样子”的感慨。作者史蒂芬•柯维是一个对生活有深入思考的人，他将世间各种行为模式和准则进行总结和提炼，找出其中最重要的点，梳理成我们行为的指导原则，因为只有原则是永恒的、普遍的、不言而喻的、具有实践性的，无论我们是否接受或理解。</p><p><img src="https://static.v2grad.com/img/202201071420780.png" alt="高效能人士的七个习惯思维导图" /></p><h3 id="由内而外全面造就自己"><a class="markdownIt-Anchor" href="#由内而外全面造就自己"></a> 由内而外全面造就自己</h3><p>你有这样子的问题？</p><ul><li>事业十分成功，却牺牲了个人生活和家庭生活。</li><li>很忙，但是自己也不清楚是否有价值。</li><li>要做的事情太多了，但是时间总是不够用。</li><li>看到别人有所成就，表面是挤出微笑，热切祝贺，可是内心难受的不得了。</li><li>工作上一些问题各执己见，互不相让，导致工作无法开展。</li><li>想要教育孩子懂得工作的价值，不管怎么努力，但是孩子还是不听话。</li><li>经常减肥，越减越肥</li></ul><p>==&gt; <strong>要改变现状，就要改变自己。要改变自己，首先要改变我们看外界的方式和习惯</strong></p><h3 id="效能是什么"><a class="markdownIt-Anchor" href="#效能是什么"></a> 效能是什么</h3><p><strong>效能就是产出和产能的平衡</strong>。<br />高效能人人士的七个习惯就是让更多人达到产出和产能的平衡，实现自己的人生价值。</p><p>伊索寓言中有一则关于鹅生金蛋的故事，足以说明这个常遭违背的原则。</p><blockquote><p>一个农夫无意间发现一只会生金蛋的鹅，不久便成了富翁。可是财富却使他变得贪婪急躁，每天一个金蛋已经无法满足他，于是他异想天开地把鹅杀了，想将鹅肚子里金蛋全部取出。谁知道打开一看，鹅肚子里并没有金蛋。最后鹅死了，再也生不出金蛋。<br />这则寓言中蕴含了一个自然法则，即效能的基本定义。许多人都用金蛋模式来看待效能，即产出越多，效能越高。</p></blockquote><p>而真正的效能应该包含两个要素：一是“<strong>产出</strong>”，即金蛋；二是“<strong>产能</strong>”——生产的资产或能力，即下金蛋的鹅。在生活中“重蛋轻鹅”的人，最终会连这个产金蛋的资产也保不住。反之，“重鹅轻蛋”的人，最后自己都可能会被活活饿死。所以，效能在于产出与产能的平衡。</p><p>如果从<strong>个人</strong>的角度去思考，金蛋就是自己的产出，鹅就是自己的产能，如果过度关注金蛋的产出（赚钱），忽视了身体健康和学习，最终可能得不偿失。</p><p>如果从<strong>企业</strong>的角度去思考，如果过度关注利润，忽视了员工的健康和学习，每周都是996，同样也会导致员工的离职。</p><h3 id="习惯是什么"><a class="markdownIt-Anchor" href="#习惯是什么"></a> 习惯是什么</h3><p><strong>习惯是知识、技巧和意愿相互交织的结果。</strong> 知识是理论范畴，指点“做什么”及“为何做”；技巧告知“如何做”；意愿促使“想要做”。要养成一种习惯，三者缺一不可。<br /><img src="https://static.v2grad.com/img/202111040927814.png" alt="习惯是什么" /></p><p>品德和个人魅力，哪个才是成功之本？</p><ul><li>品德: 如诚信、谦虚、勇气、公正、 耐心等——基于价值观的动机</li><li>个人魅力: 社会形象、行为态度、 人际关系的圆熟技巧和速成观念<br />=&gt; <strong>凭借由“习惯”合成的“品德” 所获得的成功是个人魅力成功无法企及的!</strong></li></ul><h3 id="人类成熟的三个时期"><a class="markdownIt-Anchor" href="#人类成熟的三个时期"></a> 人类成熟的三个时期</h3><p><strong>依赖期</strong>——以‘你’为核心，你照顾我；你得为我的得失成败负责。<br /><strong>独立期</strong>——以‘我’为核心，我可以做到；我可以负责；我可以靠自己；我有权选择。<br /><strong>互赖期</strong>——以‘我们’为核心，我们可以做到；我们可以合作；我们可以融合彼此的智慧和能力，共创前程。”<br />当我们开始“七个习惯”的学习，就代表要从依赖期转向独立期。走进独立期，很重要的一点，就是开始主动负责。<br /><img src="https://static.v2grad.com/img/202111040840687.png" alt="七个习惯" /></p><p><strong>七个习惯的原则</strong><br />习惯一：主动积极 （责任、选择、担当、主动、智慧）<br />习惯二：以终为始 （愿景、承诺、目的）<br />习惯三：要事第一 （专注、诚信、纪律、优先级）<br />习惯四：双赢思维 （互惠、公平、富足）<br />习惯五：知彼解己 （尊重、互相理解、同理心、勇气）<br />习惯六：统和综效 （创新、合作、多元化、谦逊）<br />习惯七：不断更新 （卓越、更新、持续改进、平衡）</p><h2 id="习惯一积极主动-个人愿景的原则"><a class="markdownIt-Anchor" href="#习惯一积极主动-个人愿景的原则"></a> 习惯一：积极主动 – 个人愿景的原则</h2><h3 id="刺激和回应之间选择的自由"><a class="markdownIt-Anchor" href="#刺激和回应之间选择的自由"></a> 刺激和回应之间选择的自由</h3><p>三种决定论：<strong>基因决定论</strong>——人的本性是祖先遗传下来的；<strong>心理决定论</strong>——人的本性是由父母的言行决定的；<strong>环境决定论</strong>——环境决定人的本性。三种决定论的基础是刺激—回应理论（我们会受条件左右，以某一特定方式回应某一特定刺激），忽视了人的自由意志。</p><p>在刺激与回应之间自由选择是人类最大的能力。人类特有<strong>四种天赋</strong>：</p><ul><li><strong>自我意识</strong>——我们能够检视自己的思维过程的能力；</li><li><strong>想象力</strong>——超越当前现实在头脑中进行创造的能力；</li><li><strong>良知</strong>——明辨是非，坚持行为原则，判断思想、言行正确与否的能力；</li><li><strong>独立意志</strong>——基于自我意识，不受外力影响而自行其是的能力。</li></ul><p><img src="https://static.v2grad.com/img/202111050601362.png" alt="积极主动模式" /></p><p><strong>消极被动的人被外界条件或情绪影响控制，而积极主动的人基于价值观和原则，有意识地选择待人接物的方式。</strong></p><h3 id="什么是积极主动的执行力"><a class="markdownIt-Anchor" href="#什么是积极主动的执行力"></a> 什么是积极主动的执行力</h3><p>有效利用资源，保质保量达成<strong>目标</strong>的能力。执行力指的是贯彻<strong>战略意图</strong>，完成预定目标的操作能力。是把企业战略、规划转化成为<strong>效益、成果</strong>的关键。</p><p>对个人而言执行力就是<strong>办事能力</strong>;对团队而言执行力就是<strong>战斗力</strong>;对企业而言执行力就是<strong>经营能力</strong>。</p><p>对个人而言是按时按质按量<strong>完成自己的工作任务</strong>;对企业而言就是在预定的时间内<strong>完成企业的战略目标</strong>。</p><h2 id="习惯二以终为始-自我领导的原则"><a class="markdownIt-Anchor" href="#习惯二以终为始-自我领导的原则"></a> 习惯二：以终为始 – 自我领导的原则</h2><p>“以终为始”，意思是说以期望得到的最终结果，倒推现在重点要聚焦什么。比如人生目标，不要被名利所蒙蔽，盖棺定论时，你希望获得的评价，才是你心中的真正渴望的目标。</p><h3 id="以终为始的原则基础"><a class="markdownIt-Anchor" href="#以终为始的原则基础"></a> 以终为始的原则基础</h3><p><strong>第一个原则是“任何事物都需要两次创造”</strong><br />任何事物都需经过两次创造，一次在头脑中，一次在实际中。这很好理解，比如我们建造一座花园，总是先脑中有了构思，再在笔下绘制蓝图付诸建造。人生也是一样。我们每个人的家庭背景、早年生活环境、早年受教育情况及外界限制构成了人生的第一次创造，可能很潦草，可能不尽如人意，但是今后的漫长一生，则取决于你就此顺流而下，还是主动设计第二次的创造。</p><p><strong>第二个原则是“自我领导”</strong><br />领导是第一次的创造，必须先于管理；管理是第二次的创造。领导与管理就好比思想与行为。管理关注基层，思考的是“怎样才能有效地把事情做好”； 领导关注高层，思考的是“我想成就的是什么事业”。用彼得·德鲁克（Peter Drucker）和华伦·贝尼斯（Warren Bennis）的话来说就是：“管理是正确地做事，领导则是做正确的事。”管理是有效地顺着成功的梯子往上爬，领导则判断这个梯子是否搭在了正确的墙上。</p><h3 id="以原则为中心"><a class="markdownIt-Anchor" href="#以原则为中心"></a> 以原则为中心</h3><p>以终为始是说人们应以原则为中心，指导、规划自己的人生，并始终牢记这座“灯塔”的位置，使自己不偏离航向。扮演好领导的角色，想清楚自己的个人使命、基本原则、方向、目标等之后，才能够做到以终为始。</p><p>个人、家庭、团队和组织在做任何事情时，均先拟出愿景和目标，并据此塑造未来。许多人的自我观念来自别人的看法、认知和思维，他们让环境和社会评价来决定自己的命运。操之在我的人设计自己的人生蓝本，并用来引导自己的未来。</p><h2 id="习惯三要事第一-自我管理的原则"><a class="markdownIt-Anchor" href="#习惯三要事第一-自我管理的原则"></a> 习惯三：要事第一 – 自我管理的原则</h2><p>要事第一是自我管理的原则，首先是要把大量的时间花在那些<strong>重要不紧急</strong>的事情上，因为只有这样紧急的事情才会不断减少。第二是要学会<strong>责任型授权</strong>，双方沟通好需要达成的结果，明确责任与奖惩，给予对方一些基于资源、陷阱而非具体事项的指导。</p><h3 id="时间管理四象限法则"><a class="markdownIt-Anchor" href="#时间管理四象限法则"></a> 时间管理四象限法则</h3><p>时间管理四象限法则是美国的管理学家科维提出的一个时间管理的理论，按处理顺序划分为：紧急又重要、重要不紧急、紧急不重要、不紧急不重要。<br /><img src="https://static.v2grad.com/img/202111050855169.png" alt="四象限法则" /></p><h3 id="授权"><a class="markdownIt-Anchor" href="#授权"></a> 授权</h3><p>授权是提高效率或效能的秘诀之一，确实有些事情自己做起来更省时省事，随着我们职位的上升，我们需要负责更多的事务，需要带领更多的员工，这些事务已经不是我们自己可以做完的了，而且我们有着更重要的事情去做，去领导这些事务的发展，为这些事情制定标准、指明方向。这时候，我们把这些事务授权给自己的下属完成，自己则专注于自己这个职位该做的事情，不仅是个人的成长，也是团队的成长。</p><p>授权基本上可以划分成两种类型：指令型授权和责任型授权<br /><strong>指令型授权</strong> – 指令型授权就是让别人“去做这个，去做那个，做完告诉我”。大部分生产者都具有这种指令型授权的行为模式。这种授权模式适合团队人数较少（个位数）的情况下，一个人总的负责这个事情，其他人则是他的帮手。</p><p><strong>责任型授权</strong> – 责任型授权的关注重点是最终的结果。它给人们自由，允许自行选择做事的方法，并为最终的结果负责。这种授权模式适合大团队（也就是团队人数比较多）的情况下，由一个人或者一个团队负责某一事务的进展。这种授权能够省去授权人非常多的时间，他们只要关注结果就好。</p><h2 id="习惯四双赢思维-人际领导的原则"><a class="markdownIt-Anchor" href="#习惯四双赢思维-人际领导的原则"></a> 习惯四：双赢思维 – 人际领导的原则</h2><p>双赢者把生活看作一个合作的舞台，而不是一个角斗场。双赢使得合作双方，都获取一定的利益，而不是此消彼长或者两败俱伤。</p><h3 id="人际交往的六种模式"><a class="markdownIt-Anchor" href="#人际交往的六种模式"></a> 人际交往的六种模式</h3><ul><li>利人利己(双赢)为自己谋利也不忘他人。</li><li>好聚好散(无交易)寻求双赢，接受分歧，“买卖不成仁义在”。</li><li>独善其身(赢)一心求胜，不顾他人，自我为中心</li><li>两败俱伤(输/输)总是嫉妒 或批判别人</li><li>损己利人(输/赢)委曲 求全，讨好他人。</li><li>损人利己(赢/输)攀比、竞争、追求地位、权力欲</li></ul><h3 id="双赢思维的五个要领"><a class="markdownIt-Anchor" href="#双赢思维的五个要领"></a> 双赢思维的五个要领</h3><ul><li>双赢品德 - 自信成熟知足</li><li>双赢关系 - 情感账户</li><li>双赢协议 - 合作协议</li><li>双赢体系 - 健全的组织结构</li><li>双赢过程 - 双赢的解决方案</li></ul><h2 id="习惯五知彼解己-移情沟通的原则"><a class="markdownIt-Anchor" href="#习惯五知彼解己-移情沟通的原则"></a> 习惯五：知彼解己 – 移情沟通的原则</h2><p>首先寻求去了解对方，然后再争取让对方了解自己。</p><h3 id="知彼-移情聆听"><a class="markdownIt-Anchor" href="#知彼-移情聆听"></a> 知彼 – 移情聆听</h3><p>“知彼”是交往模式的一大转变，因为我们通常把别人理解自己放在首位。</p><p><strong>人际沟通中的自传式回应(无效沟通)</strong><br />价值判断 - 对旁人的意见只有接受或不接受<br />追根究底 - 依自己的价值观探查别人的隐私<br />好为人师 - 以自己的经验提供忠告<br />自以为是 - 根据自己的行为与动机衡量别人的行为与动机</p><p><strong>有效沟通 – 移情聆听</strong><br />正确的沟通方式也就是移情聆听，至少包括四个阶段：</p><ul><li>第一阶段是复述语句，这至少能使人专心聆听。</li><li>第二阶段加入解释，完全用自己的词句表达，但仍用左脑的逻辑思维去理解。</li><li>第三阶段掺入个人的感觉，右脑发挥作用。此时听者所注意的已不止于言语，也开始体会对方的心情。</li><li>第四阶段是既加以解释，又带有感情，左右脑并用。</li></ul><p>人际沟通仅有10%通过语言来进行，30%取决于语调和声音，其余60%则得靠肢体语言，所以我们除了注意要说什么之外，还要关注肢体语言。</p><h3 id="解己-乔哈里视窗"><a class="markdownIt-Anchor" href="#解己-乔哈里视窗"></a> 解己 – 乔哈里视窗</h3><p><img src="https://static.v2grad.com/img/202111060846557.png" alt="乔哈里视窗" /></p><h2 id="习惯六统合综效-创造性合作的原则"><a class="markdownIt-Anchor" href="#习惯六统合综效-创造性合作的原则"></a> 习惯六：统合综效 – 创造性合作的原则</h2><p>尊重个体的差异，并且使得个体互相合作产生1+1＞2的效果。</p><h3 id="沟通的层次"><a class="markdownIt-Anchor" href="#沟通的层次"></a> 沟通的层次</h3><p><img src="https://static.v2grad.com/img/202111060852088.png" alt="沟通的层次" /></p><h3 id="案例"><a class="markdownIt-Anchor" href="#案例"></a> 案例</h3><p>为了理解沟通层次的意义，我们以一个案例来说明：老胡策划、准备了很久，想利用国庆假期带妻子和两个儿子去度假。妻子却想利用难得的假期去探望久病不愈的母亲。两人谁也无法说服对方。如果全家出游，妻子总是挂心母亲，全家都玩不痛快；如果去探望岳母，则老胡心中始终为准备许久的度假泡汤而闷闷不乐。即便调整一下，妻子独自去探望母亲，老胡带着孩子出游，则一家人也都玩不尽兴。他们最终想出了双赢的方案：去岳母家附近度假，或在节后请家务公司代劳一周，让妻子有空探望岳母。</p><p>这个案例就是典型的“第三选择”，遇到分歧，不要着急着妥协或对抗，要采取开放式沟通，并奉行双赢模式，相信有更好的可以互惠互利的第三选择。</p><h2 id="习惯七不断更新-平衡的自我更新的原则"><a class="markdownIt-Anchor" href="#习惯七不断更新-平衡的自我更新的原则"></a> 习惯七：不断更新 – 平衡的自我更新的原则</h2><p>不断更新是为了更好地消化和发展前六个习惯而持续进行的验证与升级，能够让人实现螺旋式上升。螺旋式的上升包括四个层面，分别是：智力、身体、社会、情感和精神。</p><ul><li>身体 - 通过正常适量的营养，运动，休息及压力管理来维持生理健康。</li><li>智力 - 通过阅读、写作，思考完成 确立 坚持 心智更新。</li><li>社会/情感 - 多做贡献，投资情感账户</li><li>精神 - 确立并坚持自己的哲学，思考解读世界的价值观<br /><img src="https://static.v2grad.com/img/202111060904303.png" alt="不断更新" /></li></ul>]]>
    </content>
    <id>https://v2grad.com/2021/11/03/reading-the-7-habits-of-highly-effective-people/</id>
    <link href="https://v2grad.com/2021/11/03/reading-the-7-habits-of-highly-effective-people/"/>
    <published>2021-11-02T16:00:00.000Z</published>
    <summary>高效能人士的七个习惯：主动积极,以终为始,要事第一,双赢思维,知彼解己,统和综效,不断更新。</summary>
    <title>《高效能人士的七个习惯》读书笔记</title>
    <updated>2022-01-06T16:00:00.000Z</updated>
  </entry>
  <entry>
    <author>
      <name>ZhangHao</name>
    </author>
    <category term="计算广告" scheme="https://v2grad.com/categories/%E8%AE%A1%E7%AE%97%E5%B9%BF%E5%91%8A/"/>
    <category term="计算广告" scheme="https://v2grad.com/tags/%E8%AE%A1%E7%AE%97%E5%B9%BF%E5%91%8A/"/>
    <category term="反作弊" scheme="https://v2grad.com/tags/%E5%8F%8D%E4%BD%9C%E5%BC%8A/"/>
    <category term="广告归因" scheme="https://v2grad.com/tags/%E5%B9%BF%E5%91%8A%E5%BD%92%E5%9B%A0/"/>
    <content>
      <![CDATA[<h2 id="广告归因方式"><a class="markdownIt-Anchor" href="#广告归因方式"></a> 广告归因方式</h2><p>要讨论广告作弊，就需要先了解广告的归因逻辑，作弊手段基本都是围绕广告归因的逻辑来进行的。<br />广告归因方案多种多样，我们这里主要讨论<strong>应用类广告、海外移动生态、第三方归因</strong>的方案。<br />海外移动广告生态，拥有比较成熟可信的第三方归因平台，比如Appflyer，Adjust以及Kochava等等。归因的核心逻辑是最后归因模型，即“Last Click”。</p><p><img src="https://static.v2grad.com/img/202110271433410.png" alt="应用广告归因" /><br />媒体的广告曝光后，若用户对广告进行了点击，媒体会将广告点击的媒体信息、用户设备信息（核心是IDFA/IMEI）、时间戳、网络状态等信息通过302跳转的方式给到第三方归因平台（即广告点击后，会通过302重定向跳转到第三方归因平台的后台，然后再跳到Google Play或者App Store）。此时，第三方归因平台其实是没有广告的曝光相关信息的。</p><p>应用激活后，可以通过接入归因SDK或者通过服务端对接的方式（S2S）的方式将应用相关信息回传给第三方归因平台，归因平台从数据库中找出匹配的媒体点击信息，通过匹配的应用包名、用户ID信息和广告的点击信息，按照最后一次点击的逻辑将应用的激活归因给对应的媒体和广告，完成一次归因的流程。</p><h2 id="作弊的分类"><a class="markdownIt-Anchor" href="#作弊的分类"></a> 作弊的分类</h2><p>在全部广告作弊类型中，作弊者能够伪造在归因中使用的任一或两类”信号”（Signal）。这两类信号分别为广告交互（例如查看或点击，对应归因方式中2的位置）和应用活动（例如安装、会话或事件，对应归因方式中3的位置）。在此基础上，我们将作弊分为伪造广告交互和伪造用户应用内活动。前者称为<strong>伪造归因（Spoofed Attribution）</strong>，后者被称为<strong>伪造用户（Spoofed Users）</strong>。<br /><img src="https://static.v2grad.com/img/202110271118560.png" alt="作弊分类" /></p><ul><li>类型1中的全部流量均为真实流量，即用户受到广告驱使，与应用所产生的真实互动。</li><li>类型2指伪造归因，即作弊者伪造真实用户的广告交互。其目的是为了窃取用户与应用之间的自然交互或通过真实广告所产生的效果。此类型的伪造也被称为“窃取归因”或“流量盗取”(poaching)。</li><li>类型3和4指伪造用户。此作弊类型专注于模拟用户的应用内活动行为。通过伪造不存在的用户而产生的应用安装和事件，作弊者可以窃取以应用转化为奖励的广告预算。“外挂”、“虚拟机器人”以及任何与“虚假用户”相关的手段都能归纳为此类型的作弊。</li></ul><h2 id="伪造归因"><a class="markdownIt-Anchor" href="#伪造归因"></a> 伪造归因</h2><p>伪造归因，也称Attribution Fraud、Spoofed Attribution、归因作弊、抢归因，是利用归因逻辑上的一些漏洞进行作弊的手段，通过发布虚假的曝光/点击，劫持真实用户产生的转化。</p><h3 id="点击欺诈click-spamming"><a class="markdownIt-Anchor" href="#点击欺诈click-spamming"></a> 点击欺诈(Click Spamming)</h3><p>点击欺诈，也叫Click Stuffing或Click Flood，中文名叫点击泛滥、点击填塞、大点击、预点击、撞库，是伪造海量广告的曝光或点击，等到用户真安装之后，在Last Click归因原则下，如点击后N天内安装的都算成带来点击的渠道，将其他渠道或者是自然量归因抢到自己的渠道中来。</p><p>欺诈性应用程序可能会在用户使用它时执行点击，或者在后台活动（例如启动、省电等）时执行点击。该应用程序甚至可以将展示次数报告为点击以呈现虚假的广告交互，而这一切都是在用户无意或不知情的情况下进行的。</p><p><img src="https://static.v2grad.com/img/202110271647119.png" alt="大点击" /></p><p><strong>点击欺诈的形式</strong>：</p><ul><li>广告堆叠点击(Ad Stacking Clicks)： 在单个广告展示位置中以层叠的方式放置多个广告，只有顶部广告可见。堆栈中的所有广告都按空间的每次展示或点击计费。欺诈者将多个广告投放到程序化广告活动中，并为未查看的广告创造收入。应用悄悄在后台加载和点击广告。<br /><img src="https://static.v2grad.com/img/202110271546938.png" alt="广告堆叠点击" /></li><li>浏览点击（Views as Clicks）或“预缓存”：以点击方式发送视图，在广告显示之前点击它们。将展示作为点击发送的渠道。</li><li>服务器到服务器的点击(Server2Server Clicks)：从Adx处获得流量直接给三方发送点击事件。<br />这些形式都具有一个相同的特征：用户实际上并没有打算与广告进行互动，也没有兴趣下载显示的应用程序。</li></ul><p><strong>依赖条件</strong></p><ul><li>丰富的广告资源，因为点击欺诈主要是盗取自然流量，所以需要一些自然下载量比较大的应用广告资源。</li><li>海量的设备和流量，找到活跃的设备。</li></ul><p><strong>识别方法</strong></p><ul><li>long CTIT(Click-to-install-time) distribution rates</li><li>low click-to-install conversion rates</li><li>high multi-touch contributor rates (or)<br /><img src="https://static.v2grad.com/img/202110271900778.png" alt="CTIT" /></li></ul><h3 id="点击劫持click-injection"><a class="markdownIt-Anchor" href="#点击劫持click-injection"></a> 点击劫持(Click Injection)</h3><p>点击劫持也叫Install Hijacking、点击注入、小点击，指的是作弊者通过安装在用户设备上的一个应用程序来“监听”其他应用程序的安装广播消息。当用户设备上安装了新的应用程序时，作弊者就会收到通知，然后在安装完成之前发送虚假点击利用归因模型的漏洞劫取相应的安装。特点是点击到安装时间过短，应用商店记录的下载时间早于点击广告的时间。<br /><img src="https://static.v2grad.com/img/202110271649228.png" alt="小点击" /></p><p>如果我们知道一个应用的下载或者安装时间点，在这个时候将“点击”信息发送给第三方归因平台，由于这个时候离应用的激活更近，按照Last Click原理归因概率就非常高。而Android系统刚好提供了获取应用安装的广播机制。当应用安装的时候，Android系统会将应用安装的消息（android.intent.action.PACKAGE_ADDED）通过系统广播（Broadcast）的方式广播给在已经在系统注册文件上（Manifest.xml）注册了安装广播监听能力的应用。获取到应用的安装信息（核心信息是应用的包名）之后，此时广告联盟SDK就会根据这个包名从广告后台中获取对应的广告信息，并将相关的用户设备信息，媒体信息通过“虚拟点击”的方式传到第三方归因平台。</p><p><strong>依赖条件</strong></p><ul><li>丰富的广告资源，因为广告信息是在收到系统应用安装广播之后，实时根据包名从广告后台请求拉取，然后才做的“模拟点击”信息发送。否则的话，你都不知道要给第三方归因平台发送什么样的广告点击信息。</li><li>注册系统的应用安装广告广播能力（或者知道Google play的下载事件）。这样才能知道应用什么时候被安装。同时联盟SDK的流量覆盖面要广，这样就可以抢到更多的广告。这个现象白热化的时候，有些小的广告联盟甚至只需要流量媒体接入他们的SDK而无需展示广告就可以获取收入。</li></ul><p><strong>识别方法</strong></p><ul><li>short CTIT(Click-to-install-time) distribution rates</li><li>high click-to-install conversion rates<br /><img src="https://static.v2grad.com/img/202110271901841.png" alt="CTIT" /></li></ul><p>根据安装的不同来源，我们的过滤方法稍有差异。</p><ul><li>Google play和华为:Google 和华为的 referrer API 会创建时间戳，这些时间戳可以用来甄别是否出现了点击劫持。首先，我们会将点击的时间与 intall_begin_time 做比对；如果点击发生在该时间戳后，基本可以肯定就是点击劫持。SDK还会收集install_finish_time时间戳，进行第二层过滤。</li><li>其他渠道的安装​:发生在 Google Play 应用商店和华为 AppGallery 之外的安装没有 referrer API，无法发送 install_begin 时间戳。因此，要过滤此类安装，我们要依赖于 install_finish_time 时间戳。 install_finish_time 时间戳后接收到的点击将被视为欺诈并被拒绝。</li></ul><h2 id="伪造用户"><a class="markdownIt-Anchor" href="#伪造用户"></a> 伪造用户</h2><p>伪造用户发生虚假应用内活动，我们能够发现模拟器、设备农场(Device Farms) 和 SDK 伪造。<br />在最初发现的伪造用户案例中，我们检测到欺诈者利用模拟器模仿云计算服务上真实用户使用安卓应用的情况。同时，我们还识别出东南亚国家的iOS设备农场，他们通过真实的设备和人员伪造了虚假的应用活动。</p><h3 id="模拟器bots"><a class="markdownIt-Anchor" href="#模拟器bots"></a> 模拟器(Bots)</h3><p>模拟器指的是作弊者通过自动化脚本或计算机程序模拟真实用户的点击、下载、安装甚至是应用内行为，伪装成为真实用户， 从而骗取广告主的CPI/CPA预算。<br /><img src="https://static.v2grad.com/img/202110271700101.png" alt="模拟器" /><br /><strong>特点</strong>是IP离散度密集、新设备率过高、用户行为异常、机型/系统/时间等分布异常等。</p><h3 id="设备农场device-farms"><a class="markdownIt-Anchor" href="#设备农场device-farms"></a> 设备农场(Device Farms)</h3><p>设备农场指的是作弊者购买大量真实设备进行广告点击、下载、安装和应用内行为，并通过修改设备广告跟踪符等方式隐藏设备信息。<br /><img src="https://static.v2grad.com/img/202110271913495.png" alt="设备农场" /></p><p>设备农场主使用各种策略来隐藏他们的活动，包括隐藏在新的IP地址后面，使用各种设备，同时启用限制广告跟踪或隐藏在 DeviceID重置欺诈后面（每次安装时重置他们的 DeviceID）。当大规模实施时，这种欺诈也称为DeviceID重置Marathons。<br /><img src="https://static.v2grad.com/img/202110271910424.png" alt="设备农场操作流程" /><br /><strong>特点</strong>是IP离散度密集、新设备率过高、用户行为异常、机型/系统分布异常等</p><h3 id="sdk伪造sdk-spoofing"><a class="markdownIt-Anchor" href="#sdk伪造sdk-spoofing"></a> SDK伪造(SDK Spoofing)</h3><p>SDK伪造是指作弊者通过执行“中间人攻击”破解第三方SDK的通信协议后，在没有任何实际安装的情况下，使用真实设备的数据来发送虚假的点击和安装，以此消耗广告主的预算的作弊行为。作弊者毁坏加密和哈希签名，进而引发了作弊者和研究人员之间的对决。</p><p><strong>特点</strong>是广告主后台数据和第三方数据不符。</p><h2 id="反作弊方法"><a class="markdownIt-Anchor" href="#反作弊方法"></a> 反作弊方法</h2><h3 id="匿名ip"><a class="markdownIt-Anchor" href="#匿名ip"></a> 匿名IP</h3><p>匿名IP过滤器可保护应用跟踪数据的真实性，使其免受来自VPN、Tor出口节点或数据中心的欺诈安装活动影响。一些欺诈者使用模拟软件伪造安装，并将欺诈转化放到高价值市场获取利润，匿名IP过滤器针对的就是这些欺诈者。</p><h3 id="点击安装时间"><a class="markdownIt-Anchor" href="#点击安装时间"></a> 点击安装时间</h3><p>点击安装时间(Click to install time,CTIT)衡量用户旅程中时间戳之间的伽玛分布 - 用户的初始广告互动和他们的首次应用启动。</p><p><img src="https://static.v2grad.com/img/202111201343440.png" alt="CTIT" /></p><p>CTIT 可用于识别基于点击的欺诈的不同案例:</p><ul><li>短 CTIT（低于 10 秒）：可能存在安装劫持欺诈(install hijacking)</li><li>长时间 CTIT（24 小时及之后）：可能的大点击欺诈(click flooding)</li></ul><h3 id="新设备率"><a class="markdownIt-Anchor" href="#新设备率"></a> 新设备率</h3><p>新设备率(New device rate, NDR)将突出显示下载广告商应用的新设备的百分比。</p><p>有新设备当然是正常的，因为会有新用户安装应用程序或者现有用户更换设备。但是，必须密切关注其活动可接受的新设备率，因为该比率由测量的新设备ID决定。因此，它可以被设备ID重置欺诈策略所操纵，这在设备农场中很常见。</p><p><img src="https://static.v2grad.com/img/202111201721503.png" alt="NDR" /></p><h3 id="传感器"><a class="markdownIt-Anchor" href="#传感器"></a> 传感器</h3><p>设备传感器(Device sensors)可以收集设备电池电量到倾斜角度等上百个指标，可以用来进行生物识别行为分析。</p><p><img src="https://static.v2grad.com/img/202111201354087.png" alt="传感器" /></p><p>这些指标有助于为每次安装创建配置文件——分析每次安装的设备和用户行为及其与真实用户测量的正常趋势的兼容性。</p><h3 id="限制广告跟踪"><a class="markdownIt-Anchor" href="#限制广告跟踪"></a> 限制广告跟踪</h3><p>限制广告跟踪（Limit ad tracking， LAT）是一项隐私功能，允许用户限制广告商收到的有关其设备生成的活动的数据。当用户启用LAT时，广告商及其测量解决方案会收到一个空白设备ID，而不是特定于设备的ID。</p><p>这个指标仅与Google和iOS广告标识符相关，亚马逊、小米等使用其他标识符。</p><h3 id="转化率"><a class="markdownIt-Anchor" href="#转化率"></a> 转化率</h3><p>转化率（Conversion rates）描述了一种操作到另一种操作的转化，这可能意味着广告展示转化为点击、点击转化为安装或安装给活跃用户。 广告商在用户旅程中的任何一点了解其预期转化率有助于防止欺诈渗透。</p><p>转化率过高可能不是真的，会被怀疑有作弊嫌疑。</p><h3 id="人工智能"><a class="markdownIt-Anchor" href="#人工智能"></a> 人工智能</h3><p>人工智能已成为常见的欺诈指标，因为它允许大规模应用欺诈识别逻辑。人工智能有助于指示人类无法追踪的任何规模的实例。</p><p>机器学习算法（即<strong>贝叶斯网络</strong>）与大型移动归因数据库相结合，将确保提供高效准确的欺诈检测解决方案。</p><h2 id="参考资料"><a class="markdownIt-Anchor" href="#参考资料"></a> 参考资料</h2><ul><li>[1]<a href="https://toutiao.io/posts/63t2w5v/preview">《深入分析广告归因》/ PMCoder</a></li><li>[2]<a href="https://mp.weixin.qq.com/s/1V8IwO-H9E1I1odxYnk_Ww">《Adjust CTO 深度剖析移动作弊: 打击作弊需从定义开始（一）》 / Paul Müller / CTO of Adjust</a></li><li>[3]<a href="https://fraudblocker.com/articles/what-is-ad-stacking">《What is Ad Stacking?》 / Fraud Blocker</a></li><li>[4]<a href="https://support.kochava.com/fraud-console/ad-stacking-clicks/">广告堆栈点击 / kochava support</a></li><li>[5]<a href="https://www.adjust.com/zh/blog/mobile-fraud-in-practice-three-real-world-examples-zh/">《移动广告作弊现形：三组实例的探讨与解决方案》 / Paul Müller / CTO of Adjust</a></li><li>[6]<a href="https://www.mobvista.com/wp-content/themes/mobvista/dist/global/files/white-book.pdf?62c0887b">《Mobvista 移动广告反作弊白皮书》</a></li><li>[7]<a href="https://www.appsflyer.com/glossary/click-flooding/">《Click flooding》 / appsflyer</a></li><li>[8]<a href="https://interceptd.com/how-ctit-click-to-install-time-is-used-to-detect-mobile-ad-fraud/">《How CTIT is Used to Detect Mobile Ad Fraud》 / interceptd</a></li><li>[9]<a href="https://www.appsflyer.com/glossary/sdk-spoofing/">《SDK spoofing》/ appsflyer</a></li><li>[10]<a href="https://www.appsflyer.com/resources/guides/mobile-ad-fraud-for-marketers/">mobile-ad-fraud-for-marketers/ appsflyer</a></li></ul>]]>
    </content>
    <id>https://v2grad.com/2021/11/01/computing-advertising-cpi-fraud/</id>
    <link href="https://v2grad.com/2021/11/01/computing-advertising-cpi-fraud/"/>
    <published>2021-10-31T16:00:00.000Z</published>
    <summary>介绍了应用类广告第三方归因的方法，详细分析了其中的作弊类型以及各种类型的具体作弊方法。</summary>
    <title>CPI/CPA广告常见作弊方法总结</title>
    <updated>2021-11-20T16:00:00.000Z</updated>
  </entry>
</feed>